


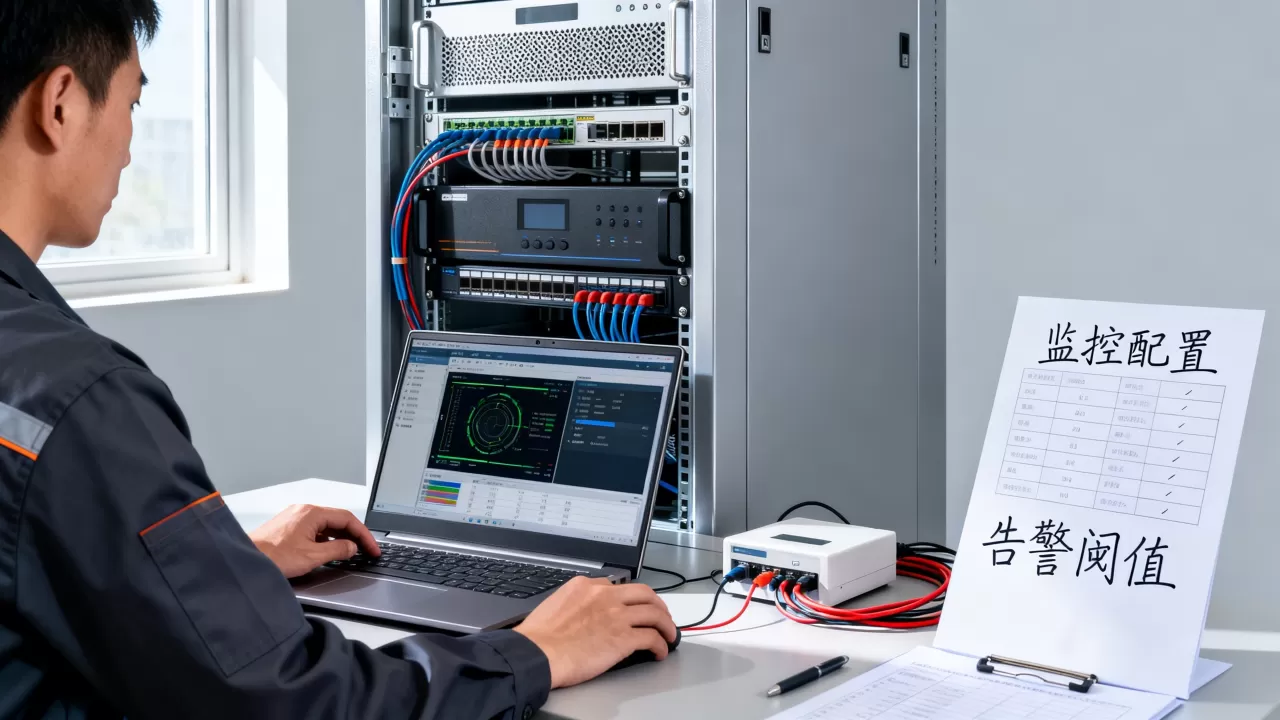
大模型部署监控告警配置的核心在于建立“指标采集-阈值判定-多渠道通知-自动恢复”的闭环体系,建议优先采用Prometheus+Grafana+Alertmanager技术栈,并针对Token消耗、响应延迟及显存占用设定分级告警策略。
随着大语言模型(LLM)从实验阶段走向企业级生产环境,单纯的“能跑通”已无法满足业务需求,运维团队面临的挑战不再是简单的服务器宕机,而是如何感知模型推理的“亚健康”状态,一个完善的监控告警系统,不仅要告诉你是“死”了,更要告诉你为什么“慢”了,以及未来可能“崩”在哪里。
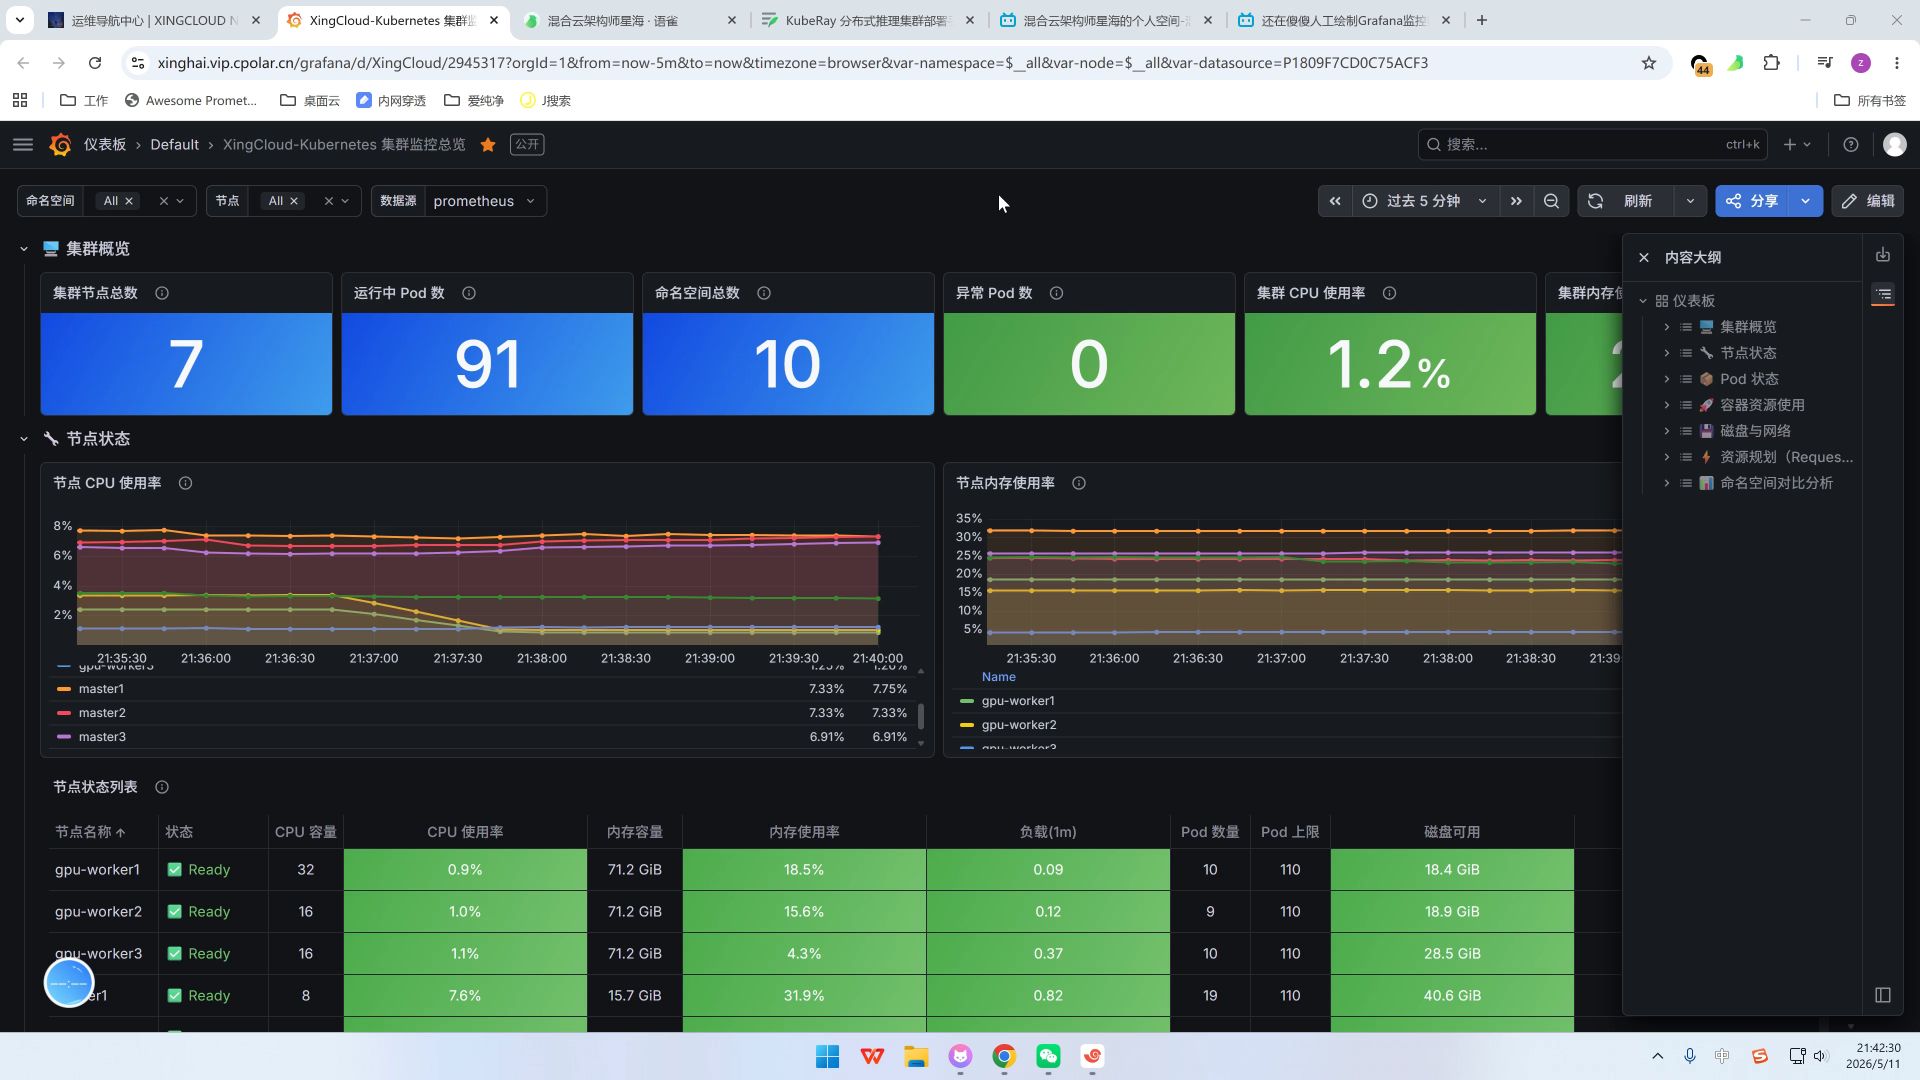
大模型部署监控指标体系构建
传统IT监控关注CPU和内存,但在大模型场景下,这些指标往往滞后,我们需要引入更具业务含义的专用指标,业内专家指出,大模型的稳定性直接取决于推理引擎的资源调度效率,因此指标采集必须深入到Token级别。
核心性能指标监控
性能指标是判断模型是否“健康”的第一道防线,不要只盯着平均值,P99延迟才是用户体验的杀手。
- 首字延迟(TTFT):这是用户感知最明显的指标,如果TTFT超过2秒,用户流失率会显著上升,需监控从请求发起到第一个Token输出之间的时间差。
- 生成速度(Tokens/s):反映模型持续输出的能力,对于长文本生成场景,该指标波动会直接影响并发处理能力。
- 排队等待时间:当请求超过GPU并发上限时,请求会在队列中等待,监控队列长度能预测系统过载风险。
- 吞吐量(TPS):每秒处理请求数,结合并发用户数,可评估当前实例的资源利用率。
资源与成本指标监控
大模型部署是典型的“烧钱”模式,资源监控直接关联运营成本。
- 显存利用率(VRAM Usage):这是最关键的硬件指标,一旦显存接近100%,必然引发OOM(内存溢出)错误,导致服务中断。
- Token消耗量:按Prompt Token和Completion Token分别统计,用于精确计算单次调用成本。
- GPU利用率:区分计算核心利用率与显存带宽利用率,高显存占用但低计算利用率,通常意味着内存带宽成为瓶颈。
告警阈值设定与分级策略
有了数据,如何设定阈值是配置监控告警的关键,盲目设置固定阈值会导致“告警风暴”,而过于宽松则失去监控意义,行业共识认为,动态基线比静态阈值更有效,但在初期,合理的静态分级仍是基础。
告警等级划分标准
建议将告警分为P0至P3四个等级,不同等级对应不同的响应时效和处理流程。
P0级:紧急故障(Critical)
- 触发条件:服务完全不可用、显存溢出导致进程崩溃、核心API返回5xx错误率超过5%。
- 通知方式:电话呼叫+短信+钉钉/企业微信群机器人强提醒。
- 响应要求:15分钟内响应,30分钟内恢复或给出临时方案。
P1级:严重性能下降(Warning)
- 触发条件:TTFT超过设定阈值(如3秒)、Token生成速度下降50%、GPU温度超过85℃。
- 通知方式:即时通讯工具(IM)群消息+邮件。
- 响应要求:2小时内响应,24小时内解决。
P2/P3级:一般提示与趋势预警(Info)
- 触发条件:Token消耗接近月度预算80%、非核心节点负载波动、日志中出现少量Warning。
- 通知方式:每日/每周汇总邮件或看板展示。
动态阈值与异常检测
静态阈值难以适应业务高峰,白天业务量大,TTFT自然升高,夜间则降低,引入基于历史数据的动态基线更为科学。
- 同比/环比分析:将当前TTFT与昨天同一时刻、上周同一时刻对比,若偏差超过2个标准差,则触发告警。
- 突变检测:利用算法检测指标的瞬时跳变,显存占用在1秒内从30%飙升至90%,即使未达100%,也预示潜在风险。
主流监控工具链选型与实操
目前市场上大模型监控方案主要分为开源自建和商业SaaS两类,对于大多数中大型企业,开源方案因其灵活性和成本优势成为首选。
开源方案:Prometheus + Grafana + Alertmanager
这是目前最主流的栈,生态成熟,插件丰富。
- 数据采集:

- 使用
或 内置的Prometheus Exporter暴露指标。 - 对于自研推理服务,通过SDK集成Prometheus Client,手动记录Histogram(延迟分布)和Gauge(当前并发)。
- 使用
- 数据存储:
- Prometheus默认存储短期数据(15天-2个月)。
- 长期存储建议对接Thanos或Cortex,避免数据丢失。
- 可视化:
- Grafana提供丰富的Dashboard模板,可直接导入社区分享的“LLM Monitoring”模板,快速搭建看板。
- 自定义Panel:创建“Token消耗趋势图”、“各模型TTFT对比图”。
- 告警配置:
- Alertmanager负责去重、分组和路由。
- 配置Route规则:P0告警路由到PagerDuty或电话网关,P1路由到Slack/钉钉。
商业SaaS方案对比
若团队缺乏运维人力,可考虑商业方案。
| 特性 | 开源自建 (Prometheus) | 商业SaaS (如LangSmith, Arize) |
|---|---|---|
| 部署成本 | 低(需自行维护服务器) | 高(按Token或实例付费) |
| 功能深度 | 需自行开发Prompt/Response追踪 | 开箱即用,内置语义相似度、幻觉检测 |
| 数据隐私 | 数据完全本地化 | 数据上传至云端,需评估合规性 |
| 适用场景 | 技术团队强大,重视数据主权 | 快速上线,关注模型效果而非基建 |
常见陷阱与优化建议
在配置大模型监控告警时,许多团队会陷入一些误区,导致监控失效或资源浪费。
避免“告警疲劳”
如果告警太多且无效,运维人员会选择性忽略。
- 合并告警:将同一Pod或同一模型实例的多个指标告警合并为一条,当GPU显存溢出时,不要同时发送“显存高”、“进程重启”、“服务不可用”三条告警,只发送一条“服务不可用”并附带根因。
- 静默期设置:对于非紧急指标,设置较长的静默期,避免短时间内重复触发。
日志与指标关联
指标告诉你“出错了”,日志告诉你“为什么出错”。
- Trace ID透传:确保每个请求生成唯一的Trace ID,并在指标标签、日志、告警信息中贯穿始终。
- 告警附带链接:在Alertmanager的通知中,嵌入Grafana或ELK的查询链接,点击告警消息,直接跳转到该次故障发生时的详细日志和指标曲线,极大缩短排查时间。
成本监控前置
不要等到账单出来才发现超支。
- 预算硬限制:在API网关层设置每日Token消耗上限,达到90%时发送P2告警,达到100%时自动熔断或降级(如切换至更小、更便宜的模型)。
- 异常用量检测:监控单个用户或IP的Token消耗速率,若某用户短时间内消耗大量Token,可能是爬虫攻击或程序Bug,需立即触发P0告警并自动封禁。
大模型部署监控告警配置常见问题解答
大模型部署监控告警配置中,如何平衡监控粒度与系统开销?
监控本身会消耗计算资源,建议对核心业务模型开启全量指标采集(每毫秒级),对非核心或测试模型降低采样率(如每秒1次),使用本地聚合器(如StatsD)在边缘节点预聚合数据,再上传至Prometheus,可减少网络传输和存储压力。
当大模型服务出现间歇性超时,监控告警应如何配置才能快速定位?
间歇性超时通常由GPU显存碎片化或网络抖动引起,配置告警时,除监控平均延迟外,必须重点监控P99和P999延迟的分位数指标,开启GPU显存使用率的直方图分布监控,观察是否有大量小块显存无法分配的情况,若发现P99延迟突增而平均延迟正常,优先检查GPU内存碎片和网络连接池状态。
大模型部署监控告警配置是否需要针对不同的模型架构(如Transformer与MoE)进行差异化设置?
是的,对于MoE(混合专家)模型,需额外监控“激活专家数”和“路由延迟”,不同专家的路由不均可能导致部分GPU负载过高而其他闲置,监控看板需增加“专家负载均衡度”指标,告警阈值应设定为当最大负载专家与最小负载专家差异超过30%时触发,以优化资源利用率。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/395874.html


评论列表(1条)
可不咋的,这文章说得太实在了。Token消耗和显存占用确实是痛点,搞不好系统直接崩,整挺好!