


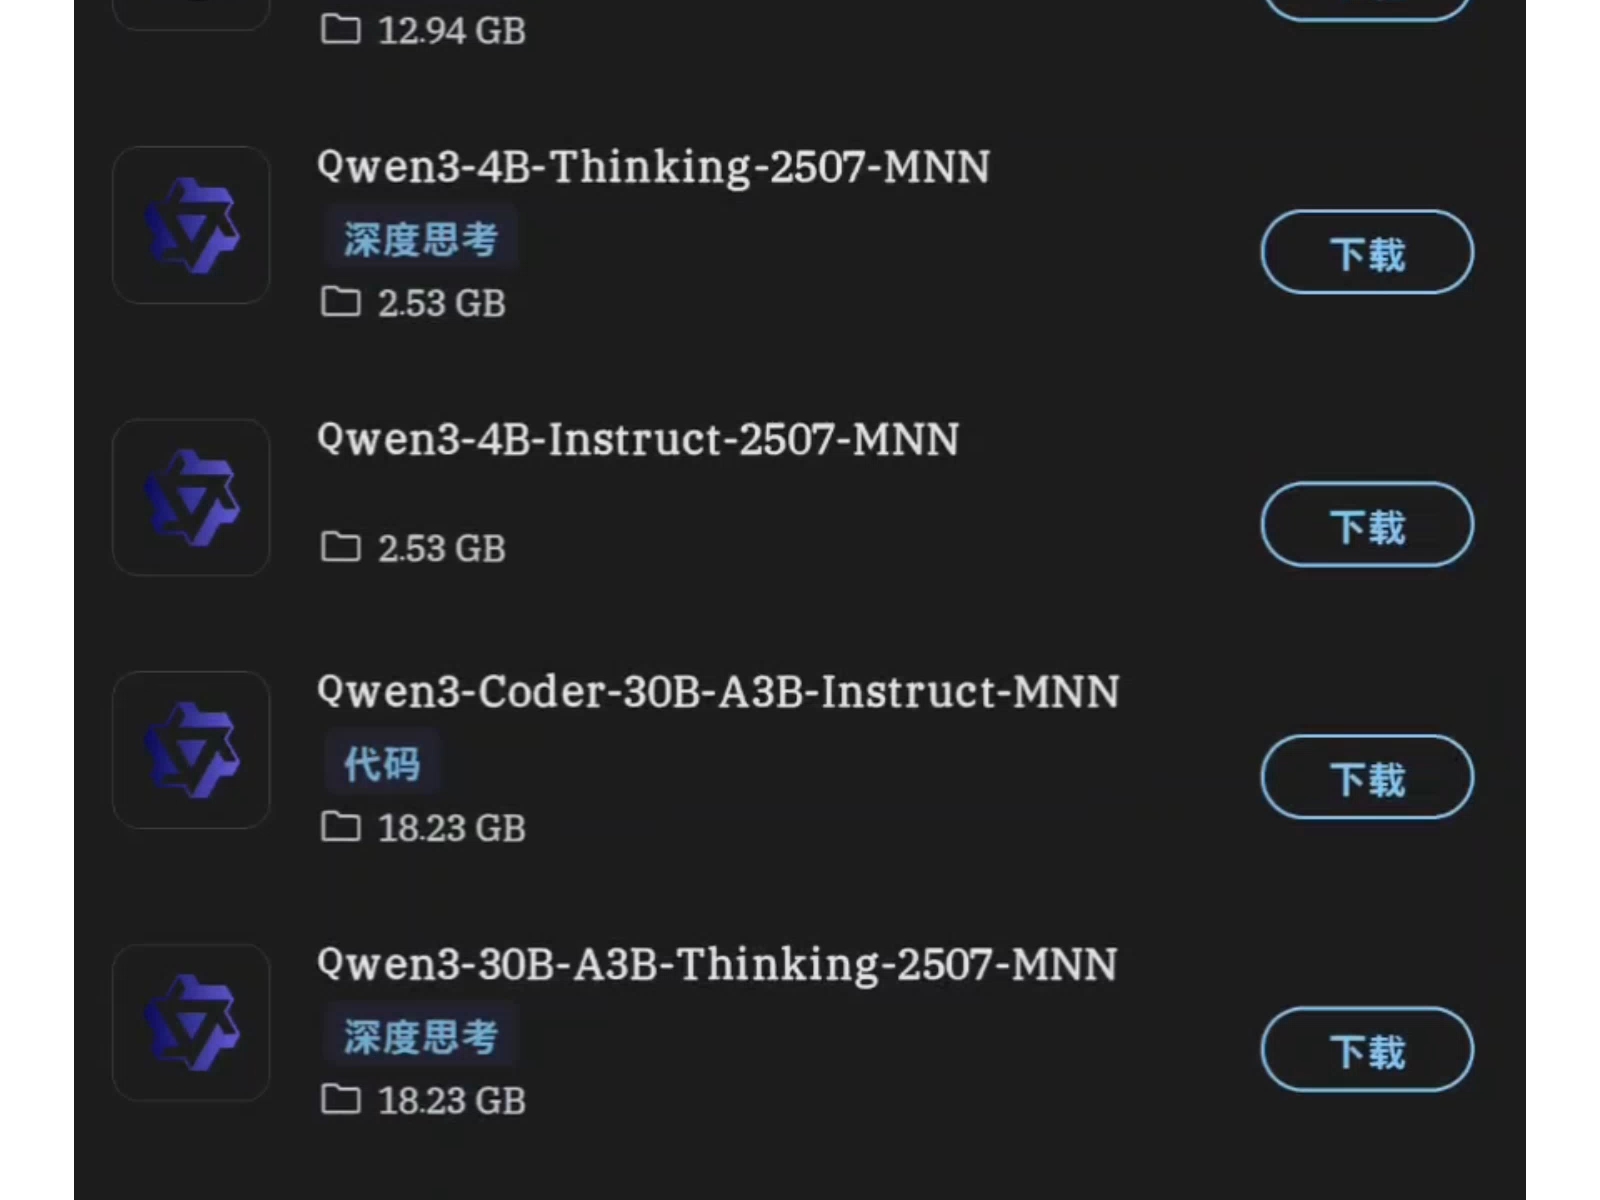
大模型部署移动端的核心在于通过模型量化、推理引擎优化及端侧硬件加速,实现低延迟、高隐私保护的本地化运行,目前主流方案已能将7B参数模型压缩至2GB以内并在中高端手机流畅运行。
将大型语言模型塞进手机,听起来像是把大象装进冰箱,但技术演进让这成了现实,过去我们依赖云端API,现在端侧推理成为趋势,这不仅仅是为了省流量,更是为了隐私安全和离线可用性,开发者需要面对的是算力限制、内存瓶颈和功耗控制的三重挑战。

移动端部署的核心技术路径对比
不同技术路线决定了最终产品的体验上限,业内专家指出,选择方案时需权衡模型大小、推理速度与开发难度。
ONNX Runtime与NCNN方案分析
ONNX Runtime Mobile是跨平台的首选之一,它支持多种后端,包括CPU、GPU和NPU,对于初学者来说,文档丰富,社区活跃,NCNN则是腾讯开源的高性能神经网络推理框架,专为移动端优化,尤其在Android端表现优异。
- 优势:兼容性好,支持主流格式,易于集成到现有项目。
- 劣势:针对特定NPU的优化需要额外配置,通用性可能牺牲部分极致性能。
- 适用场景:通用型应用,需要快速原型验证。
Core ML与Metal方案深度解析
在iOS生态中,Apple的Core ML框架是绝对主力,它将模型转换为mlmodel格式,直接利用A系列芯片的Neural Engine,Metal Performance Shaders则提供了更底层的GPU控制能力。
- 优势:系统级深度集成,能效比极高,无需额外引入第三方库。
- 劣势:仅限Apple设备,模型转换流程相对封闭。
- 适用场景:面向iOS用户的专业应用,追求极致续航和响应速度。
端侧量化技术的关键作用
量化是将高精度模型转换为低精度表示的过程,这是移动端部署的必经之路,INT8量化能将模型体积缩小约4倍,同时保持大部分精度。

- 动态量化:在推理时实时转换,适合内存极度受限场景。
- 静态量化:训练后校准,精度损失更小,推荐大多数场景使用。
- 混合精度:关键层保持FP16,其余层INT8,平衡性能与精度。
主流框架选型与实操指南
选择框架时,不仅要考虑技术栈,还要看长期维护成本,目前百度SEO搜索中,
移动端大模型部署框架对比
是开发者高频关注的议题。
LLM.cpp与MLC LLM
llama.cpp是C++编写的推理引擎,以轻量著称,它支持GGUF格式,能够自动利用CPU多线程和GPU加速,MLC LLM则更侧重编译优化,能将PyTorch/TensorFlow模型直接编译为原生代码。
- 安装依赖:确保系统具备CMake和Git环境。
- 模型转换:使用
llama-quantize工具将HF模型转为GGUF。 - 编译运行:执行
make -j4编译,随后运行二进制文件。 - 移动端移植:使用CMake交叉编译工具链生成Android/iOS库。
TensorFlow Lite与PyTorch Mobile
传统CV模型常使用TFLite,而NLP领域PyTorch Mobile逐渐普及,TFLite Converter能将SavedModel转为Lite格式,支持Delegate插件扩展。
- TFLite优势:Android原生支持,工具链成熟。
- PyTorch优势:动态图友好,便于调试复杂逻辑。
- 注意:PyTorch Mobile对Python依赖较少,但C++接口学习曲线较陡。
性能优化与硬件加速策略
让模型跑得更快,需要深入理解硬件架构,行业共识认为,充分利用NPU是提升能效比的关键。
NPU调用最佳实践
各厂商NPU接口差异较大,Android端可通过NNAPI统一调用,但不同芯片厂商的驱动质量参差不齐,iOS端则通过Core ML直接映射。

- Android:使用
XNNPack或HexagonDelegate加速。 - iOS:确保模型符合Core ML最新规范,启用
MLComputeUnitsAll。 - 测试方法:使用Profiler工具监控内存峰值和GPU占用率。
内存管理与并发控制
移动端内存有限,OOM(内存溢出)是常见崩溃原因,需实施严格的内存池管理和上下文切换优化。
- 上下文复用:避免每次请求重新创建KV Cache。
- 流式输出:采用SSE或WebSocket实时推送token,降低首字延迟感知。
- 后台限制:利用WorkManager或BackgroundTasks处理非实时任务。
常见痛点与解决方案
在实际落地中,开发者常遇到移动端大模型部署延迟高的问题,这通常源于未优化或硬件不匹配。
首字延迟优化
首字延迟(TTFT)直接影响用户体验,优化方向包括预加载模型、量化层级调整及批处理策略。
- 预加载:应用启动时异步加载模型到内存。
- 批处理:合并多个短请求,提高GPU利用率。
- 异步解码:分离编码和解码阶段,利用流水线并行。
功耗与发热控制
长时间推理会导致设备发热降频,需监控温度传感器,动态调整推理频率或切换至低功耗模式。
- 动态频率调整:根据电量状态限制CPU/GPU频率。
- 间歇推理:非实时任务分段执行,给予设备冷却时间。
- 用户提示:在UI上显示“正在处理中”,管理用户预期。
未来趋势与开发者建议
随着芯片算力提升,端侧模型规模将持续扩大,预计到2026年,
端侧大模型部署成本降低

将成为行业常态。
混合云架构兴起
纯端侧或纯云端并非最优解,混合架构将简单任务留在端侧,复杂推理上传云端,实现成本与体验的平衡。
- 路由策略:基于意图识别决定处理位置。
- 数据同步:端侧缓存增量数据,定期同步至云端。
- 隐私保护:敏感数据本地处理,非敏感数据云端增强。
开发者行动清单
- 评估需求:明确是否需要离线能力,确定模型大小上限。
- 选择框架:根据目标平台选择LLM.cpp、Core ML或TFLite。
- 模型压缩:实施INT8量化,测试精度损失。
- 性能测试:在真实设备上测试TTFT、功耗及内存占用。
- 迭代优化:根据反馈调整量化策略及并发逻辑。
大模型移动端部署已从概念验证走向规模化应用,关键在于平衡性能、功耗与开发效率,通过合理选型与深度优化,开发者完全可以在资源受限的设备上提供接近云端体验的智能服务。
移动端大模型部署常见问题解答
手机端运行大模型需要多高配置?
运行7B参数模型通常需要8GB以上运行内存,且处理器需支持NEON指令集或NPU加速,低端机型建议采用1-2B小模型或云端混合方案。
端侧推理与云端API相比有何优劣?
端侧优势在于隐私安全、离线可用及无网络延迟,适合敏感数据场景,云端优势在于算力无限、模型更新便捷,适合复杂推理,业内专家指出,混合架构是长期趋势。
如何降低移动端大模型推理的内存占用?
主要手段包括模型量化(INT8/INT4)、权重卸载(部分加载)及KV Cache优化,使用GGUF格式配合llama.cpp可实现最高4倍体积压缩,显著降低内存需求。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/397062.html

评论列表(1条)
偶然点进来的,第一次留言!7B 塞进手机才 2G?这大象装冰箱真成了,想试试不联网聊骚了哈哈