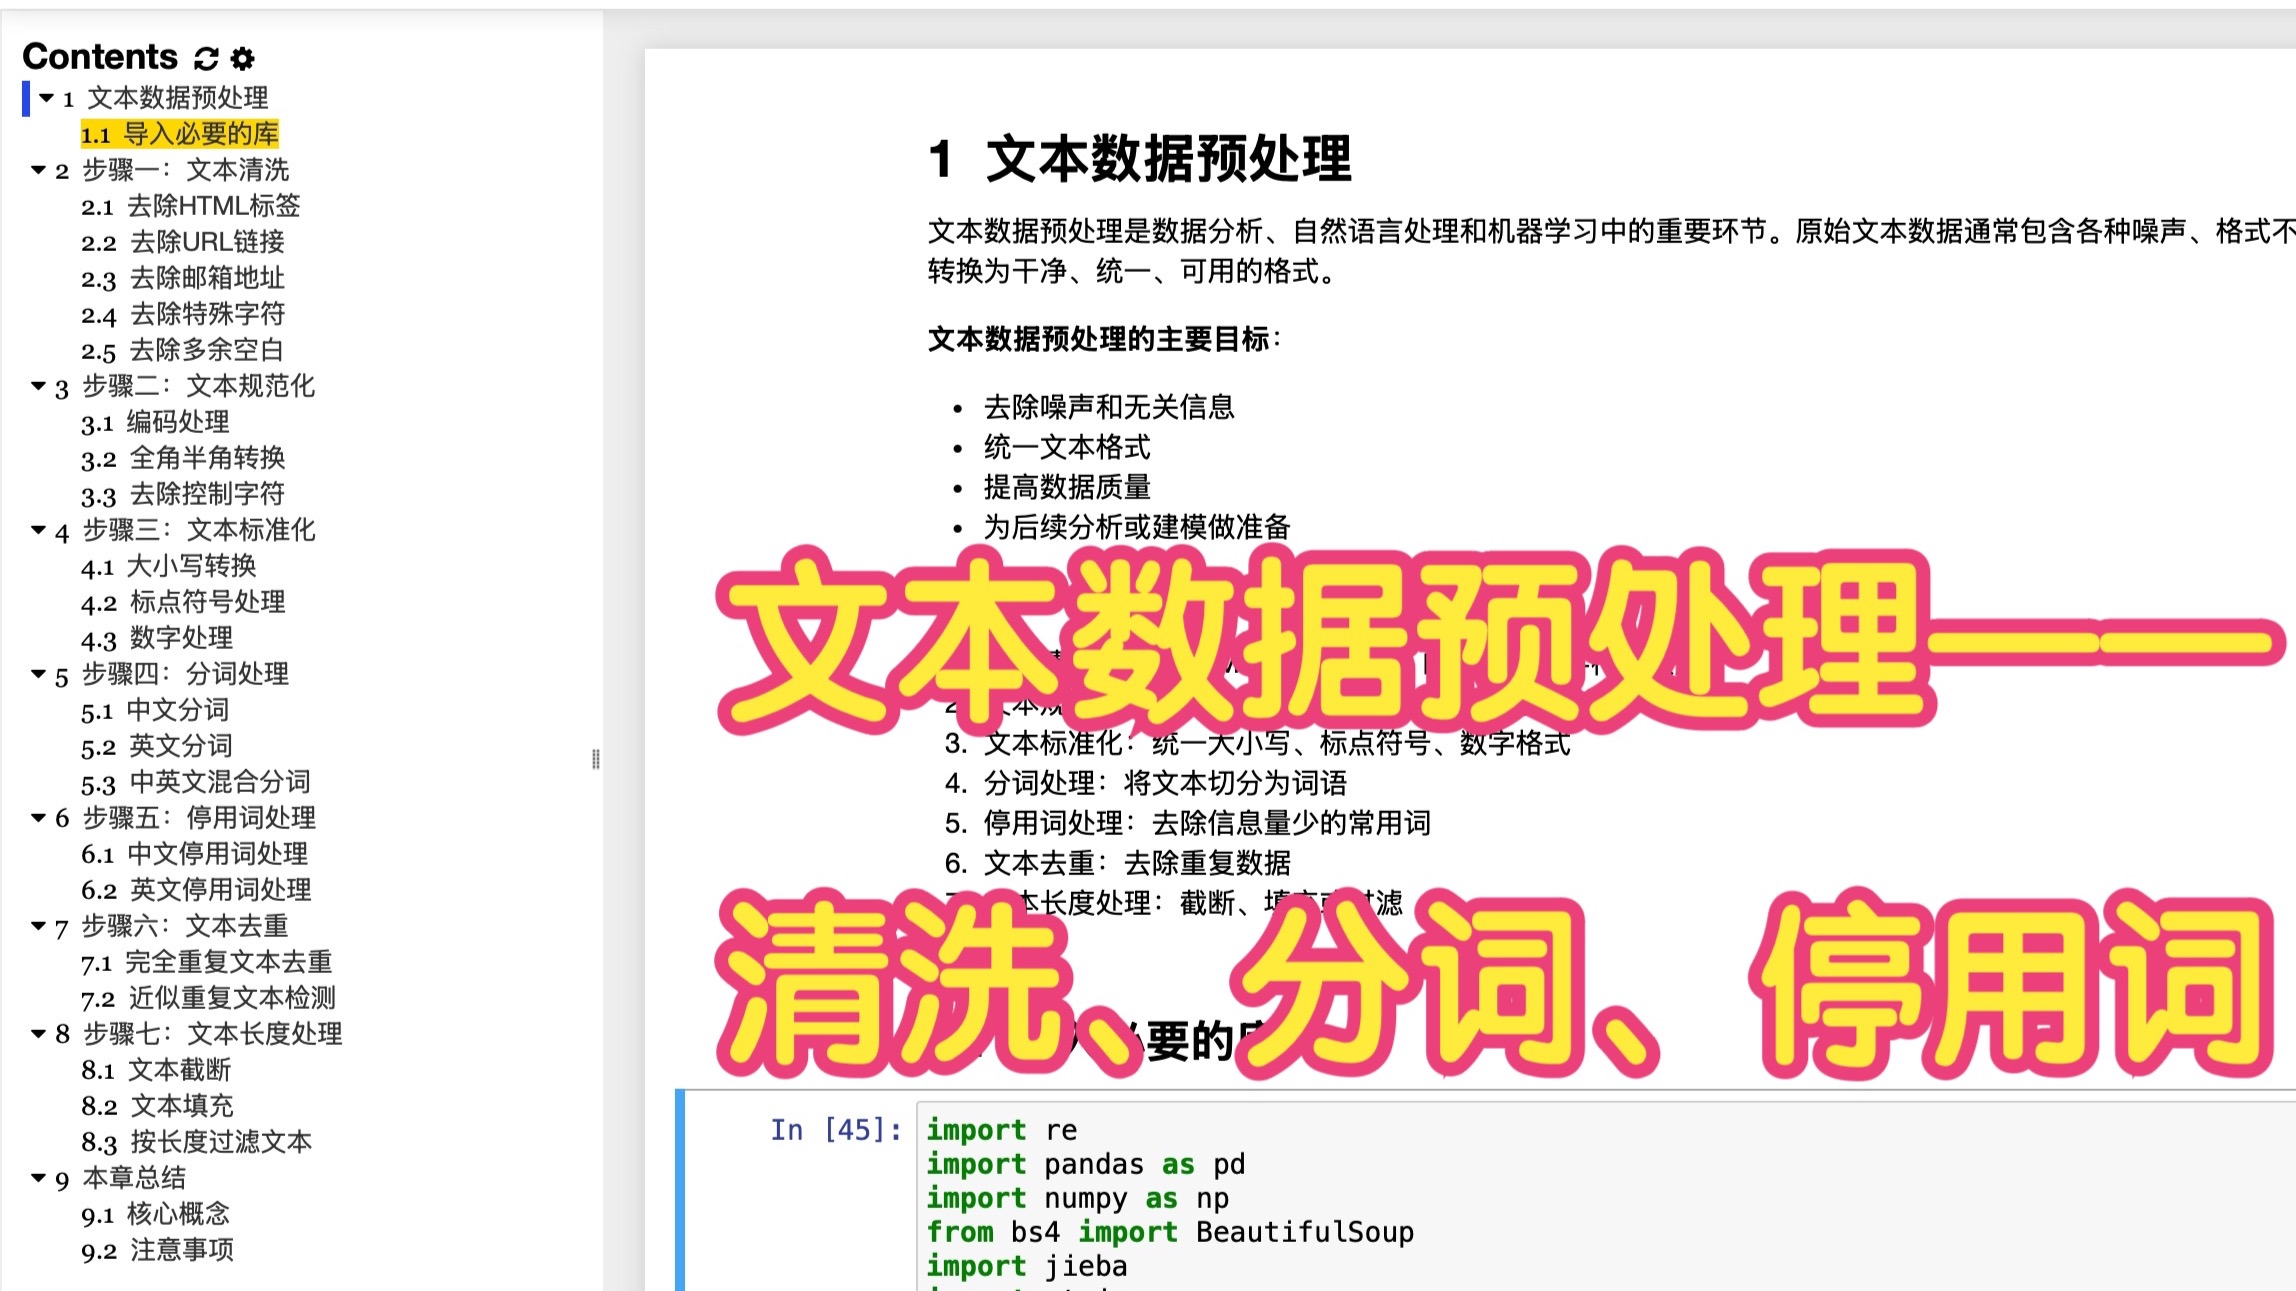
大模型处理未登录词(OOV)的核心机制并非“查字典”,而是通过分词算法拆解、上下文语义推断以及基于子词单元(Subword)的灵活组合,将陌生词汇转化为模型可理解的Token序列,从而在保持语义连贯性的同时实现对新词的实时适应。
在自然语言处理的演进中,未登录词一直是困扰传统系统的难题,随着2026年大语言模型(LLM)的普及,这一概念发生了本质变化,过去的“未登录”是指词表中不存在该词,导致系统无法识别;而现在的“未登录”更多是指模型训练数据截止后出现的新词、缩写或特定领域术语,解决这一问题的关键在于模型对语言结构的深层理解能力,而非简单的词汇匹配。

大模型OOV未登录词怎么处理的技术底层逻辑
要理解大模型如何处理生僻词,首先需要打破“词”的传统概念,现代大模型不再依赖静态的完整词汇表,而是采用更细粒度的文本切分方式。
子词单元Tokenization:拆解陌生词汇
这是处理OOV最基础也最有效的手段,业内专家指出,大多数大模型使用Byte-Pair Encoding (BPE) 或 WordPiece 等算法,这种机制将词汇拆解为更小的语义单元。
- 拆解原理:面对一个从未见过的复合词“元宇宙化”,模型不会将其视为一个整体陌生词,而是将其拆解为“元”、“宇宙”、“化”三个已知的高频子词。
- 组合推理:模型通过注意力机制(Attention Mechanism),结合这三个子词在训练数据中积累的语义向量,重新构建出“元宇宙化”在当前语境下的含义。
- 优势:即使遇到训练期间完全不存在的新造词,只要其组成部分是已知的,模型就能通过组合逻辑进行合理推测。
上下文语义推断:利用语境填补空白
当子词拆解仍不足以确定含义时,大模型依赖强大的上下文感知能力,这种能力使得模型能够像人类一样,“望文生义”。
场景化语义对齐
假设用户输入了一句包含最新网络流行语的句子:“今天这波操作真是绝绝子,直接封神。”
- 识别异常:模型检测到“绝绝子”和“封神”在常规新闻语料中出现频率极低,可能属于特定社群的黑话。
- 语境分析:模型观察前后文,“这波操作”、“直接”等词汇暗示了强烈的正面评价色彩。
- 概率预测:结合海量互联网语料中类似句式的情感倾向,模型推断这两个词表达的是“极度赞赏”或“完美”的含义,并生成符合该情感色彩的回复。

大模型OOV未登录词处理对比传统NLP的差异
为了更清晰地展示技术演进,我们需要对比传统自然语言处理(NLP)与大模型在处理未登录词时的根本区别。
静态词表 vs 动态语义空间
传统NLP系统(如早期的TF-IDF或Word2Vec)严重依赖预先构建的词表,一旦遇到词表外的词,通常会被标记为UNK(Unknown),导致信息丢失。
- 传统NLP局限:无法处理新词,需要定期人工更新词表,维护成本高,且无法捕捉词义的多变性。
- 大模型优势:基于Transformer架构的模型拥有千亿级参数,构建了一个高维的动态语义空间,在这个空间中,词与词之间的关系是通过向量距离体现的,而非简单的存在与否。
处理效率与准确率的数据对比
根据行业共识认为,在处理包含大量专有名词和新兴术语的垂直领域任务时,大模型的表现显著优于传统方法。
| 对比维度 | 传统NLP系统 (2020年前) | 大语言模型 (2026年现状) |
|---|---|---|
| 新词识别方式 | 依赖外部词典或规则匹配 | 自动拆解子词 + 上下文推断 |
| OOV处理结果 | 通常标记为UNK,信息丢失 | 生成合理语义,保持连贯性 |
| 维护成本 | 高,需人工持续更新词表 | 低,模型具备零样本学习能力 |
|
多义词处理 | 困难,需特定领域微调 | 强,依赖上下文自动消歧 |

大模型OOV未登录词处理在实际场景中的应用策略
尽管大模型具备强大的泛化能力,但在某些极端场景下,仍需采取特定策略以优化效果,特别是在医疗、法律等专业领域,术语的准确性至关重要。
垂直领域微调:提升专业术语理解力
对于通用大模型而言,某些高度专业的缩写或新 coined 术语可能仍会产生幻觉,通过领域适配(Domain Adaptation)可以显著提升处理效果。
- 构建领域知识图谱:将特定行业的术语、定义及其关系结构化,作为模型的辅助参考。
- 指令微调(Instruction Tuning):使用包含大量专业术语及其正确解释的问答对,对模型进行微调,提供“什么是LLM-OOV处理?”的标准答案,让模型学习该术语在特定语境下的准确用法。
- 检索增强生成(RAG):在用户提问时,先从专业数据库中检索相关术语的定义,再将定义与问题一起输入模型,这种方法确保了模型在处理OOV时,有最新的、准确的外部知识支撑。
提示词工程:引导模型正确解析新词
在实际操作中,用户可以通过优化提示词(Prompt)来辅助模型理解未登录词。
- 提供定义:在提问时,直接给出新词的定义。“‘XX技术’是指一种基于量子计算的新型加密算法,请解释XX技术的应用场景。”
- 示例引导(Few-Shot Learning):提供几个包含类似新词的示例,帮助模型建立映射关系。“示例1:‘YY’表示快速迭代,示例2:‘ZZ’表示深度整合,请解释‘AA’的含义,它表示全面覆盖。”
大模型OOV未登录词处理面临的挑战与未来趋势
尽管技术不断进步,但处理未登录词仍面临一些挑战,随着AI应用的深入,这些问题将变得更加突出。
语义漂移与幻觉风险
当模型面对完全陌生的词汇组合时,可能会基于概率生成看似合理但实际错误的解释,这种现象被称为“幻觉”。

- 风险点:在金融、医疗等高风险领域,错误的语义推断可能导致严重后果。
- 应对策略:引入置信度评分机制,当模型对某个OOV的解释置信度较低时,主动请求人工确认或拒绝回答。
多语言与跨文化语境下的OOV
在全球化应用中,模型需要处理多种语言混合的OOV现象,中文句子中夹杂英文缩写或方言词汇。
- 挑战:不同语言间的语义映射复杂,模型可能无法准确捕捉跨文化语境下的细微差别。
- 趋势:未来的多模态大模型将结合语音、图像等多维度信息,通过跨模态对齐来提升对混合语言OOV的理解能力。
大模型OOV未登录词处理常见问题解答
大模型如何处理训练数据中没有的专有名词?
大模型主要通过子词切分和上下文推断来处理,模型会将专有名词拆解为更小的字符或子词单元,这些单元通常在训练数据中出现过,模型利用注意力机制分析该词在句子中的位置、搭配词汇以及整体语境,从而推断出其可能的含义,对于新出现的公司名“星链科技”,模型会将其拆解为“星”、“链”、“科”、“技”,并结合前后文判断其指代一个具体的科技企业实体。
为什么大模型有时会对新词产生错误解释?
这通常是因为模型基于概率进行了过度泛化,当新词的语境模糊,或拆解后的子词组合在训练数据中存在多种常见含义时,模型可能会选择概率最高但实际错误的解释,如果新词涉及特定的亚文化或极小众领域,通用大模型缺乏足够的背景知识,容易产生幻觉,解决这一问题通常需要结合检索增强生成(RAG)或领域微调。
大模型OOV未登录词处理技术何时能实现100%准确?
目前业界普遍认为,由于自然语言的复杂性和创造性,实现100%的绝对准确在理论上是不现实的,语言本身具有模糊性和多义性,且新词的产生是动态持续的,未来的发展方向是提高模型的鲁棒性和可解释性,通过多模态信息融合、知识图谱增强以及人类反馈强化学习(RLHF),将错误率降低到可接受的水平,而非追求绝对的零误差。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/409002.html