vLLM通过集成GPTQ量化技术,在保持模型精度基本不变的前提下,显著降低了显存占用并提升了推理吞吐量,是目前在消费级显卡或低成本服务器上部署大语言模型的高效解决方案。
在2026年的AI应用落地场景中,算力成本依然是制约大模型普及的核心瓶颈,许多开发者面临着一个现实困境:想要运行70B甚至更大的开源模型,却受限于昂贵的A100/H100集群预算,vLLM作为当前工业界主流的推理引擎,其对GPTQ量化的原生支持,为解决这一痛点提供了极佳的路径,它不仅仅是一个简单的格式转换工具,更是一套完整的从模型压缩到高效推理的工程化方案。

vLLM GPTQ量化核心优势解析
GPTQ(Generative Pre-trained Transformer with Quantization)是一种后训练量化方法,它通过逐层校准权重,将FP16或BF16的高精度权重映射到INT4或INT8的低精度空间,vLLM对这一技术的深度集成,使得开发者无需重新训练模型即可享受性能红利。
显存占用的断崖式下降
对于大语言模型而言,权重参数占据了推理时显存使用的绝大部分,未经量化的FP16模型,其权重占用空间巨大,一个70B参数的模型在FP16精度下,仅权重部分就需要约140GB的显存,而通过GPTQ量化至INT4后,权重占用可缩减至约35GB左右。
- 精度损失可控:业内专家指出,经过精心校准的GPTQ量化模型,在主流基准测试(如MMLU、HellaSwag)上的性能下降通常控制在1%-3%以内,这种微小的精度牺牲换取巨大的显存节省,在多数应用场景中是完全可接受的。
- 硬件兼容性提升:INT4量化使得原本需要多卡并行才能运行的模型,现在有可能在单张24GB显存的RTX 3090/4090上运行,或者在单张A100上运行更大规模的模型。
推理吞吐量的显著提升
量化带来的不仅仅是显存释放,更直接体现在计算效率的提升上,vLLM利用其独特的PagedAttention机制,结合GPTQ的INT4权重,能够大幅减少内存带宽压力。
- 内存带宽瓶颈突破:大模型推理往往受限于内存带宽而非计算能力,量化后,每次读取的权重数据量减少75%,这意味着在相同硬件条件下,数据加载速度大幅提升。
- 并发处理能力增强:由于单个请求占用的显存减少,系统可以容纳更多的并发请求(Batch Size增大),从而显著提高每秒处理Token的数量(Throughput)。

vLLM GPTQ量化实操指南
理论优势需要落地为具体的操作步骤,以下是基于vLLM官方文档及社区最佳实践整理的标准化操作流程,适用于大多数Hugging Face格式的开源模型。
第一阶段:模型量化准备
在开始之前,你需要确保本地环境已安装最新版本的vllm库以及auto-gptq或optimum等量化相关依赖。
- 选择基准模型:推荐使用经过广泛验证的开源模型,如Llama-3-8B、Mistral-7B或Qwen-72B。
- 安装量化工具:
pip install auto-gptq optimum
- 执行量化脚本:使用
optimum-cli进行量化,以Llama-3-8B为例,量化为INT4精度:optimum-cli export gptq --model meta-llama/Meta-Llama-3-8B --task text-generation --bits 4 --group-size 128 --dataset sample_c4 --output_dir ./llama3-8b-gptq-int4
- 参数说明:
group-size通常设为128或256,较小的group size精度更高但速度稍慢,较大的group size速度更快但精度略降。dataset用于校准,sample_c4是常用的轻量级校准数据集。
- 参数说明:
第二阶段:vLLM推理部署
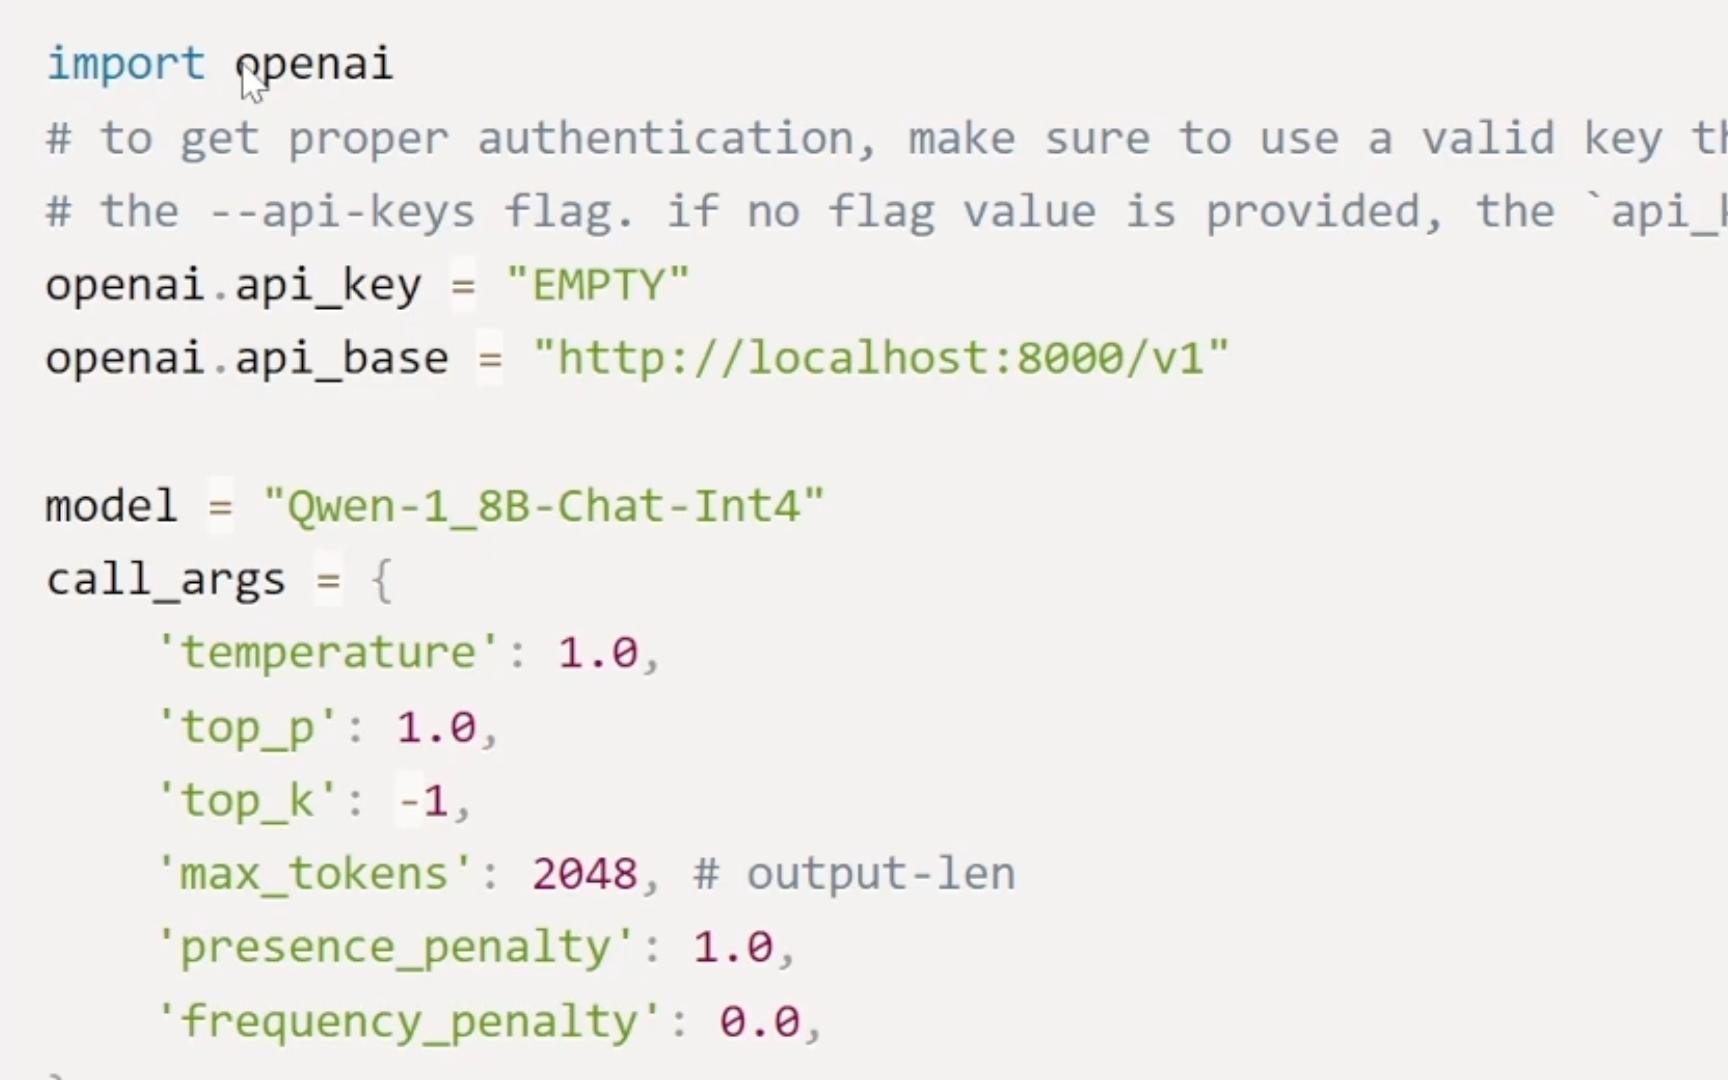
量化后的模型保存为GPTQ格式后,即可直接通过vLLM加载,vLLM会自动识别量化格式并启用相应的优化内核。
-
启动推理服务:
python -m vllm.entrypoints.api_server
  --model ./llama3-8b-gptq-int4
  --dtype auto
  --quantization gptq
- 关键参数:
--quantization gptq是必须显式指定的参数,告知vLLM模型已进行GPTQ量化。--dtype auto让vLLM自动选择最佳的数据类型。
- 关键参数:
-
验证性能:
使用vllm自带的benchmark工具或第三方工具如locust进行压力测试,对比量化前后的吞吐量。

常见问题排查
- 显存溢出(OOM):如果仍然OOM,尝试减小
--max-model-len参数,限制最大上下文长度。 - 精度异常:如果生成内容质量明显下降,检查量化时的校准数据集是否具有代表性,或尝试调整
group-size。
vLLM GPTQ与AWQ量化对比分析
在量化方案的选择上,GPTQ并非唯一选项,AWQ(Activation-aware Weight Quantization)也是近年来的热门选择,了解两者的差异有助于做出更合适的技术选型。
| 特性 | GPTQ | AWQ |
|---|---|---|
| 量化原理 | 基于梯度的逐层优化,对权重进行精细校准 | 基于激活值分布,识别并保护重要权重 |
| 量化精度 | 通常支持INT4,部分支持INT3 | 主要支持INT4,对INT2支持较好 |
| 校准难度 | 较高,需要合适的校准数据集 | 较低,通常无需额外数据集,使用少量样本即可 |
| 推理速度 | 极快,vLLM内核优化成熟 | 快,但部分硬件上略逊于GPTQ |
| 适用场景 | 对精度要求极高,且有充足时间进行校准 | 快速部署,追求开箱即用,硬件兼容性要求高 |
业内共识认为,GPTQ在精度保持上略占优势,特别是在复杂逻辑推理任务中;而AWQ在部署便捷性上更具吸引力,对于vLLM用户而言,两者均得到良好支持,选择应基于具体业务对精度与部署成本的权衡。
特定场景下的vLLM GPTQ应用策略
不同的应用场景对量化的容忍度和需求各不相同,以下是几种典型场景的建议策略。

企业级客服机器人
在客服场景中,响应速度和一致性至关重要,建议使用GPTQ INT4量化,并配合vLLM的连续批处理功能,由于客服问答通常具有重复性,量化带来的微小精度损失对用户感知影响极小,但显存节省允许你部署更多的实例副本,从而轻松应对流量高峰。
创意写作辅助
创意写作对模型的多样性和创造性要求较高,过度量化可能导致模型“思维僵化”,建议采用GPTQ INT4但保留较大的group size(如256),或者考虑混合精度策略,即对关键层保持FP16,其余层量化,虽然这会增加显存占用,但能更好地保留模型的创意能力。
边缘设备部署
如果在边缘设备(如Jetson Orin)上运行,显存和算力都极为有限,GPTQ INT4几乎是必选项,vLLM在ARM架构上的支持也在不断完善,确保使用最新版本的vLLM以获取最佳的NEON指令集优化。
Q&A:vLLM GPTQ量化常见问题解答
vLLM GPTQ量化是否支持所有开源模型?
vLLM支持绝大多数基于Transformer架构的开源模型,包括Llama系列、Mistral、Qwen、Baichuan等,只要模型权重格式兼容Hugging Face,且量化过程正确,vLLM通常都能直接加载,对于某些小众架构或经过特殊修改的模型,可能需要检查vLLM的源码以确认是否支持相应的量化内核。
GPTQ量化后的模型能否直接用于微调?
不建议直接将GPTQ量化后的模型用于全参数微调,量化过程会破坏权重的原始分布,直接微调可能导致性能急剧下降,正确的做法是:使用原始FP16/BF16模型进行LoRA或QLoRA微调,然后再对微调后的模型进行量化,QLoRA本身就是一种结合4-bit量化和LoRA的高效微调技术,与GPTQ量化推理形成互补。
vLLM GPTQ量化对硬件有什么特殊要求?
vLLM的GPTQ支持主要依赖于GPU的Tensor Core能力,NVIDIA GPU从Volta架构(如V100)开始支持INT4计算,但为了获得最佳性能,建议使用Ampere架构(如A100, A30)或更新架构(如H100, RTX 30/40系列),这些架构对INT4运算有专门的硬件加速,能充分发挥GPTQ量化的速度优势,对于AMD GPU,vLLM的支持正在逐步完善,但GPTQ的优化程度目前仍略低于NVIDIA生态。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/400973.html