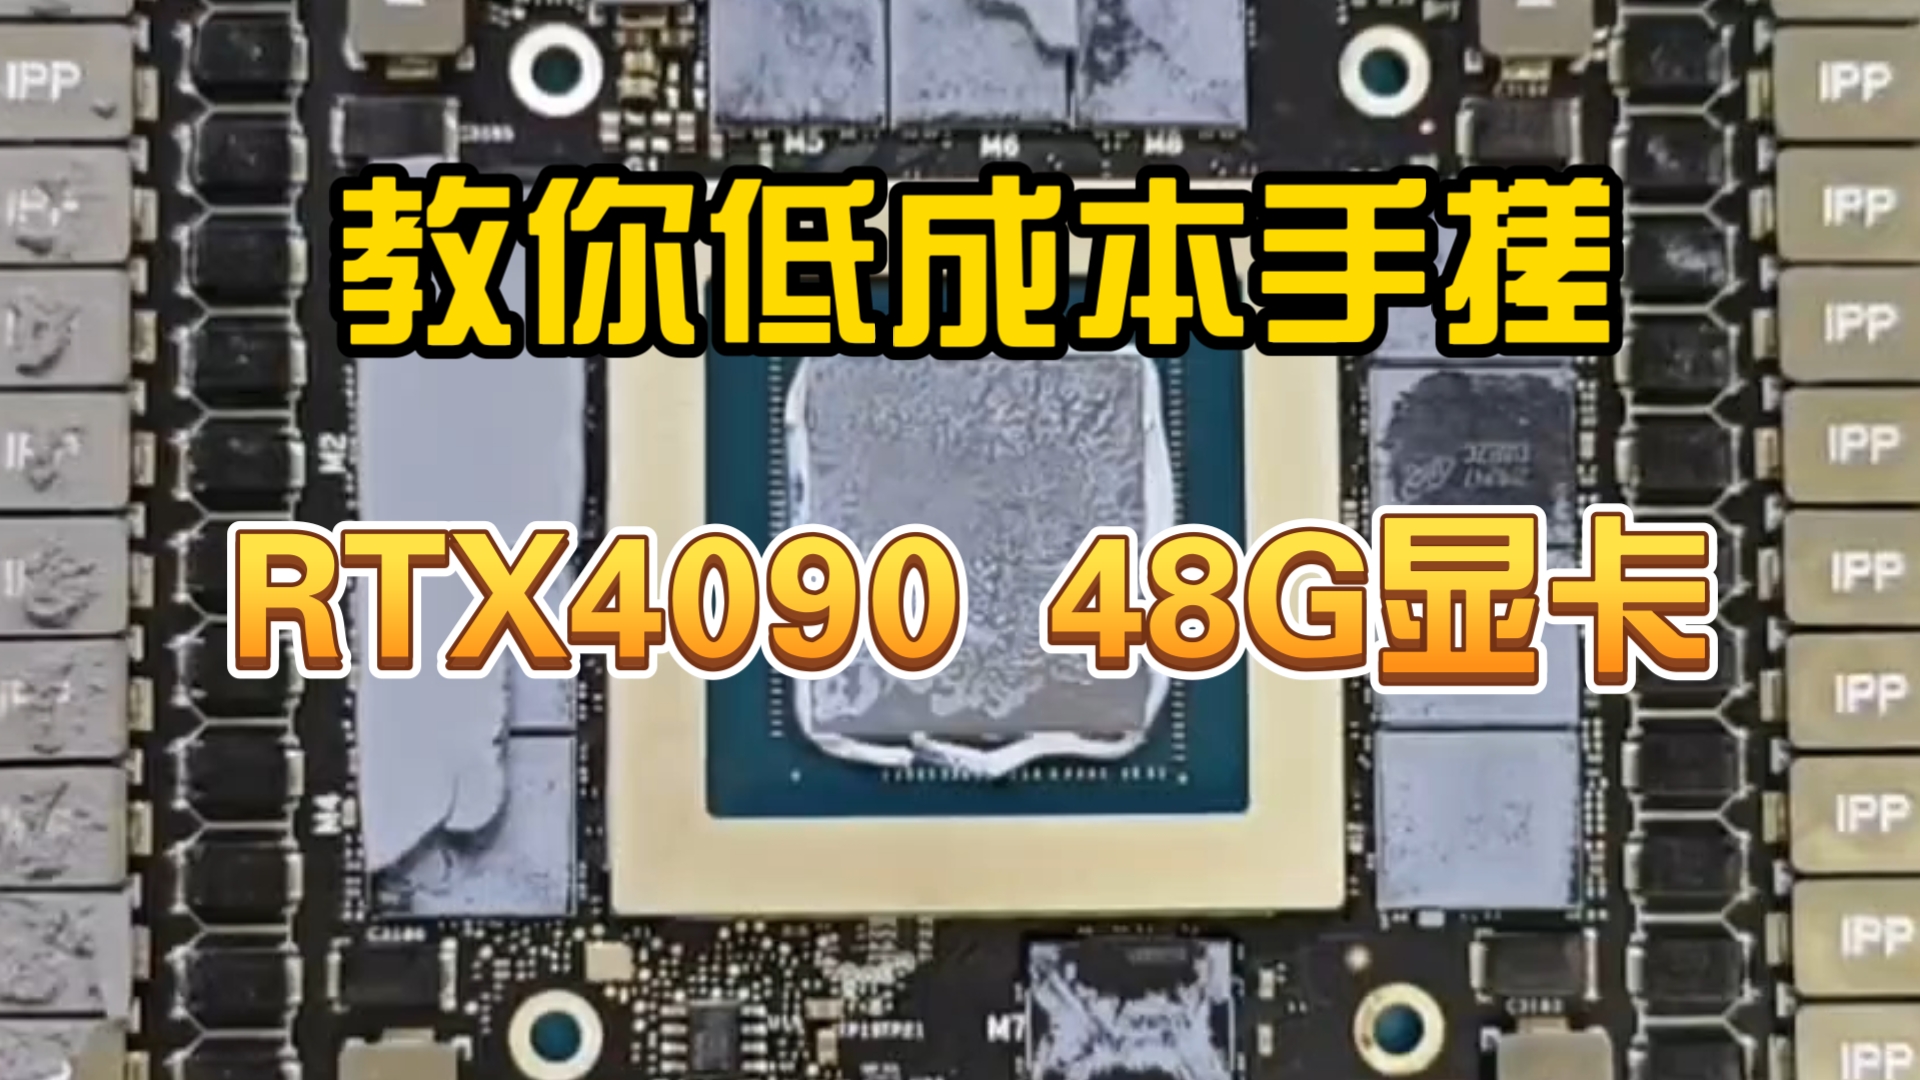
在2026年的硬件环境下,单张RTX 4090凭借24GB显存,主要能流畅运行参数量在70亿至130亿之间、经过4-bit至8-bit量化压缩的本地大模型,若追求极致流畅度,7B-13B量化模型是最佳选择;若需运行70B级别模型,则必须依赖显存优化技术或接受较低的生成速度。
很多人对RTX 4090抱有“全能显卡”的幻想,认为它足以承载任何规模的AI大模型,显存容量才是决定模型能否“装得下”以及“跑得快”的物理瓶颈,24GB的显存对于消费级显卡而言已是顶配,但在面对动辄数百GB参数的现代大模型时,依然显得捉襟见肘,我们需要透过现象看本质,理解显存占用与模型参数、量化精度之间的数学关系,才能做出理性的部署决策。

显存瓶颈与模型容量的硬性约束
理解大模型在显卡上的运行机制,是选择合适模型的第一步,大模型的参数并非全部存储在内存中,而是必须加载到显存里进行高速计算,一个未经压缩的FP16(半精度)模型,其参数量每增加10亿,显存占用大约增加2GB,这意味着,一个70亿参数(7B)的模型在FP16精度下需要约14GB显存,而一个700亿参数(70B)的模型则需要惊人的140GB显存,这远远超出了RTX 4090的物理极限。
为了在有限的显存中运行更大的模型,业界普遍采用量化技术,量化通过将高精度浮点数转换为低精度整数,大幅降低显存需求,同时尽量保持模型智能水平。
量化技术如何拯救小显存
量化是RTX 4090用户必须掌握的核心技能,目前主流的量化标准包括4-bit、8-bit和FP16。
- 4-bit量化(INT4):这是目前运行大模型最激进也最实用的方案,它将每个参数压缩至4位,使得70B参数的模型仅需约35-40GB显存,虽然RTX 4090单卡无法容纳完整的70B模型,但通过显存分层技术(部分加载到显存,部分留在内存),可以实现“能跑”,但速度会受限于PCIe带宽。
- 8-bit量化(INT8):这是性能与精度的平衡点,8-bit量化下,7B模型仅需约7-8GB显存,13B模型约13-15GB,34B模型约34-40GB,对于RTX 4090而言,8-bit量化下的13B模型可以完全驻留显存,实现极速推理;34B模型则可能需要部分卸载到系统内存。
- FP16/BF16:仅适用于7B及以下的小模型,或者作为微调时的基准参考。

业内专家指出,量化带来的精度损失在大多数日常应用场景中是可以接受的,尤其是对于代码生成、摘要总结等逻辑性较强的任务,4-bit量化模型的表现往往接近FP16版本。
RTX 4090能跑的具体模型清单
基于24GB显存,我们可以梳理出以下可运行的模型范围:
| 模型规模 | 量化精度 | 显存占用估算 | 运行状态 | 推荐场景 |
|---|---|---|---|---|
| 7B – 13B | INT4 | 4GB – 8GB | 完全驻留,极速 | 日常对话、代码辅助、文本创作 |
| 13B – 30B | INT4 | 8GB – 16GB | 完全驻留,流畅 | 复杂推理、长文档分析、多轮对话 |
| 34B – 70B | INT4 | 18GB – 38GB | 部分显存+内存 | 需要高智能但可接受较慢速度 |
| 70B+ | INT4 | >40GB | 主要依赖内存 | 不推荐单卡运行,体验较差 |

对于大多数用户而言,13B-30B参数规模的INT4量化模型是RTX 4090的黄金区间,这类模型如Llama-3-8B的增强版、Qwen-14B或Mistral-7B的变体,既能充分利用24GB显存,又能提供超越小型模型的逻辑推理能力。
本地部署实操与性能优化策略
知道了能跑什么模型,接下来是如何让它跑得更快、更稳,在2026年,本地大模型的部署工具链已经非常成熟,但细节决定成败。
软件环境的选择
推荐使用Ollama、LM Studio或vLLM作为推理后端。
- Ollama:适合新手,命令行操作简洁,支持一键拉取量化模型。
- LM Studio:提供图形界面,可视化强,适合Windows用户快速测试不同模型。
- vLLM:适合高级用户,支持高并发请求,显存管理更高效,适合构建本地API服务。
关键优化参数设置
在部署过程中,以下设置能显著提升RTX 4090的利用率:
- 上下文长度(Context Length):默认设置为4096或8192,过长的上下文会线性增加显存占用,如果显存不足,可适当缩短上下文,或启用滑动窗口机制。
- 批处理大小(Batch Size):设置为1或自动调整,过大的批处理会导致显存溢出(OOM)。
- GPU层数分配:在支持模型分层的软件中,尽量将更多Transformer层分配给GPU,RTX 4090可以容纳大部分7B-13B模型的全部层,但对于30B+模型,需合理分配层数,避免显存碎片化。
系统内存与虚拟显存的配合
当模型超过24GB时,系统内存(RAM)成为关键,RTX 4090用户通常配备64GB或128GB内存,在模型无法完全装入显存时,部分层会卸载到系统内存,虽然内存带宽远低于显存带宽,但现代CPU的多核并行能力可以缓解部分压力,确保系统内存为DDR5 6000MHz或以上,PCIe 4.0 x16通道畅通,是保证“显存+内存”混合模式性能的基础。

应用场景与性价比分析
RTX 4090运行大模型并非为了替代云端API,而是为了数据隐私、离线可用性和长期成本节约。
隐私敏感型场景
在医疗、法律、金融等领域,数据出境或上云存在合规风险,使用RTX 4090本地部署7B-13B量化模型,可以实现完全离线的数据处理,使用Qwen-14B-INT4进行合同条款审查,所有数据仅在本地流转,无需担心泄露。
开发者与创作者的工作流
对于程序员,本地部署CodeLlama-7B或StarCoder-15B,可以实现实时代码补全和错误检测,无需等待云端响应,对于内容创作者,使用Llama-3-8B进行头脑风暴和草稿生成,可以快速迭代创意,提升工作效率。
成本对比:本地 vs 云端
虽然RTX 4090初始投入较高,但长期来看,对于高频用户,本地部署更具经济性,云端API按Token计费,高频调用费用高昂;而本地部署一次性投入硬件,后续电费和维护成本极低,据行业共识认为,对于日均调用超过1000次的用户,本地部署在一年内即可收回硬件成本。
常见问题解答
RTX 4090能直接运行未经量化的70B大模型吗?
不能,未经量化的70B模型需要约140GB显存,远超RTX 4090的24GB,即使使用8-bit量化,也需要约70GB显存,单卡RTX 4090无法直接运行完整参数的大规模未量化模型。
如何判断我的模型是否完全在显存中运行?
可以通过监控软件(如NVIDIA SMI或任务管理器)观察显存占用,如果显存占用接近24GB且GPU利用率持续高位,说明模型完全在显存中,如果显存占用较低但生成速度慢,说明部分模型层在系统内存中,受限于内存带宽。
RTX 4090运行大模型时发热严重怎么办?
确保机箱风道畅通,使用高转速风扇或水冷散热,在软件层面,降低批处理大小和上下文长度可以减少计算负载,从而降低发热,保持显卡驱动为最新版本,以获取最新的功耗管理和性能优化补丁。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/402162.html