大模型本地部署的核心在于利用本地显卡算力运行开源模型,主要优势是数据隐私安全与零月费,适合对隐私敏感或希望深度定制AI能力的开发者与极客用户。
近年来,随着人工智能技术的普及,越来越多的用户不再满足于云端API的调用限制,转而寻求将大语言模型“装”进自己的电脑里,这种趋势不仅源于对数据隐私的担忧,更因为本地部署能带来更低的长期成本和更高的响应自由度,对于新手而言,这听起来像是一项高深的技术工程,但实际上,借助成熟的开源工具和优化的推理引擎,构建一个专属的AI助手已经变得前所未有的简单。

本地部署大模型的核心优势与适用场景
在决定动手之前,明确“为什么”比“怎么做”更重要,业内专家指出,本地部署并非适用于所有用户,它更适合那些有特定需求的人群。
数据隐私与安全性考量
当你使用云端服务时,你的提问数据会经过第三方服务器,虽然主流厂商都有隐私政策,但对于处理商业机密、医疗记录或个人敏感信息的用户来说,数据留在本地硬盘是最安心的选择,这种“物理隔离”带来的安全感,是云端服务无法完全替代的。
成本控制的长期视角
云端API通常按Token计费,对于高频使用者而言,费用可能迅速累积,相比之下,本地部署是一次性硬件投入,后续运行成本仅为电费,据行业共识认为,对于日均交互超过数百次的重度用户,本地部署在半年内即可收回硬件成本。
无网络依赖的稳定性
在断网环境、差旅途中或网络不稳定的地区,本地模型依然可以流畅运行,这种独立性对于需要随时调用AI辅助创作或编程的用户来说,是不可或缺的功能。
硬件配置要求与选型指南
本地部署的瓶颈在于硬件,尤其是显存(VRAM),很多新手容易陷入“唯显卡论”的误区,内存和CPU也起着关键作用。
显卡(GPU):核心算力来源

NVIDIA显卡因其CUDA生态的支持,是本地部署的首选。
- 入门级:如RTX 3060(12GB显存)或RTX 4060 Ti(16GB版),这类显卡足以运行7B-13B参数量的量化模型,满足日常对话和基础写作需求。
- 进阶级:如RTX 3090/4090(24GB显存),这是目前个人用户的主流选择,可以流畅运行30B-70B参数量的模型,甚至进行简单的微调。
- 专业级:如A100/H100或双卡/多卡并联,适合企业级应用或需要运行超大参数模型(100B+)的场景,但成本极高。
内存(RAM)与存储
如果显存不足,系统会自动调用系统内存,但速度会大幅下降,建议系统内存至少为32GB,理想状态为64GB,存储方面,模型文件通常较大,7B模型约4-8GB,70B模型可能超过40GB,建议使用NVMe SSD以保证加载速度。
苹果M系列芯片的特殊优势
对于Mac用户,M1/M2/M3系列的统一内存架构提供了另一种选择,由于CPU和GPU共享内存,16GB或32GB的MacBook Pro可以运行比同价位Windows笔记本更大的模型,32GB内存的Mac可以流畅运行70B参数量的量化模型,这是同等显存的NVIDIA显卡难以做到的。
主流部署工具对比与选择
市面上有多种工具可以帮助部署大模型,新手应根据自身技术背景选择。
Ollama:极简主义者的首选
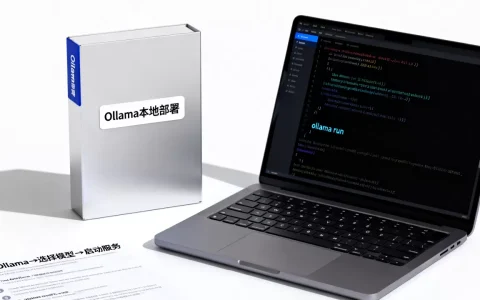
Ollama是目前最流行的本地大模型运行框架之一,特别适合Windows、Mac和Linux用户,它通过一行命令即可下载和运行模型,无需配置复杂的Python环境。
- 优点:安装简单,社区模型库丰富,支持后台静默运行。
- 缺点:自定义程度较低,难以进行复杂的模型微调。
- 适用人群:只想快速体验本地AI,不想折腾代码的用户。
LM Studio:图形界面的友好选择
LM Studio提供了一个直观的图形界面,允许用户浏览、下载和测试各种GGUF格式的模型,它内置了聊天界面,可以直接与模型对话,并支持API服务器模式,方便与其他应用集成。
- 优点:可视化操作,模型搜索方便,支持多种格式。
- 缺点:资源占用略高,高级功能需付费。
- 适用人群:喜欢图形界面,希望直观管理多个模型的用户。

Text Generation WebUI (Oobabooga):极客的游乐场
这是功能最强大的开源工具之一,支持WebUI界面,提供丰富的参数调整选项,包括LoRA微调、插件扩展等。
- 优点:功能极其丰富,社区活跃,教程众多。
- 缺点:安装过程复杂,依赖项多,容易出错。
- 适用人群:有一定编程基础,希望深度定制和微调模型的用户。
新手实操步骤:从零开始运行第一个模型
为了让你快速上手,我们以最主流的Ollama为例,演示如何部署一个7B参数量的模型。
第一步:安装Ollama
访问Ollama官网,根据你的操作系统下载对应的安装包,Windows用户直接运行.exe文件,Mac用户拖入应用程序文件夹,安装完成后,打开终端(Windows为PowerShell或CMD,Mac为Terminal)。
第二步:拉取并运行模型
在终端中输入以下命令:
ollama run llama3这条命令会自动下载Meta公司开源的Llama 3模型(默认7B版本),并开始运行,下载速度取决于你的网络状况,首次下载可能需要几分钟到几十分钟不等。
第三步:开始对话
下载完成后,终端会进入交互模式,你可以直接输入中文或英文问题,请解释量子计算的基本原理”,模型会立即给出回答,你已经成功拥有了一个本地运行的AI助手。
第四步:扩展与集成
如果你希望将本地模型集成到Notion、Obsidian或其他应用中,可以启动Ollama的API服务器,在终端输入:
ollama serve你可以使用标准的OpenAI兼容API格式进行调用,这使得本地模型可以无缝接入各种支持OpenAI API的应用生态中。

常见问题与优化建议
如何提升运行速度?
模型量化是关键,将FP16精度的模型转换为INT4或INT8量化版本,可以在几乎不损失智能程度的前提下,大幅减少显存占用并提升推理速度,大多数主流工具都提供量化版本的模型下载。
显存不足怎么办?
如果显存爆满,可以尝试选择更小参数量的模型(如从70B切换到7B),或启用CPU推理模式,虽然速度会变慢,但通常仍能正常运行,关闭其他占用显存的应用程序(如浏览器、游戏)也能释放资源。
模型更新与维护
大模型技术迭代迅速,建议定期检查工具更新和模型版本,新的模型往往在逻辑推理、多语言支持等方面有显著提升,注意备份你的自定义提示词和微调数据,以便在新版本中快速恢复。
大模型本地部署新手入门Q&A
大模型本地部署对电脑配置有什么最低要求?
最低配置取决于模型大小,对于7B参数量的INT4量化模型,建议至少拥有8GB显存(NVIDIA显卡)或16GB统一内存(Mac),系统内存建议不低于16GB,存储空间预留20GB,若运行更大模型,需相应增加显存或内存。
本地部署的大模型效果与云端API相比如何?
在相同参数量级下,本地运行的是开源模型(如Llama 3、Qwen),而云端API通常使用经过深度优化和私有数据训练的闭源模型,云端API在指令遵循、事实准确性和多轮对话流畅度上往往略胜一筹,但本地模型在隐私保护、定制化和长期成本上具有明显优势,随着开源模型的进步,两者差距正在迅速缩小。
本地部署是否支持中文?
是的,绝大多数主流开源模型都经过中文语料训练,支持良好的中文理解与生成能力,Llama 3、Qwen(通义千问开源版)、Baichuan(百川开源版)等模型在中文任务上表现优异,用户只需在提示词中使用中文,模型即可用中文回答。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/402294.html