大模型推理完全可以使用NPU,且在端侧部署、低功耗场景及特定推理加速任务中,NPU往往比传统CPU或GPU更具能效优势,但需权衡生态兼容性与模型适配成本。
NPU跑大模型的底层逻辑与硬件优势
很多人对NPU(神经网络处理器)的印象还停留在手机拍照或简单的图像识别上,觉得它跑不动动辄百亿参数的大语言模型,这其实是一个误区,NPU的设计初衷就是专门处理矩阵乘法和张量运算,而这正是大模型推理的核心计算负载。
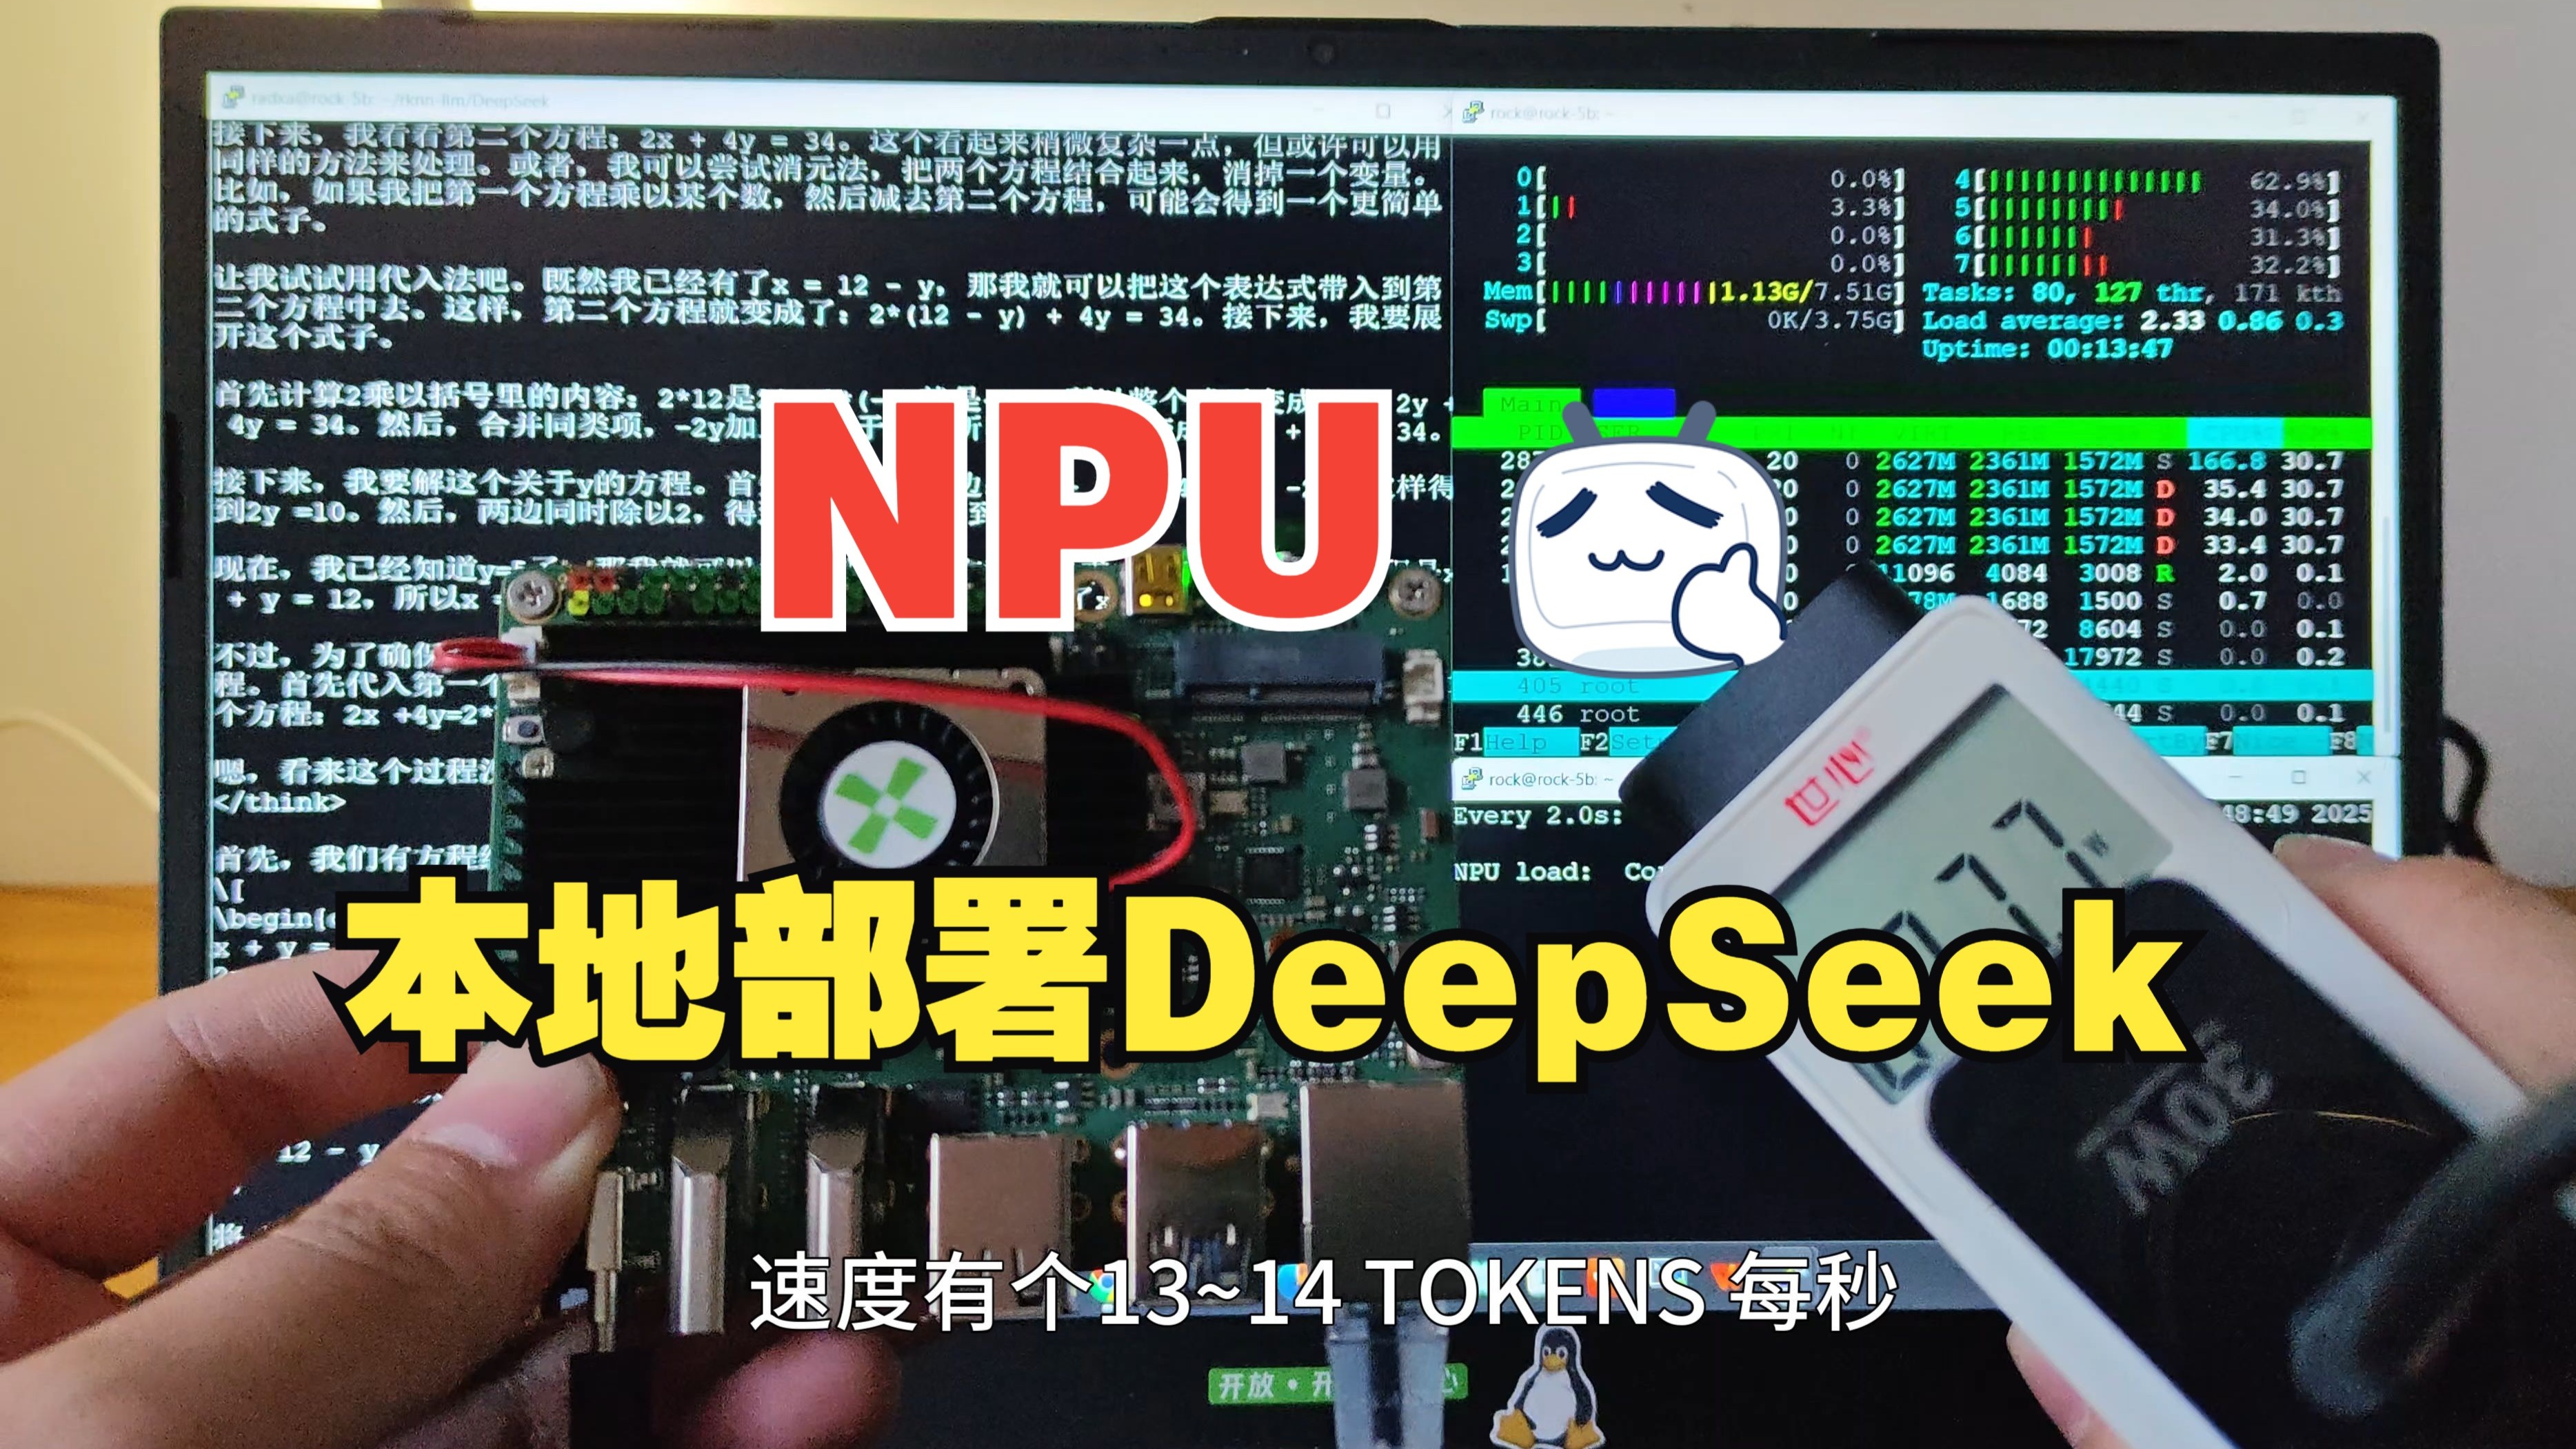

为什么NPU适合推理而非训练
大模型的训练需要极高的显存带宽和动态计算能力,GPU凭借CUDA生态和通用性占据主导,但推理阶段,模型权重是固定的,计算路径相对静态,这正是NPU的强项。
- 能效比极致:NPU采用数据流架构,数据在片上流动,减少了内存读写次数,在同等算力下,NPU的功耗通常只有GPU的几分之一。
- 专用指令集:针对INT8、INT4等量化格式进行硬件级优化,大模型推理中广泛使用的量化技术能完美匹配NPU的硬件特性。
- 低延迟响应:对于实时性要求高的场景,如车载语音助手或智能家居控制,NPU能提供毫秒级的推理响应。
业内专家指出,随着模型压缩技术的发展,NPU在处理7B以下参数量的模型时,已经展现出超越传统嵌入式GPU的性能表现。
端侧部署的实际场景
想象一下,你在没有Wi-Fi的山野露营,手机离线运行一个本地LLM助手,这时候,如果依赖CPU,电量可能在半小时内耗尽;如果依赖GPU,发热会让手机烫手,而NPU能在低功耗下维持长时间稳定运行,这就是“手机端侧大模型推理”的典型应用场景。
技术挑战:生态适配与量化瓶颈
虽然硬件原理上可行,但实际落地中,NPU跑大模型并非“开箱即用”,最大的障碍在于软件生态和模型格式的兼容性。
算子支持与框架兼容
不同于GPU拥有成熟的CUDA库和PyTorch/TensorFlow深度集成,NPU的生态相对碎片化,不同厂商(如华为昇腾、高通Hexagon、联发科APU)拥有各自的推理引擎。

- 算子缺失:大模型中的某些复杂算子(如特定的Attention机制变体)可能在NPU驱动中未优化,导致回退到CPU执行,反而降低效率。
- 格式转换:模型通常以ONNX或Hugging Face格式存储,需要转换为NPU专用的二进制格式(如华为的OM模型、高通的SNPE格式),这个过程需要专门的转换工具链。
量化带来的精度损失
为了在NPU上高效运行,大模型必须进行量化,通常从FP16降至INT8甚至INT4。
- INT4量化:能显著减少内存占用,提升推理速度,但可能导致语义理解能力下降,出现“幻觉”增加。
- 混合精度:关键层保持FP16,非关键层使用INT8,这是一种折中方案,但增加了开发复杂度。
据统计,多数情况下,经过良好量化的7B模型在NPU上的精度损失控制在3%以内,对于日常对话、代码生成等任务影响不大,但在高精度数学推理上仍需谨慎。
主流平台对比与选型建议
选择NPU方案时,不能一概而论,不同平台在性能、开发难度和成本上差异巨大。
移动端NPU vs 桌面/服务器NPU
| 特性 | 移动端NPU (如骁龙、天玑) | 桌面/服务器NPU (如华为昇腾、寒武纪) |
|---|---|---|
| 典型算力 | 10-50 TOPS | 200-1000+ TOPS |
| 内存带宽 | 受限,依赖LPDDR | 高带宽HBM,数据吞吐快 |
| 适用模型 | 1B-7B参数,高度量化 | 13B-70B+参数,低量化或半精度 |
| 开发门槛 | 高,需适配特定SDK | 中高,需熟悉特定硬件指令 |
| 功耗限制 | 严格,需考虑散热 | 宽松,主要考虑电费与散热成本 |

如何选择合适的NPU方案
如果你关注大模型NPU推理性价比,需要根据自身需求对号入座:
- 个人开发者/极客:推荐尝试基于NPU的开源项目,如利用LLM.cpp配合特定NPU后端,虽然配置繁琐,但能深入理解底层原理。
- 企业级应用:若追求稳定性,华为昇腾(Ascend)系列在国内生态较为完善,提供从芯片到MindSpore框架的全栈支持,适合国产大模型硬件加速场景。
- 消费电子厂商:高通和联发科提供成熟的SDK,适合集成到手机、平板或IoT设备中,重点在于功耗控制和用户体验。
实操指南:如何开始NPU大模型推理
对于想要动手尝试的用户,以下是一个通用的技术路径,以Linux环境下的NPU开发为例。
环境准备
- 安装NPU驱动:确保内核模块已加载,使用
ls /dev/davinci检查设备节点是否存在。 - 安装CANN或对应SDK:这是连接应用程序与NPU硬件的桥梁,必须版本匹配。
- 验证环境:运行厂商提供的sample代码,确保“Hello World”能正常在NPU上执行。
模型转换
- 导出ONNX:使用Hugging Face库将PyTorch模型导出为ONNX格式。
- 模型量化:使用工具将模型权重转换为INT8,并生成校准数据集。
- 编译模型:使用ATC(Ascend Tensor Compiler)或等效工具,将ONNX转换为NPU可执行的.om或.bin文件。
推理部署
- 加载模型:在应用中初始化NPU上下文,加载编译好的模型文件。
- 数据预处理:将输入文本转换为Token ID,并进行Padding对齐。
- 执行推理:调用NPU API进行前向传播,获取输出Tensor。
- 后处理:将输出Token解码为自然语言文本。

常见问题排查
- 内存溢出:检查NPU内部RAM是否足够,必要时启用外部DDR作为缓存。
- 速度缓慢:确认是否发生了算子回退,使用性能分析工具查看瓶颈所在。
- 精度异常:检查量化校准数据集是否具有代表性,重新进行量化训练。
大模型NPU推理常见问题解答
大模型NPU推理延迟如何优化?
优化延迟主要依靠减少内存搬运和流水线并行,使用KV Cache技术缓存历史上下文,避免重复计算;采用Continuous Batching技术,将多个请求合并处理,提高NPU利用率;确保输入数据格式与NPU硬件对齐,减少数据转换开销。
NPU相比GPU在大模型推理中有哪些劣势?
NPU的主要劣势在于通用性和生态,GPU拥有CUDA这一行业标准,几乎所有主流大模型框架都原生支持,而NPU通常需要专用的转换工具和驱动,迁移成本高,NPU对动态形状(Dynamic Shape)的支持较差,处理变长输入时效率可能下降,需要预先分配固定大小的内存。
未来NPU会取代GPU成为大模型主流吗?
短期内不会完全取代,而是形成互补格局,GPU将继续主导训练和高精度推理市场,特别是在云端数据中心,NPU则在端侧、边缘计算和特定垂直领域(如安防、车载)占据主导,随着存算一体技术和新型非易失性存储的发展,NPU在能效比上的优势将进一步扩大,成为AI普及的关键基础设施。
大模型推理使用NPU不仅是可行的,而且在特定场景下是更优解,关键在于理解其硬件特性,选择合适的量化策略,并投入必要的精力进行生态适配,对于追求极致能效和实时响应的应用,NPU无疑是值得深入探索的技术方向。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/410042.html