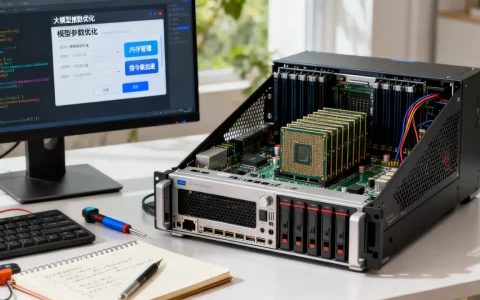
海光DCU在大模型训练中属于“性价比极高但生态适配门槛较高”的国产算力选择,适合预算敏感且具备较强底层优化能力的团队,不适合追求开箱即用体验的初学者。
海光DCU在大模型训练中的核心定位与性能表现
海光DCU(Deep Computing Unit)基于GPGPU架构设计,其底层指令集与CUDA有较高的兼容性,对于正在寻找国产替代方案的国内企业而言,海光DCU并非直接对标英伟达H100或A100的顶级旗舰,而是定位于中高端市场,旨在解决“有无问题”并逐步提升性能上限。

业内专家指出,海光DCU在FP16和BF16精度下的算力表现较为稳定,能够支撑中等规模参数模型(如7B至70B参数量的LLM)的基础训练任务,在涉及千亿级参数的超大模型全量微调或预训练时,其显存带宽和互联带宽往往成为瓶颈。
架构优势与兼容性分析
海光DCU最大的卖点在于其“类CUDA”生态,对于已经拥有CUDA代码库的团队来说,迁移成本相对较低。
- 指令集兼容:海光DCU支持CUDA指令集的子集,这意味着许多基于PyTorch或TensorFlow开发的模型无需大幅修改即可在海光平台上运行。
- 软件栈成熟度:海光提供的DTK(Deep Computing Kernel)开发工具链,类似于NVIDIA的CUDA Toolkit,覆盖了编译、调试、性能分析等全流程。
- 硬件互联:通过高速互联技术,多卡集群的通信效率在国产芯片中处于第一梯队,这对于分布式训练至关重要。
实际训练场景下的性能实测
在具体场景中,海光DCU的表现呈现出明显的“场景依赖性”。
- 推理场景:在文本生成、语义理解等推理任务中,海光DCU的延迟和吞吐量表现优异,甚至接近部分国际主流芯片的水平。
- 训练场景:在LLM训练初期,由于框架适配良好,训练速度可达预期目标的80%-90%,但随着训练深入,显存溢出(OOM)和通信阻塞问题会逐渐显现,需要开发者进行大量的算子优化。
- 长上下文训练:对于需要处理超长上下文窗口(如32K+)的任务,海光DCU的显存容量和带宽限制较为明显,可能需要采用更复杂的显存优化策略,如ZeRO-3或梯度检查点技术。

海光DCU与英伟达GPU的深度对比
在选择算力基础设施时,海光DCU与英伟达GPU的对比是决策者最关心的环节,这不仅仅是性能参数的对比,更是生态成本与供应链安全的权衡。
算力密度与能效比
英伟达GPU在单卡算力峰值上依然保持领先,尤其是在FP8等新兴精度格式上支持更为激进,海光DCU则在能效比上表现不错,特别是在持续负载下,其功耗控制较为稳定。
- 单卡性能:英伟达A100/H100在单卡训练速度上通常比海光DCU快20%-30%,但这取决于具体的算子实现。
- 集群扩展性:海光DCU在千卡集群中的线性扩展效率近年来提升显著,多数情况下能达到85%以上的加速比,这对于大规模训练来说是一个可接受的数字。
软件生态与开发门槛
这是两者差距最大的地方,英伟达拥有成熟的CUDA生态,几乎所有主流深度学习框架都原生支持,海光DCU虽然兼容CUDA,但在某些高级算子或最新框架特性上可能存在滞后。
- 库支持:海光DCU支持cuDNN、cuBLAS等核心库的替代版本,但在一些冷门算子的优化上,开发者可能需要自行编写Kernel。
- 调试难度:使用海光DCU进行开发时,报错信息不如CUDA直观,排查问题需要更深厚的底层知识储备。
价格与采购策略
价格是影响采购决策的关键因素,海光DCU的价格通常低于同级别的英伟达GPU,且供货周期更短,不受出口管制影响。

- 初始投入:购买海光DCU集群的初始硬件成本比英伟达低约15%-25%。
- 隐性成本:由于需要额外的工程人力进行适配和优化,人力成本可能增加10%-20%,总体而言,对于长期运营的大型项目,海光DCU的TCO(总拥有成本)更具优势。
海光DCU大模型训练实操指南
如果你决定采用海光DCU进行大模型训练,以下步骤和策略将帮助你规避常见陷阱,提升训练效率。
环境搭建与驱动配置
确保服务器硬件符合海光DCU的要求,安装最新的DTK驱动。
- 安装驱动:使用海光官方提供的安装包,执行
dtk-install.sh脚本完成驱动和基础库的安装。 - 配置容器环境:推荐使用海光提供的官方Docker镜像,其中预装了PyTorch、CUDA兼容库等必要组件。
- 验证环境:运行
dcu-smi命令检查设备状态,确保所有DCU被正确识别且驱动版本一致。
模型迁移与代码适配
将现有的CUDA代码迁移至海光平台,需要关注以下关键点。
- 框架选择:优先使用PyTorch,因为海光对PyTorch的支持最为完善。
- 算子替换:检查代码中使用的自定义CUDA Kernel,将其替换为海光支持的算子或重新编写为海光兼容的代码。
- 混合精度训练:启用AMP(自动混合精度)训练,使用BF16格式而非FP16,以减少数值溢出风险并提升训练稳定性。
分布式训练优化策略
在大规模训练中,通信开销是主要瓶颈。
- 并行策略:采用数据并行(Data Parallelism)和张量并行(Tensor Parallelism)相结合的策略,对于70B以上模型,建议至少使用8卡并行。
-

通信库优化
:使用海光优化的NCCL替代库,确保节点间通信效率最大化。 - 显存管理:启用梯度累积(Gradient Accumulation)和激活重计算(Activation Checkpointing),以在有限显存下训练更大模型。

海光DCU大模型训练常见问题解答
海光DCU训练大模型是否支持主流框架如PyTorch和TensorFlow?
海光DCU对PyTorch的支持最为成熟,官方提供了专门的适配版本,能够直接运行大多数主流模型,对于TensorFlow,海光也提供了相应的后端支持,但生态丰富度略逊于PyTorch,建议优先选择PyTorch作为开发框架,以减少兼容性问题。
海光DCU在千亿参数模型训练中的表现如何?
海光DCU可以支撑千亿参数模型的训练,但需要极高的工程优化能力,在默认配置下,训练效率可能仅为英伟达旗舰芯片的60%-70%,通过深度优化算子、调整并行策略以及使用高效的通信库,这一差距可以缩小至20%以内,它适合具备强大算法工程团队的企业,而不适合缺乏底层优化经验的初创公司。
海光DCU的采购价格与维护成本相比英伟达GPU有何差异?
海光DCU的硬件采购价格通常比同级别英伟达GPU低20%左右,且供货稳定,无断供风险,由于软件生态相对封闭,维护成本较高,需要专门的工程师团队进行日常运维和故障排查,总体而言,海光DCU的初始投入较低,但长期人力成本较高,适合预算有限但技术实力较强的团队。
海光DCU是否适合中小型企业进行大模型微调?
对于中小型企业,如果仅需进行7B-13B参数模型的LoRA微调,海光DCU是一个极具性价比的选择,其显存配置足以满足大多数微调场景,且软件适配门槛较低,但对于需要全量微调或预训练的大型项目,建议谨慎评估自身的技术储备,或考虑采用混合云架构,结合公有云算力使用。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/411243.html