本地MySQL数据库导入与模型转换的核心在于通过命令行工具或可视化工具将本地数据文件精准映射至目标环境,关键在于解决字符集兼容、表结构差异及大数据量下的性能瓶颈问题。
在本地开发向测试或生产环境迁移的过程中,数据迁移往往是最容易踩坑的环节,很多开发者习惯直接复制文件夹,但这在MySQL中是绝对禁止的操作,因为会导致数据字典不一致,正确的做法是利用逻辑备份或物理备份工具,结合特定的转换策略,确保数据在跨环境流动时的完整性与一致性。

本地MySQL导入数据库的常见场景与痛点
数据迁移并非简单的“复制粘贴”,它通常发生在几个特定的业务场景中,理解这些场景有助于选择最合适的导入方式。
开发环境同步至测试环境
这是最高频的场景,开发人员本地修改了表结构或插入了测试数据,需要将这些变更同步到测试服务器,痛点在于表结构差异,如果本地使用了测试环境不支持的字段类型,或者索引命名冲突,直接导入会导致失败,业内专家指出,多数情况下,这种失败源于字符集设置不一致,例如本地使用utf8mb4,而测试库默认为utf8,导致特殊字符乱码或截断。
旧系统数据迁移至新架构
当企业升级系统时,往往涉及从旧版MySQL甚至其他数据库(如Oracle、SQL Server)迁移数据,这种场景下,核心痛点是数据类型转换,旧系统的日期格式可能是字符串,而新系统要求标准的DATETIME类型,存储过程、触发器等非标准SQL对象的兼容性也是重大挑战。
本地模型转换与格式标准化

有时我们需要将本地导出的CSV、Excel或JSON数据转换为标准的SQL插入语句,或者将非关系型数据导入MySQL,这种“导入/转换本地开发模型”的需求,重点在于数据清洗,原始数据往往包含空值、重复项或格式错误,直接导入会破坏数据库的完整性约束。
核心操作指南:高效导入与转换策略
针对上述场景,我们提供三种主流且经过验证的操作路径,请根据数据量和环境复杂度选择。
使用mysqldump进行逻辑备份与恢复
这是最通用、兼容性最好的方法,适合中小规模数据(通常小于10GB)。
步骤详解
-
导出本地数据:在本地终端执行命令,生成包含建表语句和插入语句的SQL文件。
mysqldump -u username -p --default-character-set=utf8mb4 database_name > backup.sql
关键参数说明
`–default-character-set=utf8mb4`:确保字符集一致,避免乱码。
`–single-transaction`:对于InnoDB引擎,保证数据一致性,不影响正在运行的查询。 导入目标数据库:在目标服务器执行导入。
mysql -u username -p --default-character-set=utf8mb4 target_database < backup.sql
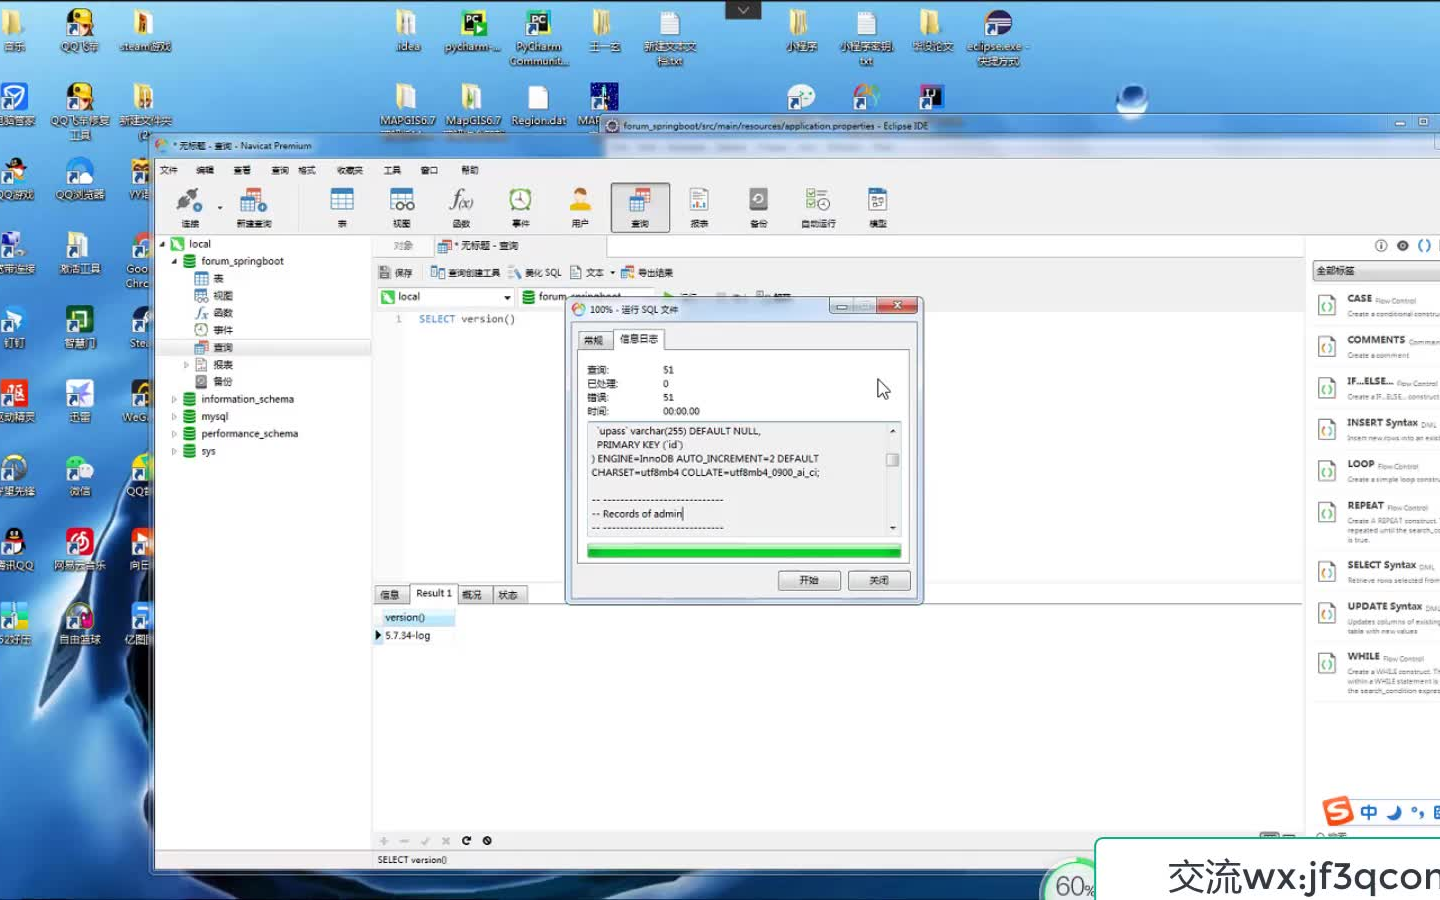
使用Navicat或DBeaver等可视化工具
对于不熟悉命令行的开发者,可视化工具提供了图形化的“数据传输”功能。
操作路径
- 打开工具,建立本地与远程服务器的连接。
- 选择“工具”菜单下的“数据传输”或“同步数据库”。
- 设置源数据库(本地)和目标数据库(远程)。
- 勾选“跳过错误”选项:在开发阶段,这可以允许导入继续,但会记录错误日志。
- 执行同步。

优缺点分析
- 优点:界面直观,支持实时预览差异,适合小批量数据。
- 缺点:内存占用高,处理百万级以上数据时容易卡死或超时。
使用mysqlimport或LOAD DATA INFILE处理CSV/Excel
当数据以CSV格式存在时,这是速度最快的方法,适合大规模数据导入。
预处理数据
确保CSV文件编码为UTF-8,且字段分隔符与MySQL期望的一致(默认为制表符或逗号)。
执行导入命令
LOAD DATA INFILE '/path/to/file.csv'
INTO TABLE table_name
FIELDS TERMINATED BY ','
ENCLOSED BY '"'
LINES TERMINATED BY 'n'
IGNORE 1 ROWS;
注意事项
- 文件路径必须是服务器可访问的路径,而非本地路径。
- 需确保MySQL用户拥有
FILE权限。 IGNORE 1 ROWS用于跳过CSV文件的第一行标题行。
常见错误排查与性能优化
在导入过程中,遇到错误是常态,以下是高频问题的解决方案。
字符集冲突导致乱码
如果导入后中文显示为问号或乱码,首先检查数据库、表、字段的字符集是否统一为utf8mb4。
SHOW CREATE TABLE table_name;
如果字符集不一致,需修改表结构:
ALTER TABLE table_name CONVERT TO CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;
外键约束导致导入失败

在导入大量数据时,外键检查会显著降低速度,甚至导致死锁,建议在导入前临时关闭外键检查。
SET FOREIGN_KEY_CHECKS = 0;
-- 执行导入操作
SET FOREIGN_KEY_CHECKS = 1;
大数据量导入的性能瓶颈
对于超过10GB的数据,逻辑备份(mysqldump)可能耗时过长,此时建议采用物理备份工具(如Percona XtraBackup)或分批次导入。
- 分批次导入:将大表拆分为多个小文件,分别导入,避免单次事务过大。
- 调整参数:临时增加
innodb_buffer_pool_size和max_allowed_packet参数,提升内存分配和包大小限制。
Q&A:本地MySQL导入数据库_导入/转换本地开发模型常见问题
如何将Excel数据快速导入MySQL?
首先将Excel保存为CSV格式,确保编码为UTF-8,然后使用LOAD DATA INFILE命令或可视化工具的数据导入功能,若数据量较小,也可通过Python脚本读取Excel并生成INSERT语句。
导入时遇到“Packet too large”错误怎么办?
该错误表示单条数据包超过服务器限制,需修改MySQL配置文件my.cnf或my.ini,增加max_allowed_packet的值(如设置为64M或128M),并重启MySQL服务生效。
本地MySQL导入数据库_导入/转换本地开发模型时,如何处理自增ID冲突?
在导入包含自增ID的数据时,需确保目标表的自增起始值大于导入数据中的最大ID,可在导入前执行ALTER TABLE table_name AUTO_INCREMENT = max_id + 1;,或在导入时忽略自增列,让数据库自动生成新ID。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/449093.html