Python中读取大文件的标准做法是使用内置的open()函数配合迭代器,而非一次性加载到内存,这样既能避免内存溢出,又能保持代码简洁高效。
很多初学者在接触Python文件操作时,往往习惯性地使用read()或readlines()方法,试图把整个文件内容一股脑塞进内存变量里,这种做法在处理几KB的小文本时确实没问题,但一旦面对几百MB甚至GB级别的数据日志或CSV文件,程序瞬间就会因为内存不足(Memory Error)而崩溃,业内专家指出,正确的文件读取思路应当是“流式处理”,即像水流一样,只处理当前流经的那一部分数据,处理完就释放,不占用后续空间。
为什么避免使用readlines()读取大文件
readlines()方法的核心问题在于它会将文件的所有行一次性读取到一个列表中,这意味着,如果一个1GB的文本文件有1000万行,Python就需要在内存中创建一个包含1000万个字符串对象的列表,这不仅消耗巨大的内存资源,还会因为频繁的内存分配和垃圾回收机制导致程序运行缓慢。
内存占用对比分析
为了直观理解这一差异,我们可以对比两种常见读取方式在内存中的表现:
| 方法 | 操作逻辑 | 内存占用特征 | 适用场景 |
|---|---|---|---|
f.read() |
一次性读取全部内容为字符串 | 极高,随文件大小线性增长 | 小文件(<10MB) |
f.readlines() |
一次性读取所有行为列表 | 高,列表开销+字符串开销 | 中等文件,需随机访问行 |
for line in f |
逐行迭代,惰性读取 | 极低,仅保留当前行内存 | 大文件处理首选 |

从表格可以看出,使用迭代器方式读取文件时,无论文件多大,内存占用始终维持在一个极低的水平,因为它只缓存当前正在处理的那一行数据,这种机制被称为“惰性求值”,是Python处理大数据流的基石。
高效读取大文件的实操方案
在实际开发中,面对不同格式和规模的数据,我们需要选择最合适的读取策略,以下是几种经过验证的高效读取路径,涵盖了从纯文本到结构化数据的常见场景。
基础文本文件的逐行遍历
这是最基础也是最推荐的读取方式,通过直接迭代文件对象,Python会自动处理缓冲区和换行符,无需手动管理文件指针。
# 推荐写法:上下文管理器 + 迭代器
with open('large_file.log', 'r', encoding='utf-8') as f:
    for line in f:
        # 处理每一行数据
        process(line.strip())
这里有两个关键点需要注意,务必使用with语句,它能确保即使处理过程中发生异常,文件资源也会被正确关闭,防止文件句柄泄露。encoding='utf-8'参数必须显式指定,虽然Windows系统默认可能是GBK,但在跨平台协作或处理网络数据时,显式声明编码格式能避免绝大多数乱码问题,这是许多新手容易踩坑的地方。
处理超大文件的分块读取
如果文件不仅仅是文本,而是二进制数据(如图片、视频或自定义二进制协议),逐行读取就失效了,此时应采用分块读取(Chunking)策略,通过指定read(size)中的字节数,可以控制每次从磁盘读取的数据量。
chunk_size = 1024  1024  # 每次读取1MB
with open('large_binary.bin', 'rb') as f:
    while True:
        chunk = f.read(chunk_size)
        if not chunk:
            break
        process_binary_data(chunk)

这种模式在日志分析、数据清洗和ETL(抽取、转换、加载)流程中极为常见,通过调整chunk_size的大小,可以在I/O等待时间和CPU处理效率之间找到平衡点。
结构化数据的高效解析
当处理CSV或JSON等结构化数据时,单纯的文件读取往往不够,还需要结合专门的库来提升性能。
CSV文件的优化读取
对于CSV文件,Python内置的csv模块虽然稳定,但在处理百万行以上数据时速度较慢,使用pandas库是更优的选择,尤其是当需要进行数据筛选和聚合时。
import pandas as pd
# 使用chunksize参数实现分块读取,避免内存溢出
chunk_iter = pd.read_csv('data.csv', chunksize=10000)
for chunk in chunk_iter:
    # 对每个数据块进行处理
    filtered_data = chunk[chunk['status'] == 'active']
    aggregate_results(filtered_data)
这种分块读取CSV的方法,完美解决了“python读取大csv文件内存不足”这一常见痛点,它允许开发者以处理小数据集的方式,去处理超大规模数据集,极大地降低了开发门槛。
JSON数据的流式解析
JSON数据通常结构嵌套,标准库json.load()同样会将整个文件加载到内存,对于大型JSON文件,建议使用ijson库进行流式解析。
import ijson
# 流式解析JSON数组中的对象
with open('large_data.json', 'rb') as f:
    objects = ijson.items(f, 'item')
    for obj in objects:
        handle_object(obj)
ijson通过生成器的方式,逐个产出JSON对象,使得内存占用与文件大小解耦,这对于处理API返回的大规模数据集或大型配置文件至关重要。
常见误区与性能优化技巧
在掌握了基本读取方法后,还有一些细节决定了程序的最终性能。
缓冲区的合理设置
Python的文件操作默认使用缓冲机制,即先写入内存缓冲区,达到一定大小后再刷入磁盘,对于读取操作,虽然影响较小,但在高频小文件读取场景下,调整缓冲区大小可能带来细微的性能提升,对于绝大多数应用场景,默认缓冲区已经足够优化,无需过度干预。

编码转换的开销
在读取非UTF-8编码的文件时,Python会在内存中进行编码转换,如果文件极大且编码复杂,这部分CPU开销不容忽视,如果可能,建议在数据源头统一使用UTF-8编码,或者在读取后尽快将数据转换为所需的内部表示,减少重复转换的次数。
并行读取的局限性
有些开发者会尝试使用多线程或多进程并行读取文件的不同部分,由于磁盘I/O通常是瓶颈,且文件读取顺序往往有依赖关系,并行读取在大多数单文件场景下并不能显著提升速度,反而增加了线程同步的复杂性,只有在处理多个独立小文件时,并行读取才具有明显的性能优势。
Python readline 常见问题解答
Python readline 和 readlines 有什么区别
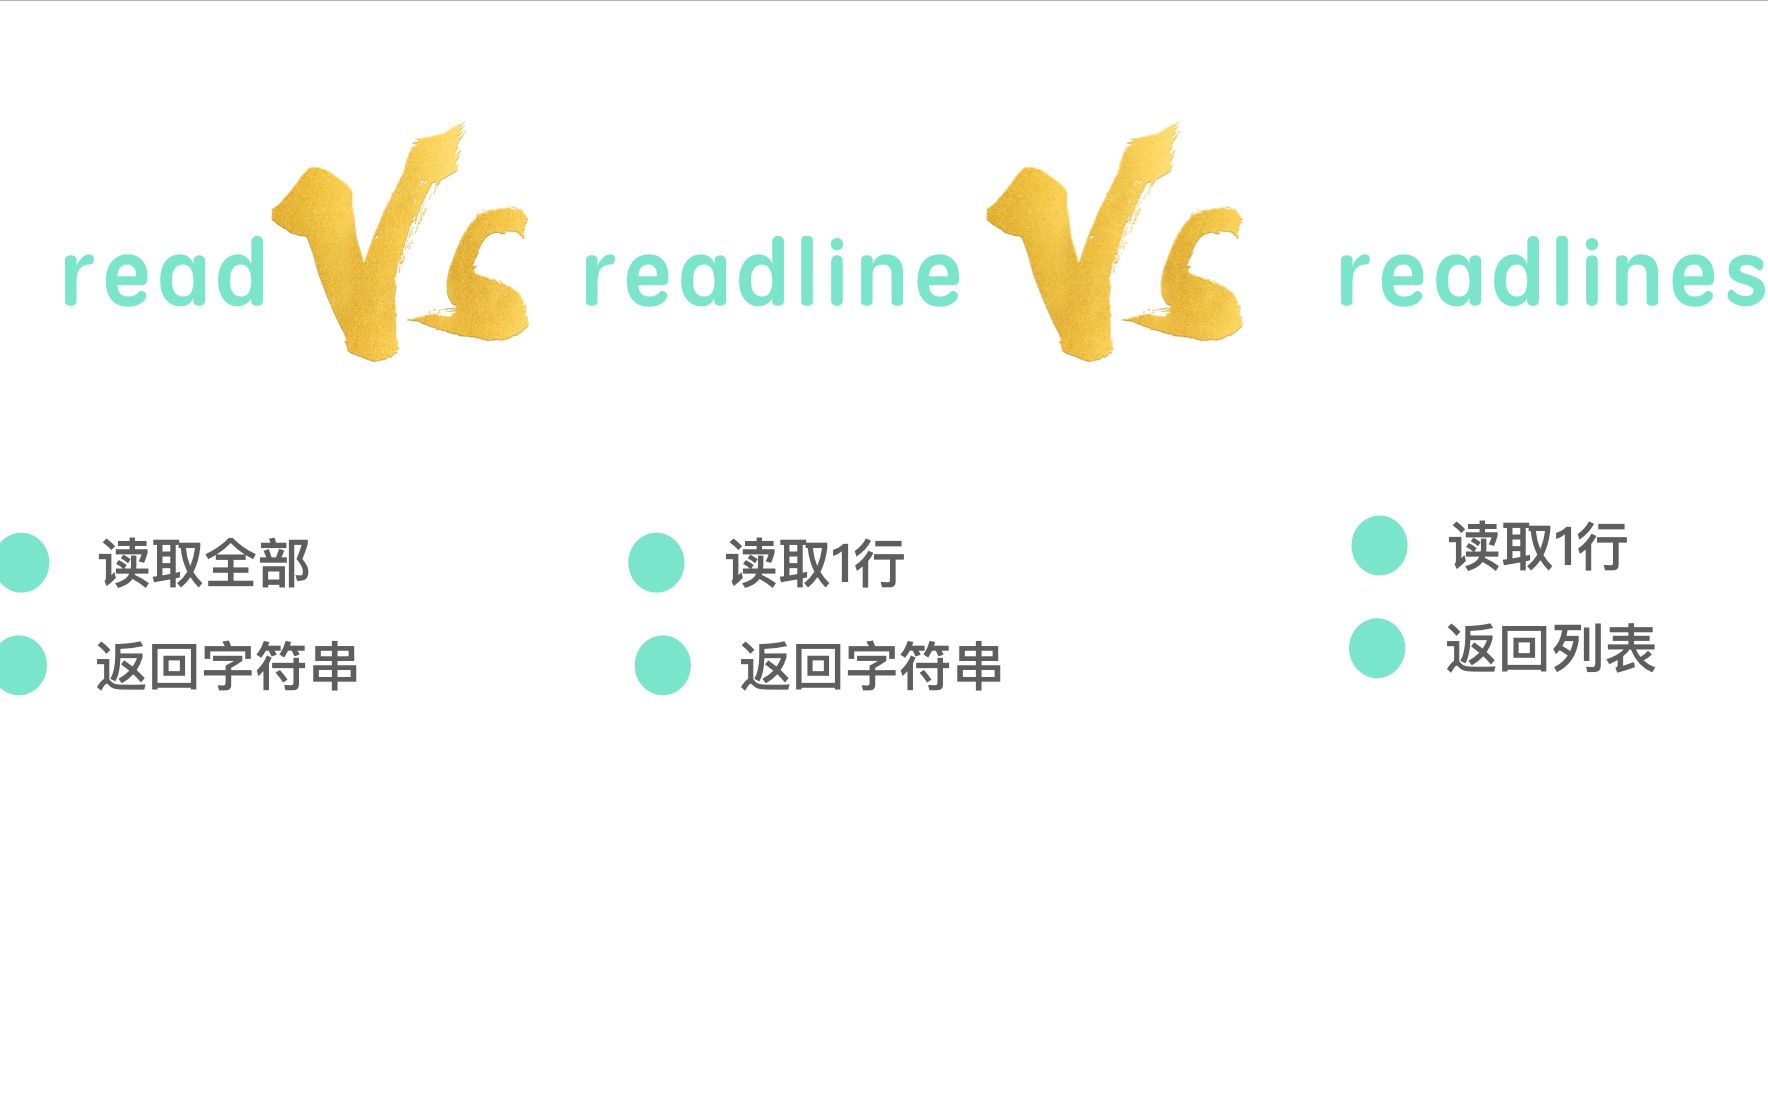
readline()每次只读取文件中的一行,返回一个字符串,适合逐行处理;而readlines()一次性读取所有行,返回一个字符串列表,前者内存占用极低,适合大文件;后者便于随机访问,但仅适合小文件。
Python读取大文件速度慢怎么办
首先检查是否使用了低效的字符串拼接,应使用列表收集后join,确保使用了正确的编码格式,避免隐式转换,如果涉及复杂的数据清洗,考虑使用pandas或numpy等优化过的库,它们底层由C语言实现,速度远快于纯Python循环。
如何判断文件是否读取完毕
在迭代文件对象时,循环会自动在文件末尾终止,无需手动判断,如果使用readline()方法,当返回空字符串时,表示文件已读取完毕,这是Python文件对象的标准行为,适用于所有文本和二进制文件。
掌握这些核心技巧,不仅能解决“python读取大文件报错”的问题,更能写出健壮、高效的生产级代码,处理数据时,永远优先考虑内存效率,让程序像流水一样轻盈地穿过数据洪流。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/460823.html