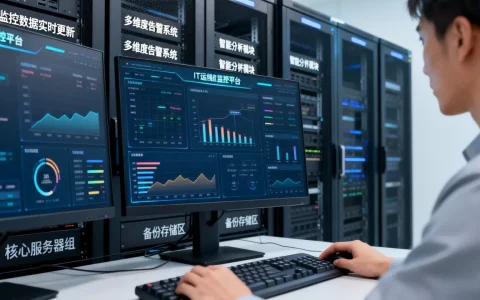
服务器集群通过分布式架构实现大数据处理,其核心优势在于利用多台廉价服务器协同工作,以较低成本获得超越单台高性能服务器的算力与容错能力。
为什么大数据时代必须依赖服务器集群?
在处理海量数据时,单机性能早已触及物理天花板,无论是日志分析、用户行为追踪,还是实时推荐算法,数据量往往以PB甚至EB为单位增长,单台服务器即便配置了顶级CPU和内存,面对并发请求和复杂计算时,依然显得力不从心,服务器集群成为必然选择。

业内专家指出,分布式计算框架(如Hadoop、Spark)的设计初衷就是为了解决单机无法承载的计算压力,集群并非简单的机器堆砌,而是一个逻辑上的整体,数据被切分成小块,分散存储在不同节点上,计算任务也随之分发,这种“分而治之”的策略,让处理速度呈线性增长。
单机与集群的性能对比
为了更直观地理解差异,我们可以对比两种架构在典型场景下的表现。
| 维度 | 单机高性能服务器 | 服务器集群(10节点) |
|---|---|---|
| 存储扩展性 | 受限于硬盘插槽,扩容成本高 | 动态增加节点,存储能力线性增长 |
| 计算吞吐量 | 受限于单CPU核心数,易成瓶颈 | 多核并行处理,吞吐量大幅提升 |
| 容错能力 | 单点故障导致业务完全中断 | 节点故障自动切换,业务无感知 |
| 初始投入 | 高,需购买高端硬件 | 相对较低,可使用通用商用硬件 |
多数情况下,企业选择集群并非因为预算充足,而是因为业务规模倒逼技术升级,当数据量超过单机处理极限时,集群是唯一可行的解决方案。

服务器集群构建的关键技术架构
构建一个高效的大数据处理集群,需要理解其底层逻辑,这不仅仅是购买硬件,更是软件栈的精心编排。
数据存储层:HDFS与分布式文件系统
数据是集群的血液,Hadoop分布式文件系统(HDFS)是许多大数据集群的基础,它将大文件切分为块(Block),默认大小为128MB或256MB,并分散存储在不同节点上,每个数据块通常会有多个副本(默认3份),分布在不同的机架或节点上,以确保数据不丢失。
数据块管理实操
在实际操作中,管理员需要关注NameNode和DataNode的角色分工,NameNode负责管理文件系统的元数据,如文件目录结构、权限信息以及数据块的位置映射,DataNode则负责实际存储数据块,并定期向NameNode汇报心跳状态,如果某个DataNode失效,NameNode会检测到心跳丢失,并自动在其他节点上重新复制丢失的数据块,确保副本数量达标。
计算资源层:YARN与资源调度
有了存储,还需要计算引擎,YARN(Yet Another Resource Negotiator)是Hadoop 2.0引入的资源调度框架,它将资源管理和作业调度/监控分离,使得集群可以同时运行MapReduce、Spark、Flink等多种计算框架。
资源调度策略
YARN支持多种调度策略,常见的包括FIFO(先进先出)、Capacity Scheduler(容量调度)和Fair Scheduler(公平调度),对于多租户环境,公平调度器更为常用,它能确保每个用户或应用都能获得公平的资源份额,避免某个大型任务独占所有资源,导致其他任务饥饿。
服务器集群运维中的常见挑战与应对
集群规模越大,运维复杂度呈指数级上升,硬件故障、网络延迟、数据倾斜等问题频发,需要专业的运维策略。
硬件故障与数据恢复
在大型集群中,硬盘故障是常态,据统计,硬盘故障率随时间推移而增加,集群必须具备自动故障检测和数据重建能力。

故障检测机制
集群通过心跳机制监控节点状态,如果DataNode在规定时间内未发送心跳,NameNode将其标记为死亡,随后,集群会启动数据重建流程,从其他副本节点复制数据到新的健康节点,这一过程对上层应用透明,用户无需干预。
数据倾斜问题
数据倾斜是指某些Reduce任务处理的数据量远大于其他任务,导致整体作业等待慢节点完成,这通常发生在Key分布不均时。
优化建议
解决数据倾斜的方法包括:
- 加盐处理:在Key前添加随机前缀,将热点Key分散到不同Reduce节点。
- 二次聚合:先进行局部聚合,再进行全局聚合,减少Shuffle数据量。
- 调整并行度:增加Reduce任务数量,分散负载。
如何选择适合企业的服务器集群方案?
面对市场上琳琅满目的解决方案,企业需要根据自身需求做出选择,是自建集群,还是采用云服务?
自建集群 vs 公有云大数据服务
对于数据敏感度高、拥有专业运维团队的大型企业,自建集群可能更具成本效益和控制力,自建集群需要投入大量人力进行硬件采购、网络配置、软件部署和日常维护。
相比之下,公有云大数据服务(如简米云MaxCompute、酷番云TBDS)提供了开箱即用的解决方案,用户无需关心底层硬件,只需关注数据分析和业务逻辑。
成本考量因素
在评估成本时,不能仅看硬件采购费用,还需考虑:
- 电力与机房成本:服务器集群耗电巨大,机房制冷和电力保障成本不容忽视。
- 人力成本:需要专业的系统管理员、DBA和运维工程师。
- 机会成本:自建集群的建设周期长,可能延误业务上线时机。
对于大多数中小企业,公有云服务是更明智的选择,它提供了弹性伸缩能力,业务高峰时自动增加节点,低谷时释放资源,按需付费,极大降低了初期投入风险。
未来趋势:云原生与AI融合
随着技术演进,服务器集群正在向云原生和智能化方向发展。

云原生大数据
容器化技术(如Kubernetes)正在重塑大数据集群的部署方式,通过K8s管理大数据组件,可以实现更细粒度的资源隔离、快速扩缩容和自动化运维,云原生架构使得大数据平台更加灵活,能够无缝对接各种微服务应用。
AI赋能集群管理
人工智能技术也开始应用于集群运维,通过机器学习算法,系统可以预测硬件故障,提前预警潜在风险,智能调度器可以根据任务特征和历史数据,自动优化资源分配策略,提升整体集群效率。
Q&A:服务器集群 大数据常见疑问
服务器集群 大数据 价格 是多少?
服务器集群的大数据价格没有固定标准,取决于规模、配置和服务模式,自建集群初期投入较高,包括服务器硬件、网络设备、存储设备及软件授权费用,后期还需承担电力、机房租赁和人力成本,若采用公有云服务,通常按计算资源(vCPU/内存)和存储量计费,起步门槛低,适合中小企业,大型企业若数据量极大且长期稳定,自建集群的单位成本可能更低,建议根据业务数据量和增长预期进行详细测算。
服务器集群 大数据 地域 选择有影响吗?
有显著影响,数据延迟和合规性是主要考量因素,若用户群体集中在特定地区,将集群部署在就近的数据中心可减少网络延迟,提升用户体验,不同地区的数据隐私法规不同,如欧盟的GDPR或中国的《数据安全法》,要求数据存储在特定司法管辖区内,企业需根据目标市场和法律要求选择合适的数据中心地域。
如何评估服务器集群 大数据 性能?
评估集群性能需关注多个指标,吞吐量(Throughput)反映单位时间内处理的数据量,延迟(Latency)指任务完成所需时间,在Hadoop生态中,可使用TeraSort等基准测试工具进行标准化测试,需监控资源利用率,如CPU、内存、网络I/O和磁盘I/O,若资源长期闲置或过载,均需调整集群配置,性能优化是一个持续过程,需结合具体业务场景进行调优。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/483789.html