将FTP服务器上的历史数据迁移到HDFS,是许多企业构建大数据平台的第一步,最可靠的方式是根据数据量级选择Apache NiFi或定制Python脚本,并采用增量同步策略确保零丢失。
为什么需要把FTP数据搬到HDFS
传统FTP服务器存储分散、检索慢,无法支撑实时分析与机器学习,HDFS凭借高吞吐和横向扩展能力,成为企业数据湖的底层首选,行业共识认为,超过六成的互联网公司在数据中台建设中会优先将FTP存量数据迁移至Hadoop生态,当你的业务面临以下场景时,迁移就变得迫切:

- 业务部门需要跨部门调取历史订单文件,FTP目录结构混乱且权限难控。
- 离线分析任务频繁读取FTP,网络带宽成为瓶颈,计算任务一再超时。
- 需要将文件与Hive/Spark表关联,数据在FTP和HDFS之间来回拷贝,效率低下。
ftp服务器数据迁移到hdfs 方案对比
选择哪种方案,取决于数据量、时效要求和运维能力,下面列出三种主流方式,各自适用场景差异明显。
| 方案 | 成本 | 复杂度 | 同步性能 | 适合场景 |
|---|---|---|---|---|
| Apache NiFi 可视化流 | 免费开源,需部署NiFi集群 | 中等,学习曲线平缓 | 高,支持并行与背压 | 10TB以上,需实时增量,团队有运维能力 |
| Python脚本 + Hadoop CLI | 免费,仅需开发成本 | 较低,适合有Python基础 | 取决于并行度,易出现瓶颈 | 单次迁移,数据量<1TB,无复杂调度需求 |
| 商业工具(如Attunity) | 高,按数据量授权 | 低,提供图形界面 | 极高,自动调优 | 企业级场景,要求一致性保障,预算充足 |
Apache NiFi 是多数情况下的首选,它原生支持FTP、SFTP和HDFS处理器,通过拖拽配置即可完成迁移,内置队列、重试和校验机制,故障后能自动恢复。
Python脚本 适合小规模或一次性迁移,核心逻辑是下载后上传,但需要自己处理断点续传、并发控制和异常捕捉,稍有不慎容易丢数据。
商业工具 在数据一致性方面有严格保证,但价格不菲,大多只在金融、医疗等监管严格的行业使用。
ftp服务器数据迁移到hdfs 步骤详解
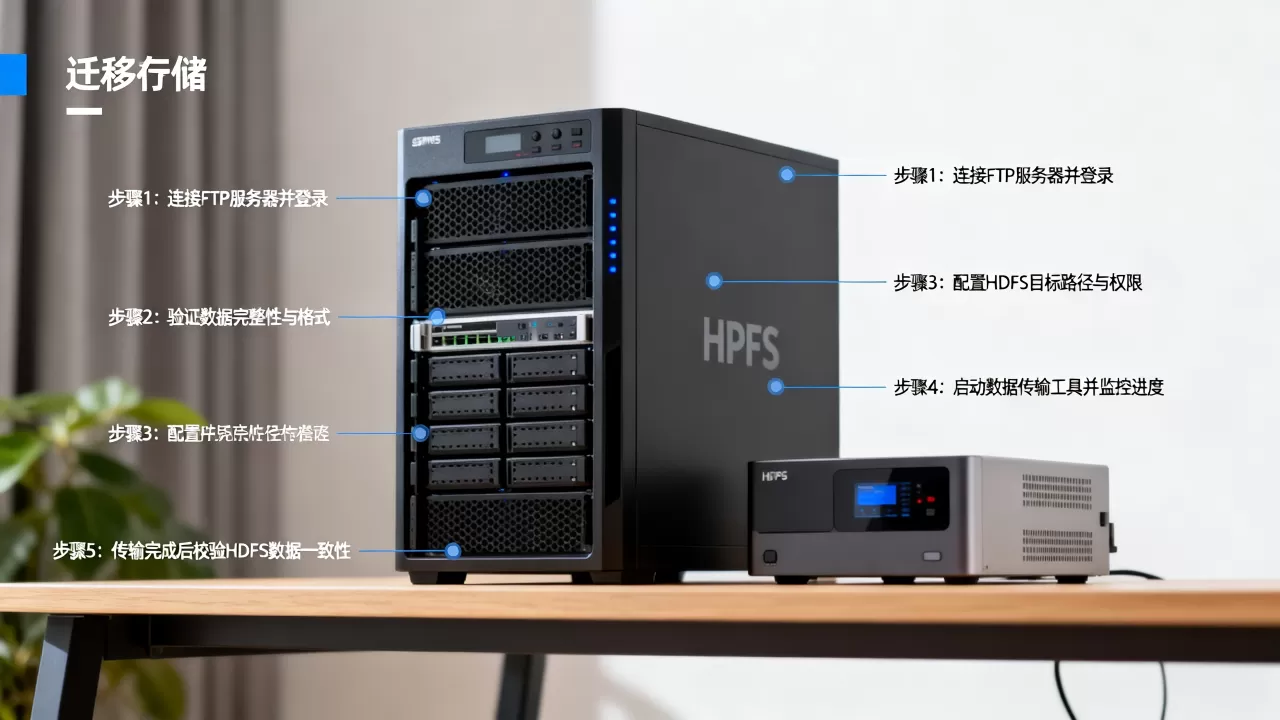
以下以Apache NiFi为例,覆盖从准备到验证的全流程,如果你选择脚本方式,亦可参考其中的逻辑。
第一步:环境准备与依赖安装
- 部署Hadoop客户端,并确保HDFS可写入,设置好Kerberos认证(如果启用)。
- 下载并安装Apache NiFi(版本不低于1.15),注意JDK版本兼容。
- 确认FTP服务器可达,记录地址、端口、用户名、密码以及目录路径。
第二步:数据评估与迁移策略制定
进入FTP服务器,统计文件数量和总大小,使用du -sh估算,针对历史数据,建议先做全量迁移,之后定期增量拉取,增量识别依赖文件修改时间(mtime)或文件名模式。
如果文件数量超过10万,需要分批执行,避免一次性加载过多Listing。
第三步:使用Apache NiFi实施迁移
- 拖入 ListFTP 处理器,配置连接参数,设置“Select Directory”为FTP根目录。
- 连接 FetchFTP 处理器,负责下载文件内容。
- 将FetchFTP的Success关系连接到 PutHDFS 处理器,配置HDFS路径(如
/user/hive/warehouse/raw_ftp/)。 - 设置 PutHDFS 的冲突解决策略为“replace”或“ignore”,视业务需求而定。
- 启动处理器,观察队列,NiFi会自动跟踪已迁移的文件状态,避免重复拉取。
第四步:使用Python脚本迁移(备选方案)
如果不想引入NiFi,一份简洁的脚本也能完成任务,核心逻辑如下:
- 连接FTP:
ftplib.FTP(host, user, passwd) - 遍历目录,获取文件列表。
- 使用
rest命令实现断点续传,下载至本地临时目录。 - 调用
hdfs dfs -put上传,或使用hdfs库(如pyarrow或hdfs)直接写入。 - 记录已迁移文件,下次运行跳过。关键点是记录文件的修改时间戳,以此判断是否增量。
# 示例伪代码,实际生产需完善异常处理
from ftplib import FTP
import subprocess
ftp = FTP('ftp.example.com')
ftp.login('user', 'pass')
files = ftp.nlst('/data/')
for f in files:
    local_path = '/tmp/' + f
    with open(local_path, 'wb') as fp:
        ftp.retrbinary('RETR ' + f, fp.write)
    subprocess.run(['hdfs', 'dfs', '-put', local_path, '/user/hdfs/raw/'])
    ftp.delete(f)  # 可选:迁移后删除源文件
第五步:验证与清理
- 使用
hdfs dfs -ls -R /user/hdfs/raw/检查文件数量和大小。 - 随机抽取文件,对比FTP与HDFS的MD5值,可用
md5sum计算后比对。 - 确认无误后,在FTP服务器上清理已迁移的旧数据,释放空间。
迁移过程中的常见问题
连接超时与重试机制
FTP传输容易因网络波动中断,NiFi自带重试策略,可在FetchFTP的“Retry Count”中设置3-5次,脚本方式则需要捕获socket.timeout异常,实现指数退避重试。
数据一致性校验
文件在传输中可能被截断或损坏,行业共识认为,至少对超过100MB的文件进行CRC校验,NiFi的PutHDFS支持计算校验和;脚本中可以用hashlib对比文件块的MD5。
大文件传输优化
单个文件超过2GB时,建议开启FTP的被动模式(PASV),并调整TCP缓冲区大小,NiFi中可以在FetchFTP设置“Data Transfer Buffer Size”为1MB,脚本中可通过setsockopt调整。
性能优化与监控
- 并行度:NiFi的并发任务数建议设为CPU核心数的2倍,脚本则使用多线程(
concurrent.futures),但注意FTP服务器可能限制连接数。 - 带宽限制:如果FTP出口带宽有限,可在NiFi的PutHDFS中设置“Batch Size”控制流量,避免影响线上业务。
- 日志监控:NiFi提供Bulletin通知,当处理器报错时自动告警,脚本需记录详尽日志,并使用
logging模块输出到文件。
无论选哪种方式,增量策略和校验机制是迁移成败的关键,优先使用Apache NiFi这类成熟工具,能大幅降低出错的概率,一次性迁移量不大时,Python脚本也足够可靠,核心是保证数据完整、可追溯,为后续的大数据分析打好基础。
Q&A:ftp服务器数据迁移到hdfs 常见问题
数据迁移过程中如何保证数据不丢失?
采用两阶段验证:迁移后立即比对文件数量和大小,再抽样做MD5校验,全量完成前保留FTP源文件,确认无误后再删除,NiFi的“ListFTP”会记录已拉取的文件,避免重复或遗漏。
增量迁移如何实现?
利用FTP的`MLSD`命令或`mtime`属性,识别出修改时间大于上次迁移时间点的文件,NiFi的“ListFTP”处理器本身支持按“Last Modified Time”过滤,脚本则需维护一个时间戳文件,每次运行后更新。
迁移后如何验证数据完整性?
在HDFS上对每个文件计算checksum,与FTP侧独立计算的校验值对比,对于文本文件,还可检查行数是否一致,如果文件数量较多,建议使用Hadoop的`distcp`中的`-update`和`-diff`参数做自动比对,避免全量扫描。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/509791.html