R语言凭借其丰富的复杂网络分析包(如igraph、tidygraph)和强大的可视化能力,已成为从生物网络到社交网络分析的主流工具,尤其适合学术研究场景下的快速验证与自定义探索。
R语言复杂网络分析包选择与对比
做复杂网络分析,第一步就是选对工具包,R语言生态里至少有几十个跟网络相关的包,但真正核心的不过几个,而且侧重点各不相同。
igraph:全栈型首选
行业共识认为,igraph是复杂网络分析领域最成熟、最全面的R包,它支持多种网络格式导入导出,内置数十种中心性计算、社区发现算法和布局功能,无论你是做无标度网络拟合,还是小世界特性检验,igraph都能直接调用,如果你只打算学一个包,igraph是最高效的选择。
tidygraph与ggraph:tidyverse用户的福音
如果你习惯用dplyr和ggplot2,tidygraph能让你用同样的语法操作网络数据,它将网络对象拆解为节点和边两个数据框,支持链式操作,配合ggraph做可视化,图层管理极其灵活,对于需要频繁清洗和转换网络数据的用户,这套组合比纯igraph更直觉。
network与sna:传统统计视角
这两个包是statnet套件的核心,关注网络统计建模,比如指数随机图模型(ERGM)和社交网络分析中常用的检验,如果你的研究需要推断网络形成的机制,而不是单纯描述,network+sna是更专业的选项。
对比速览
| 包名 | 核心优势 | 适用场景 | 学习曲线 |
|---|---|---|---|
| igraph | 功能全面,算法丰富 | 通用复杂网络分析 | 中等 |
| tidygraph | 数据清洗友好,链式操作 | 数据预处理频繁的场景 | 较低 |
| network+sna | 统计建模专用 | 社交网络、ERGM | 较高 |
| visNetwork | 交互式可视化 | 报告展示 | 低 |
建议:日常分析以igraph为主,可视化用ggraph和visNetwork配合,需要建模时再引入statnet套件,这样既保证了效率,又不会因为包太多而混乱。
如何用R语言从零构建复杂网络模型
很多人在初期会卡在数据准备上,复杂网络的数据来源五花八门:邻接矩阵、边列表、GML文件、甚至从数据库直接拉取,下面我给出最通用的操作路径。
构建网络对象的三种方式
- 从边列表构建:边列表是两列数据,第一列是源节点,第二列是目标节点,用
graph_from_data_frame()即可生成igraph对象,如果边有权重,第三列指定为权重列。 - 从邻接矩阵构建:矩阵a[i,j]表示节点i到j的边,用
graph_from_adjacency_matrix(),注意模式选择“directed”或“undirected”。 - 从文件导入:使用
read_graph(),支持GraphML、GML、Pajek等格式,生物网络分析中常见的.sif文件,也能用read.table()读取后转换。
数据清洗常见陷阱
- 自环(self-loop):节点到自身的边在多数分析中无意义,用
simplify()去除。 - 多重边(multiple edges):同一对节点间多行记录,使用
simplify(edge.attr.comb = list(weight = "sum"))合并权重。 - 悬挂节点(isolates):非连通节点不影响中心性计算,但可视化时可能造成干扰,可用
delete.vertices()删除度为零的节点。
实操:从小型社交网络开始
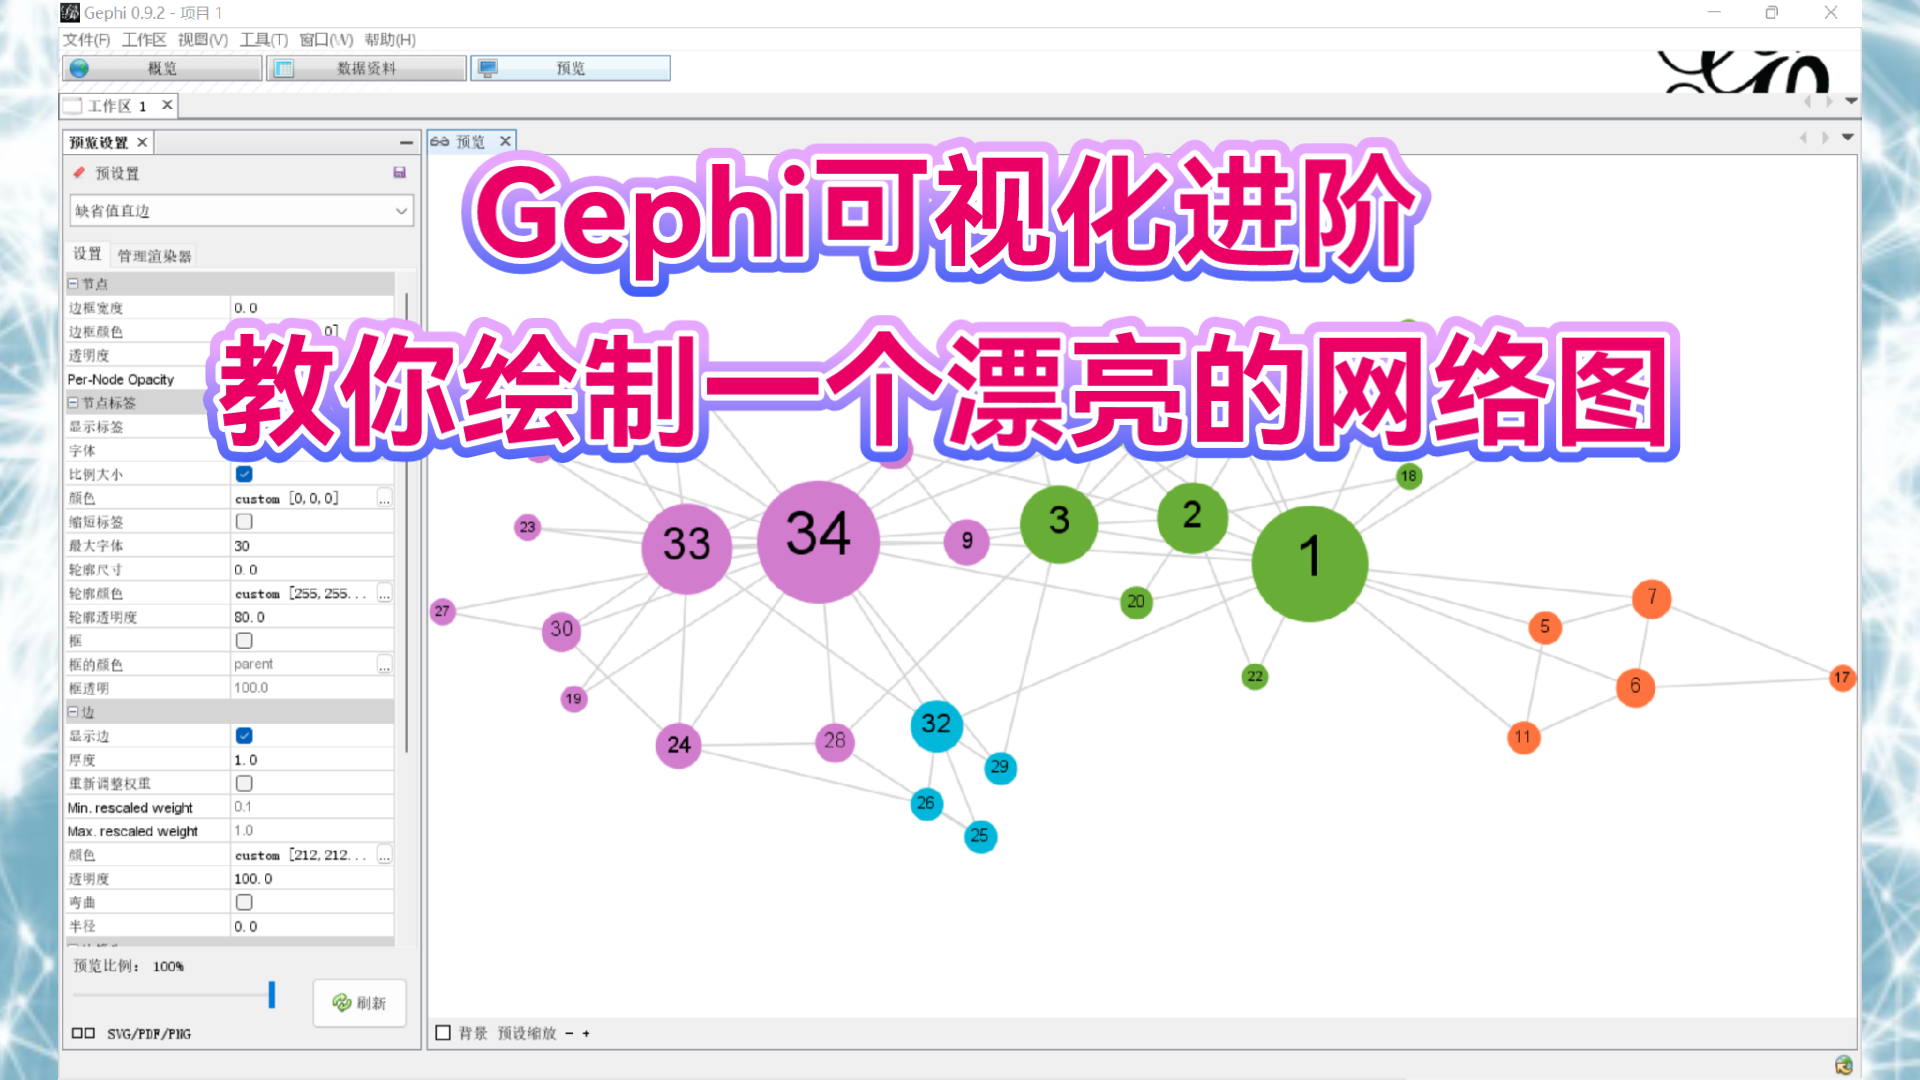
以标准的空手道俱乐部网络为例,R语言内置该数据集,igraphdata包中有karate,你只需加载包并调用data(karate),一个包含34个节点、78条边的真实社交网络就准备好了,这是国内R语言复杂网络分析教程中常用的入门案例,方便对比不同算法的结果。
R语言复杂网络分析核心指标计算实战
网络究竟有什么特性,需要用指标来度量,下面只讲最常用且可解释性强的几个。
度分布与幂律拟合
- 计算每个节点的度:
degree()
,然后画直方图或累积分布图。
- 检验无标度特性:将度和累积概率对数化,用lm拟合斜率,igraph的
fit_power_law()直接给出阿尔法值和K-S检验p值。 - 行业共识:许多真实网络(如互联网、蛋白质相互作用)的度分布接近幂律,阿尔法值通常在2到3之间。
中心性计算
- 介数中心性:
betweenness(),衡量节点在最短路径中的桥梁作用,计算量大,可传入directed = FALSE和normalized = TRUE得到归一化结果。 - 紧密度中心性:
closeness(),反映节点到其他节点的平均距离,注意有向网络需指定mode。 - 特征向量中心性:
eigen_centrality(),基于邻居节点重要性递归计算,常与PageRank类比。
实际操作建议
- 对于大规模网络(节点数超过10万),介数中心性计算非常耗时,可以考虑使用
estimate_betweenness()设定采样比例,或者使用R的并行计算方案。 - 生物网络分析中,常结合度分布和聚类系数筛选关键节点,比如在基因共表达网络中,高介数且低聚类系数的节点往往是调控枢纽。
R语言复杂网络可视化与社区发现
可视化不只是画图,更是发现网络结构模式的工具,社区发现则是将网络划分为子群。
布局算法选择
layout_with_fr():Fruchterman-Reingold算法,力导向布局,适合小型网络,展示聚类效果最好。layout_with_kk():Kamada-Kawai算法,更注重距离保持,适合展示对称结构。layout_nicely():自动选择,对大多数网络表现不错。- 对于大型网络,考虑
layout_with_lgl()或layout_with_drl(),速度更快但视觉精细度下降。
社区发现算法
- Louvain算法:
cluster_louvain(),基于模块度优化,速度快,是默认首选,行业共识认为,Louvain在大多数稀疏网络中表现稳定。 - 标签传播算法:
cluster_label_prop(),无需先验参数,适合快速了解社区粗略划分。
- Infomap:
cluster_infomap(),基于信息论,擅长发现层次结构,但计算成本较高。
可视化实战:染色与标签
# 假设net是igraph对象V(net)$community <- membership(cluster_louvain(net))V(net)$color <- rainbow(length(unique(V(net)$community)))[V(net)$community]plot(net, vertex.size = 5, vertex.label = NA, layout = layout_with_fr())
这一步可以直观看到社区如何分割,如果觉得静态图不够交互,可以使用visNetwork包将网络导出为html,支持拖拽、缩放和节点信息查看,尤其适合汇报场景。
复杂网络分析不是一蹴而就的,但R语言提供了一套从数据构建到指标计算再到可视化的完整闭环,且学习成本远低于商业软件,只要掌握igraph和tidygraph这两个核心工具,大多数分析场景都能高效应对,剩下的就是针对具体问题选择合适的算法和参数。
复杂网络r语言常见问题与解答
问题1:R语言适合处理大规模复杂网络吗?
igraph本身是C语言内核,效率较高,但R的内存管理限制了节点数在百万级以下,对于超大规模网络(如亿级边),建议先用Python的NetworkX或Spark进行粗筛,再用R做精细分析,如果数据在几十万节点以内,R完全能够胜任。
问题2:R语言与Python在复杂网络分析中如何选择?
两者各有侧重,R在统计检验和可视化细节上更丰富,尤其适合学术论文中的图表制作;Python在工业级部署和超大规模数据处理上更有优势,如果你主要做研究且注重图表的可定制性,R是性价比更高的选择。
问题3:初学者如何快速上手R语言复杂网络分析?
建议从igraph的官方文档开始,运行其内置的karate和lesmis网络案例,逐步替换为自己的数据,国内R语言社区有大量免费教程和代码仓库,搜索“R语言社交网络分析场景”即可找到完整的实操流程,通常包含数据清洗到可视化的全步骤。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/531274.html