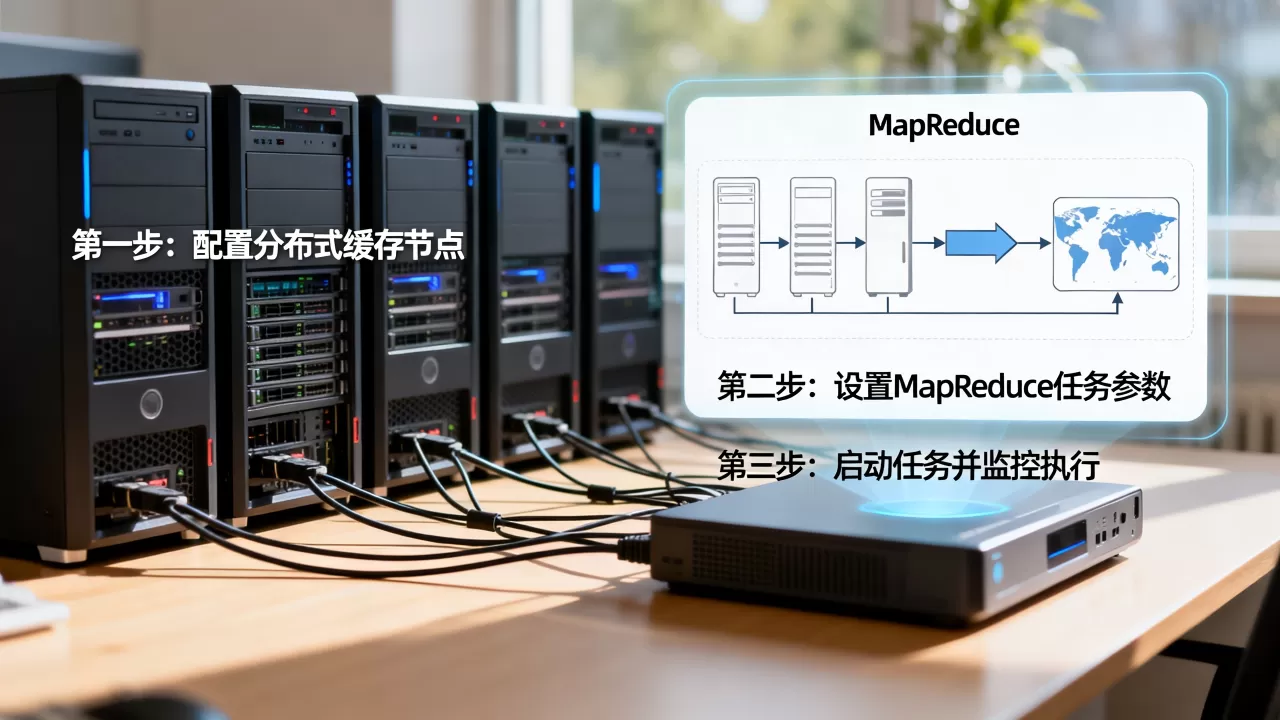
在Hadoop的MapReduce任务中,分布式缓存(DistributedCache)是预分发文件到所有节点的一种高效机制,尤其适合将小表、字典或配置文件加载到每个Mapper或Reducer中,避免重复从HDFS读取,这是提升任务性能的关键配置。
hadoop分布式缓存配置步骤详解
分布式缓存的核心原理
当提交一个MapReduce作业时,你可以通过配置指定需要分发的文件(如文本、JAR、压缩包等),Hadoop框架会将这些文件复制到HDFS的临时目录,然后在作业启动前,由TaskTracker将它们下载到本地磁盘,任务运行时,这些文件会通过符号链接(symlink)映射到工作目录,就像本地文件一样直接访问。行业共识认为,这种机制对于数据本地性友好,特别适合大小为几百MB以内的文件分发。
配置缓存的两种方式
-
通过命令行参数
- 使用
-files选项指定文件,如-files hdfs:///path/to/file#linkname。 - 使用
-archives选项指定压缩包,Hadoop会自动解压,如-archives hdfs:///path/to/zip#dir。 - 示例:
hadoop jar myjob.jar MainClass -files small_table.txt#dict input output
- 使用
-
在代码中配置
- 使用
Configuration的addCacheFile(URI uri)方法,Configuration conf = new Configuration(); conf.addCacheFile(new URI("hdfs:///path/to/file#dict")); - 对于旧API,使用
DistributedCache.addCacheFile(URI, Configuration)。 - 注意:在分布式环境中,文件路径必须为HDFS绝对路径,并建议使用符号链接(#符号后指定别名)简化访问。
- 使用
读取缓存文件的正确姿势
在Mapper或Reducer的setup()方法中获取缓存文件路径:
- 新API:
context.getCacheFiles()返回URI[],然后通过本地化路径访问。 - 旧API:
DistributedCache.getLocalCacheFiles(Configuration)返回Path[]。 - 常用做法:遍历缓存文件,使用
BufferedReader读取,并加载到内存数据结构(如HashMap)中。 - 示例代码片段:
protected void setup(Context context) throws IOException {
    URI[] cacheFiles = context.getCacheFiles();
    if (cacheFiles != null && cacheFiles.length > 0) {
        Path filePath = new Path(cacheFiles[0].getPath());
        // 读取文件内容
    }
}
注意:如果通过-files指定,没有符号链接时,文件会以原文件名存在于工作目录,但推荐使用符号链接以避免路径复杂。
新旧API差异速览
| 项目 | 旧API(Hadoop 1.x) | 新API(Hadoop 2.x+) |
|---|---|---|
| 添加缓存 | DistributedCache.addCacheFile |
Configuration.addCacheFile |
| 获取缓存 | DistributedCache.getLocalCacheFiles |
context.getCacheFiles |
| 符号链接 | 通过createSymlink配置 |
自动支持,后指定别名 |
| 推荐度 | 已废弃 | 当前主流 |
mapreduce分布式缓存实战:小文件关联
场景描述
假设我们有一个用户日志(大文件,按userId分区)和一个用户信息表(小文件,约10MB,包含userId和info),我们需要在Map阶段将日志与用户信息关联,输出合并后的记录,如果每个Mapper都从HDFS单独读取用户信息表,会产生大量IO,而使用分布式缓存可以一次性分发给所有Mapper。
实现步骤
- 将用户信息表上传到HDFS:
hdfs dfs -put user_info.txt /cache/user_info.txt - 在作业配置中添加缓存文件:
- 命令行:
-files hdfs:///cache/user_info.txt#user_info - 代码:
conf.addCacheFile(new URI("hdfs:///cache/user_info.txt#user_info"));
- 命令行:
- 在Mapper的
setup()中读取缓存文件:- 通过符号链接名
user_info访问,文件实际位于工作目录,可直接用new File("user_info")打开。
- 通过符号链接名
- 将读取的userId->info映射存入HashMap,在
map()方法中根据日志的userId获取info并输出。
注意事项
- 缓存文件大小:分布式缓存默认会复制到每个节点,因此文件过大(如超过
100MB
)会导致分发开销大,建议使用压缩或考虑其他方式。 - 符号链接:使用指定别名后,代码中可以直接用别名读取,无需复杂路径。
- 更新问题:如果缓存文件频繁变化,需要确保HDFS上的文件被更新,并重新提交作业。
分布式缓存与shuffle的适用场景对比
虽然分布式缓存和Shuffle(排序归并)都是MapReduce的核心机制,但它们的用途完全不同。业内专家指出,在很多优化场景中,合理使用分布式缓存可以避免不必要的Shuffle开销。
| 特性 | 分布式缓存 | Shuffle |
|---|---|---|
| 目的 | 在任务开始前分发静态文件 | 在Map和Reduce间传输中间数据 |
| 数据量 | 适合小文件(MB级) | 处理大规模数据(GB/TB级) |
| 触发时机 | 任务初始化时 | Map阶段结束后 |
| 数据使用 | 每个任务可独立读取 | 根据key分区,需要排序合并 |
| 典型场景 | 小表关联、配置文件加载 | 分组聚合、排序 |
适用选择:当你需要在Map或Reduce中反复使用一个较小的数据集时,优先选择分布式缓存,如果数据量较大且需要根据key做聚合,则必须依赖Shuffle。
性能优化技巧
使用Archive压缩分发
当需要分发多个小文件时,将它们打包成一个压缩归档(如.tar.gz),通过-archives参数分发,Hadoop会在工作目录自动解压,不仅减少网络传输量,还能保持目录结构。
hadoop jar job.jar MainClass -archives myfiles.tar.gz#files input output
在代码中,解压后的文件会出现在files子目录下,方便读取。
合理设置缓存副本数
通过mapreduce.job.cache.limit可以控制每个节点允许缓存的最大文件大小(默认单位MB),如果缓存文件超过限制,任务会失败,根据集群资源,建议将单个缓存文件控制在200MB以内,避免影响任务启动速度。
避免重复加载
在setup()方法中一次性加载缓存数据到内存,不要在map()或reduce()中每次都读取文件,将字典加载到HashMap,后续只需在map方法中快速查找。
本地化路径最佳实践
始终使用符号链接(别名)引用缓存文件,这样代码不依赖具体路径,便于维护,确保在setup()中及时关闭文件流,释放资源。
常见误区与解决方案
- 误区:缓存文件可以动态更新,缓存文件在作业提交时确定,运行期间不可修改,如果数据需要变化,必须重新提交作业。
- 误区:缓存文件只能在Mapper使用,Reducer同样可以通过
setup()获取缓存文件,适合在Reduce端做查找或合并。 - 误区:HDFS路径写相对路径。
addCacheFile必须使用完整的HDFS绝对路径(如hdfs://namenode:8020/path),否则会被忽略。
分布式缓存是Hadoop MapReduce中一个轻量级但极其有效的优化工具,掌握它的配置与使用,能让你在应对小文件关联、字典分发等场景时事半功倍。 在编写MapReduce程序时,不妨将静态数据提取出来,通过分布式缓存统一管理,这会带来显著的性能提升。
Q&A:hadoop分布式缓存常见问题
分布式缓存中的文件能修改吗?
缓存文件是只读的,在任务运行期间无法修改,如果需要动态更新,需重新提交作业或使用较新的API(如Job.addCacheFile)在运行时配置。
缓存文件大小超过默认限制怎么办?
可以通过修改mapreduce.job.cache.limit(默认值约10GB,具体取决于发行版)来调整阈值,但分发过大文件会影响性能,一般建议控制在几百MB以内,必要时改用分布式缓存归档或共享存储。
为什么我的代码找不到缓存文件?
最常见原因是未使用符号链接或路径错误,检查HDFS路径是否正确,且确保使用了别名,确认在setup()中通过context.getCacheFiles()获取的文件URI是否对应本地路径,如果使用旧API,注意DistributedCache.getLocalCacheFiles可能返回空列表,建议迁移到新API。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/536260.html