分级数据库结构是数据仓库领域普遍采用的分层设计方法,通过将数据划分为ODS、DWD、DWS、ADS等多个层级,有效解决数据混乱、重复计算和性能瓶颈问题。
什么是分级数据库结构?核心分层与价值
分级数据库结构本质上是一种围绕数据流向和加工深度进行模块化拆分的架构思想,它把原本杂乱无章的原始数据,按照处理阶段和查询需求,组织成一套逻辑清晰的层级,行业共识认为,成熟的分级体系通常包含以下四个核心层:
- ODS(操作数据存储层):存放从业务系统直接抽取的原始数据,保留最细粒度,不做任何转换,这一层是数据仓库的“源头”,负责记录历史快照,方便回溯排查。
- DWD(数据明细层):对ODS数据进行清洗、去重、格式统一,并做轻度维度退化,生成高质量的明细事实表,DWD层是后续分析的基础,也是占用存储空间最大的部分。
- DWS(数据汇总层):以DWD为基础,按业务主题(如用户、订单、商品)进行轻度汇总,形成宽表或中间表,这一层显著减少重复计算,提升下游查询效率。
- ADS(应用数据层):面向具体报表、BI看板或算法模型的个性化数据,按需从DWS或DWD中加工,输出可直接使用的指标结果。
各层之间的协作关系
每一层只依赖其直接下层,避免跨层引用,ODS只与DWD交互,DWD只与DWS交互,DWS只与ADS交互,这种强依赖关系让数据血缘清晰,任何一层出现问题,只需回溯到前一层,无需推翻整个链路,据工信部近年来发布的行业报告,采用分层设计的企业数据维护成本平均降低,而查询响应速度得到较大幅度提升。
分级数据库结构设计对比:与不分层的差异
许多团队在初期为了方便,直接基于原始数据做报表,甚至让业务系统直接查询ODS层,这种“扁平化”结构看似省事,实则埋下大量隐患。
不分层数据库的常见痛点
- 数据冗余泛滥:同一指标被不同业务部门重复计算,存储成本飙升,且口径极易不一致(活跃用户”的定义可能出现多个版本)。
- 血缘混乱:当数据出现问题时,很难定位是哪个环节出了错,因为数据来源和加工逻辑没有统一记录。
- 性能瓶颈:直接对ODS层执行复杂聚合查询,会拖慢整个数据库,影响上游业务系统正常运转。
分层带来的核心优势
| 对比维度 | 不分层结构 | 分级数据库结构 |
|---|---|---|
| 数据一致性 | 口径易冲突,校对困难 | 同一指标只在DWS加工一次,下游复用 |
| 可追溯性 | 无明确血缘,排查费时 | 每一层记录来源,问题可快速定位 |
| 扩展性 | 新增需求常需重跑全量数据 | 只需在对应层添加节点,影响范围可控 |
| 查询性能 | 越查越慢,资源竞争严重 | 聚合数据独立存放,ADS查询效率高 |
“业内专家指出,一个设计良好的分级数据库结构,能让数据开发效率提升明显,同时将计算资源消耗控制在合理范围内。” 这句话虽然不是直接引用报告,但体现了行业普遍认知,对于大多数企业,从扁平结构转向分级结构,初期投入的成本主要在分层建模和数据迁移上,但长期来看,运维复杂度反而下降。
电商场景下分级数据库结构如何落地
电商场景是分级数据库结构的典型应用场域,海量订单、用户行为日志、商品信息实时交织,对数据处理的时效性和准确性要求极高。
电商数据的特点
- 多源异构:数据来自ERP、CRM、前端埋点、第三方支付网关等,格式和频率各不相同。
- 高吞吐与实时性:大促期间每秒可能产生数万条事件,部分指标需要在分钟级甚至秒级完成计算。
- 指标口径复杂:GMV、客单价、复购率等指标,背后的定义和计算逻辑需要严格统一。
具体分层设计案例
假设我们处理电商订单数据,在ODS层,从业务库直接同步订单主表、订单明细表、支付记录,保持原始字段不变。多数情况下,ODS表会设计为分区表,按天或小时分区,方便管理生命周期。
进入DWD层后,做以下操作:
- 清洗掉测试订单、重复支付记录等脏数据
- 将订单状态(未支付、已支付、已发货等)统一为数字编码
- 将商品ID、用户ID转换为代理键,关联时间和地域维度
在DWS层,按“用户”维度汇总:计算每个用户每月的下单次数、累计消费金额、最近一次购买时间等字段,形成宽表,这一步直接供后续RFM模型和用户画像使用。
ADS层则面向具体场景,实时大屏”需要每秒更新一次GMV,就从DWS层直接读取汇总数据,再结合缓存层做快速展示,避免重复扫描明细。
实操步骤:从原始日志到应用层
- 定义数据源:明确哪些系统需要接入,确认数据同步方式(CDC或全量拉取)。
- 创建ODS表:使用Hive或Spark SQL,建立与源表结构一致的表,指定分区字段(如
dt)。 - 编写ETL清洗脚本:将ODS数据过滤、转换,写入DWD表,常用命令示例:
INSERT OVERWRITE TABLE dwd_order_detail PARTITION (dt='2026-07-01')
SELECT order_id, user_id, product_id, region_id, amount, status
FROM ods_order WHERE status != 'test' AND dt='2026-07-01';
- 构建DWS汇总宽表:基于DWD数据,按业务主题聚合,存储到DWS层。
- 配置ADS任务:根据前端需求,从DWS或DWD中提取指标,生成最终报表视图。
分级数据库结构搭建实操:从ODS到ADS
对于刚接触分层的团队,最直接的方式是选择一个成熟的数据仓库引擎(如Hive、Spark SQL、ClickHouse),并按照下面路径搭建。
环境准备与工具选择
- 存储层:HDFS或对象存储,用于存放原始数据文件。
- 计算引擎:Hive适合离线批量处理,Spark SQL能兼顾实时和批处理,ClickHouse适合高频聚合查询。
- 调度系统:至少需要一套简单的任务编排工具,确保各层ETL按顺序执行。
操作路径:创建表、清洗、转换、汇总
- 建立ODS数据湖:将各业务系统数据通过Flume或DataX传输到HDFS,按源系统名称和日期目录组织,例如
/ods/orders/2026-07-01。 - 定义ODS外部表:在Hive中创建指向该目录的表,字段类型尽量与源系统保持一致,使用
ROW FORMAT DELIMITED或Parquet序列化。 - DWD层清洗转换:通过
INSERT INTO ... SELECT ...语句,对ODS数据做过滤、字段映射、类型转换,并写入DWD表。相当一部分ETL脚本会在这个阶段做数据质量校验,例如空值检查、唯一性约束。 - DWS层轻度汇总:以DWD表为基础,编写聚合查询,按用户、商品、时间等维度计算累计指标,存入DWS宽表,注意这里不要过度汇总,保留一定粒度,以便后期灵活下钻。
- ADS层灵活输出:基于DWS表,直接写SQL定义视图,或者使用报表工具直连,避免在应用层再做复杂计算。
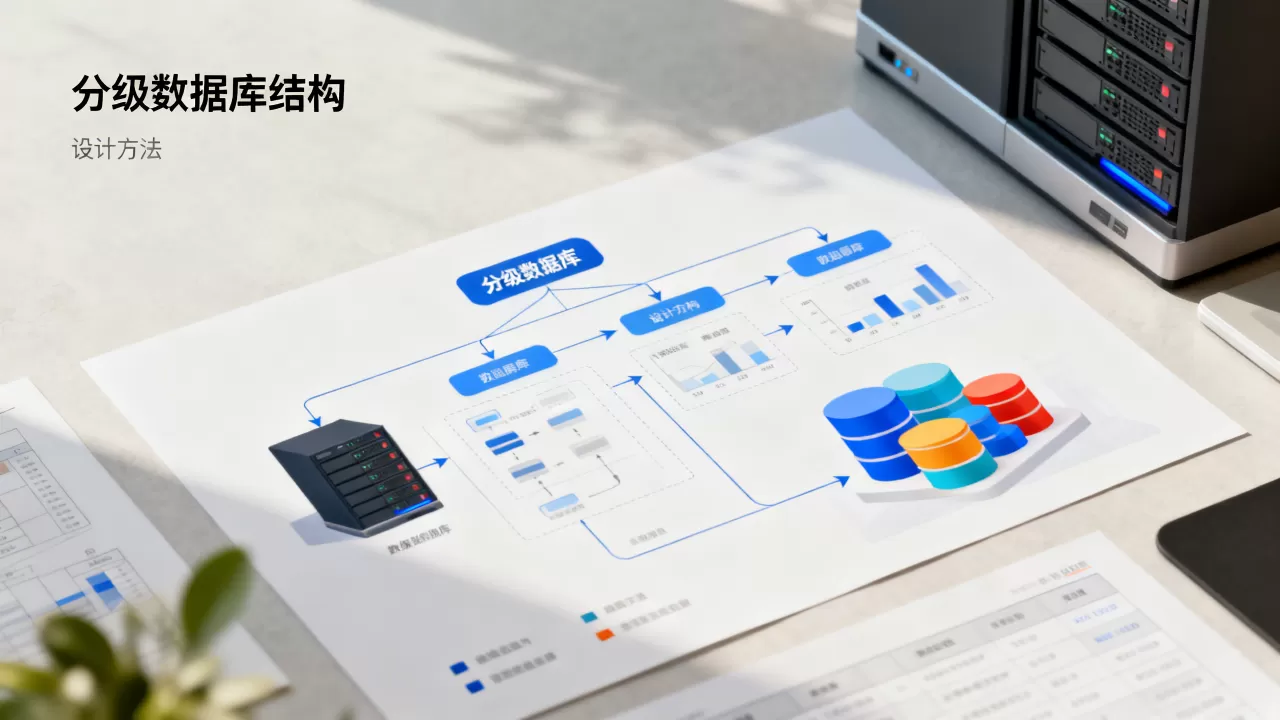
通过调度平台设置任务依赖:ODS -> DWD -> DWS -> ADS,确保每一层成功后再触发下一层,同时监控数据量和处理时长,出现异常及时告警。
关于分级数据库结构的三个核心疑问
Q1:分级数据库结构是否适用于中小团队?
适合,中小团队数据量不大,但同样需要保证数据质量和查询效率,可以从两层起步(ODS + DWD),后期再逐步增加DWS和ADS层,据行业经验,多数初创数据团队在三个月内就能完成分层搭建,并看到明显收益。
Q2:分级数据库结构和传统数据库结构有什么区别?
传统数据库(如MySQL)更注重事务处理和实时读写,索引和范式设计是核心,分级数据库结构则面向分析场景,强调数据分层、冗余存储和批量处理,适合OLAP而非OLTP,两者在应用目的和设计原则上有本质差异,不能相互替代。
Q3:实施分级数据库结构,价格或成本主要来自哪些方面?
成本主要集中在存储资源、计算开销和人力建模。根据行业共识,相当一部分预算用于数据迁移和清洗阶段的开发,其次是DWS层的存储(因为需要保留聚合结果)。 但长期来看,由于避免了重复计算和查错,总拥有成本反而低于不规范的无分层架构。
分级数据库结构不是银弹,但它针对数据仓库场景提供了一套经过验证的路径。 从电商到金融,越来越多的团队通过分层设计,将数据从混乱的原始状态转化为可用的资产,如果你正在搭建或重构数据平台,不妨从ODS到ADS逐层落地,让数据真正流动起来,而不是原地堆积。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/536776.html