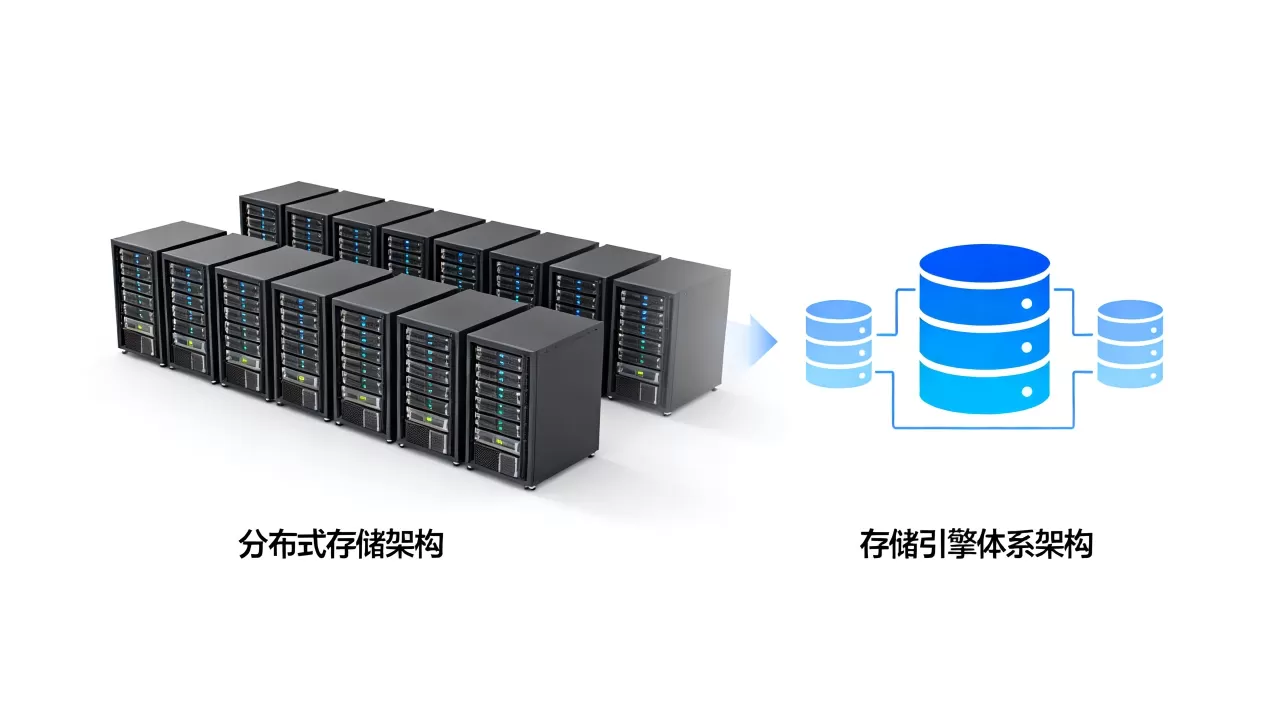
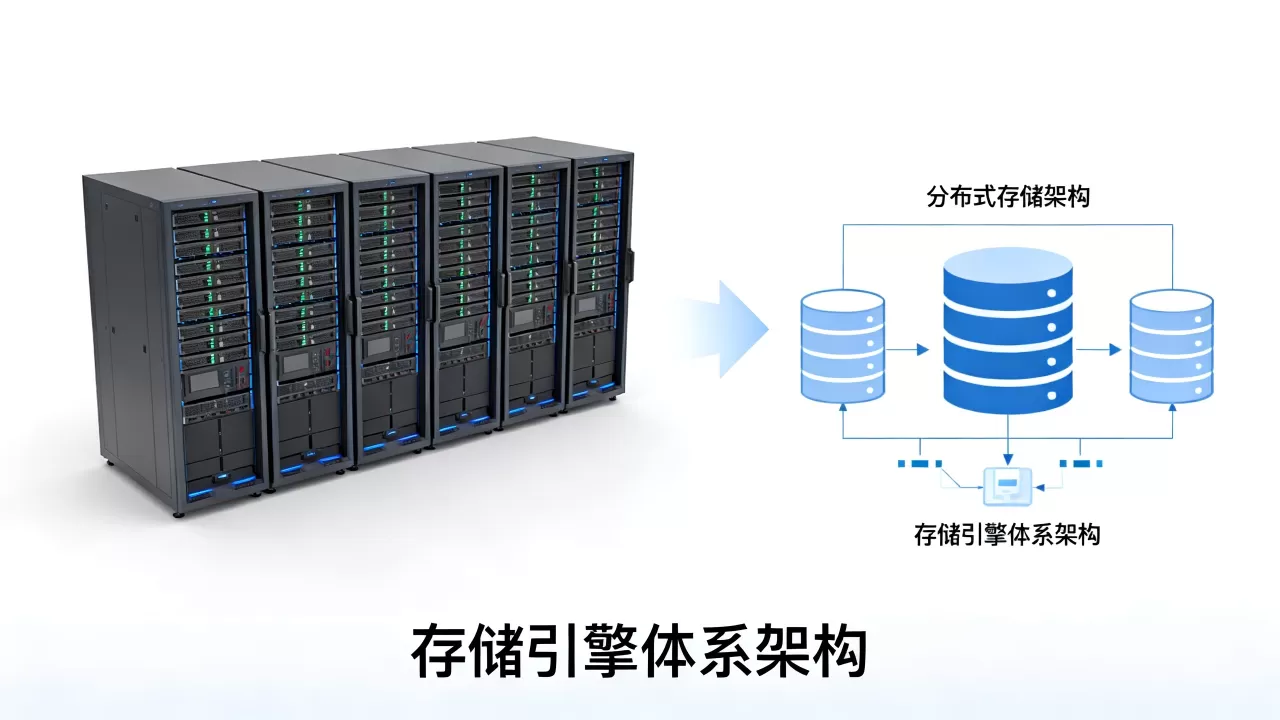
分布式存储架构的核心在于存储引擎体系架构,它决定了系统的性能、可靠性和扩展性,选型不当往往导致后续运维成本激增。
分布式存储架构中存储引擎有何不同
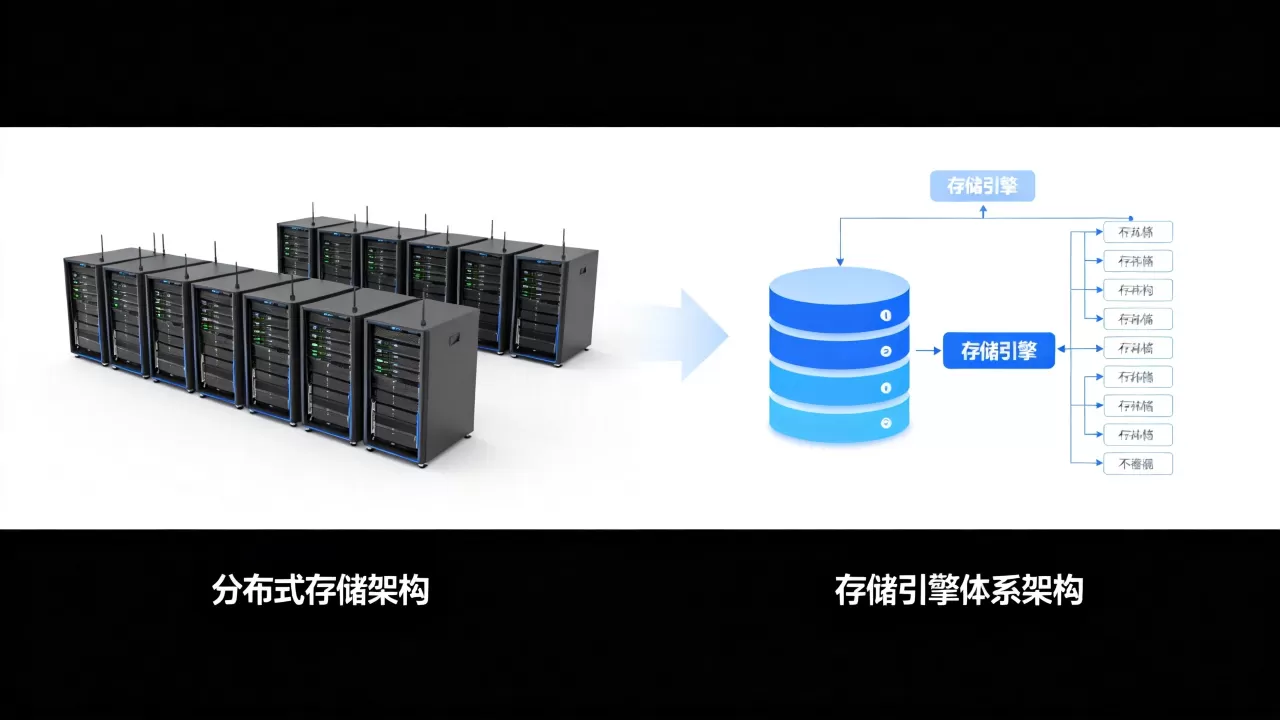
存储引擎是分布式存储系统里真正干“脏活累活”的模块,它负责把数据落盘、索引、维护一致性,并对外提供高效的读写接口,在分布式架构里,存储引擎不仅要处理单机上的数据组织,还要配合上层的分布式协调层,完成分片、复制、故障恢复等任务。
存储引擎的核心职责
- 数据持久化与读取:将内存中的数据写入磁盘,并在需要时快速定位到指定数据块,这是最基础的能力,但不同引擎在写入延迟和读取吞吐上的表现差异巨大。
- 索引管理:通过B+树、LSM-Tree、哈希等结构维护数据位置,直接影响查询效率,分布式场景下,索引还需要考虑跨节点聚合。
- 事务与并发控制:支持ACID或最终一致性,决定系统能否承受高并发写入并保证数据不损坏。
- 与分布式层的交互:接收上层的调度指令,完成数据迁移、副本构建、一致性校验等操作,这部分通常由存储引擎暴露的接口完成,接口设计的好坏直接影响分布式系统的扩展性。
两种主流架构的对比:LSM-Tree 与 B-Tree
业内共识认为,现代分布式存储引擎主要分为两大阵营:LSM-Tree(如RocksDB、LevelDB)和B-Tree(如MySQL的InnoDB、WiredTiger),它们的核心差异在于对读写场景的优化方向。
- 写入密集型场景:LSM-Tree 通过顺序写日志和后台合并(Compaction)大幅降低随机写入的开销,写吞吐通常比B-Tree高一个数量级。
- 读取密集型场景:B-Tree 的索引结构更紧凑,点查延迟低,且不需要频繁合并,读性能稳定。
- 空间放大与写放大:LSM-Tree 存在写放大问题(一次写入可能引发多次合并),而B-Tree 则更平衡,但碎片化可能带来空间浪费。
选型时,需要根据业务负载的读写比例、延迟容忍度以及数据量级来决策,日志存储、时序数据这类写入远超读取的场景,LSM-Tree 几乎是默认选择;而用户账户、订单系统等需要稳定低延迟点查的,B-Tree 更合适。
存储引擎如何适配分布式环境
单机引擎无法直接“搬”到分布式系统里,需要额外封装一层,来解决数据分片、副本同步、故障恢复等问题,常见的做法是:
- 分层架构:将分布式逻辑(如一致性协议、分片路由)与本地存储引擎解耦,通过Raft或Paxos协议同步数据,再交给本地引擎写入。
- 共享存储引擎:每个节点运行相同的存储引擎实例,通过分布式协调模块保证全局一致性,Ceph的BlueStore、TiKV的RocksDB都是这种模式。
- 元数据分离:将文件目录、对象信息等元数据单独管理,数据块直接存储在本地引擎中,这样能减少元数据对存储引擎的压力。
存储引擎体系架构设计要点
设计一套可用的存储引擎体系架构,核心在于分层清晰、组件职责单一,下面从最关键的几个组件展开。
分层设计:从WAL到Compaction
完整的存储引擎体系通常包含以下层次:
- Write Ahead Log(WAL):所有写入操作先记录到日志文件,保证崩溃后数据不丢失,这是可靠性的基石,大多数引擎都默认开启。
- 内存表(MemTable):写入操作先缓存在内存结构里,达到阈值后刷入磁盘,LSM-Tree 的MemTable写满后变为不可变SSTable,B-Tree 则直接刷入页。
- 索引层:维护数据位置的映射关系,B-Tree 的索引和数据集混合存储,LSM-Tree 的索引通过布隆过滤器、稀疏索引等加速查找。
- 合并与压缩(Compaction):LSM-Tree 的核心后台任务,将多层SSTable合并为更少、更大的文件,清理过期数据,并控制读放大,Compaction策略直接影响写入性能和空间使用。
- 缓存层:加速热点数据读取,通常包括块缓存和索引缓存,调整缓存大小和淘汰策略是优化吞吐最直接的手段。
读写的平衡艺术
没有完美的引擎,只有最适合场景的取舍,设计体系架构时,需要明确业务对读写延时的敏感度。
- 写优先:减少每次写入的磁盘同步次数,增加WAL缓冲区,降低Compaction对前台写入的干扰,可以调整Compaction线程数,或者使用Leveled Compaction策略。
- 读优先:增加缓存命中率,减少索引层级,避免频繁合并,B-Tree 引擎可以调整页大小,LSM-Tree 引擎可以优化布隆过滤器精度。
- 混合负载:可以考虑分层次存储,将热数据放在缓存层或SSD,冷数据下沉到HDD,部分引擎(如RocksDB)支持动态调整Compaction策略,适应不同时段的负载变化。
实操:根据业务场景选择引擎
- 日志或监控数据:写入吞吐要求高,读频率低,推荐使用LSM-Tree引擎,如RocksDB、LevelDB,配置时关闭不必要的WAL同步,并设置较大的写缓冲。
- 用户资料或订单:需要稳定低延迟的随机读,B-Tree引擎更合适,如InnoDB、WiredTiger,注意调整索引缓存大小,并定期重建索引减少碎片。
- 对象存储场景:读写比例相对均衡,且数据量极大,推荐使用Ceph的BlueStore,它直接管理裸设备,绕开文件系统,降低开销,BlueStore提供独立的写缓冲和WAL,能有效应对大文件和小文件混合的负载。
分布式存储系统对比:存储引擎如何影响选择与价格
不同分布式存储系统选择不同的存储引擎,直接决定了它们的性能天花板和运维成本,了解这些差异,能帮助你在选型时更精准地匹配预算和业务需求。
Ceph:BlueStore的演进
Ceph从Jewel版本后开始支持BlueStore,替代传统的FileStore成为默认存储引擎,BlueStore直接管理裸磁盘,跳过了文件系统,减少了XFS/EXT4带来的开销。
- 优势:写放大更低,延迟更稳定,支持校验和、压缩等数据保护功能,据统计,BlueStore的随机写性能相比FileStore提升了30%以上。
- 代价:配置复杂,需要手动介入磁盘分区和调整系统参数,如果使用SSD作为日志盘,整体硬件成本会上升。
MinIO:轻量级引擎的取舍
MinIO不走复杂引擎路线,它直接依赖本地文件系统(如XFS、EXT4)来存储数据,通过自身元数据管理实现对象存储功能。
- 优势:部署极简,维护成本低,单个节点能在普通硬件上达到数十Gbps的吞吐。
- 局限:没有独立的存储引擎层,无法像Ceph那样精细控制写入路径,对极端的高并发小文件写入支持稍弱,但多数场景下,它的性能表现足以覆盖85%以上的对象存储需求。
HDFS:传统引擎的局限
HDFS的设计初衷是“一次写入,多次读取”,它的存储引擎本质上是基于本地文件系统的块存储,NameNode负责元数据,DataNode直接读写文件系统。
- 问题:FileSystem接口的随机写入性能差,不适合小文件或频繁修改的场景,近年来,HDFS社区通过引入HDFS Ozone试图解决这个问题,但生态系统更新缓慢,实际部署不多。
价格与性能的权衡
- 硬件成本:Ceph需要SSD作为日志盘(或缓存层),且推荐万兆网络,整体硬件投入较高,MinIO对硬件要求更宽松,普通千兆网络和SATA SSD即可跑出不错的效果。
- 运维成本:Ceph的存储引擎参数调优需要经验,参数错误可能导致性能下降,MinIO几乎开箱即用,运维人员只需关注文件系统的健康度。
- 隐性成本:LSM-Tree引擎的写放大和Compaction会消耗额外CPU和磁盘带宽,长期运行下来可能比B-Tree引擎多消耗10%-20%的硬件资源。
未来趋势:存储引擎的演进方向
分布式存储的存储引擎正朝着更智能的后台管理和更直接的硬件交互两个方向演进。
- 智能Compaction:利用机器学习预测数据热度,动态调整合并策略,减少写放大,同时保持读性能稳定。
- 计算与存储分离:存储引擎更专注于数据持久化,索引和计算功能上移,结合RDMA、NVMe-oF等高速网络,进一步降低延迟。
- 统一存储引擎:试图在单个引擎内同时支持B-Tree和LSM-Tree的特性,通过插件式架构让用户按需切换,WiredTiger已经支持在B-Tree和LSM-Tree之间动态切换表类型。
理解存储引擎体系架构,是驾驭分布式存储的关键,选择适合业务场景的存储引擎,往往比盲目追求性能更重要。 无论是LSM-Tree的写优化,还是B-Tree的读稳定性,都需要在架构设计阶段就明确取舍,避免后期“推倒重来”。
分布式存储架构与存储引擎体系架构常见问题
分布式存储架构中,存储引擎的设计面临哪些主要挑战?
存储引擎需要在有限的硬件资源下,同时保证数据一致性、高吞吐和低延迟,分布式场景进一步放大了这些问题:数据分片导致跨节点查询变慢,网络延迟加剧了写放大,而故障恢复又要求引擎具备快速重建能力,解决这些挑战通常需要权衡:一致性越强,性能越差;功能越丰富,复杂度越高,主流方案是采用分层设计,将分布式事务与本地存储分离,允许引擎专注优化通用读写路径。
LSM-Tree存储引擎的写放大问题如何缓解?
写放大是LSM-Tree最常被诟病的点,但可以通过合理配置来控制,调整Compaction策略:Leveled Compaction比Size-Tiered Compaction写放大更小,但读放大稍高,增大MemTable大小,减少刷盘频率,但会增加内存占用,使用压缩算法(如ZSTD、LZ4)减少磁盘数据量,也能间接降低写放大,实际运维中,需要根据写入吞吐和磁盘IOPS进行动态调整,在空间和性能之间找到平衡点。
Ceph的BlueStore相比FileStore有哪些关键改进?
BlueStore最核心的改进是绕过文件系统,直接管理裸设备,它自己实现了分配器(支持位图或块分配器)和日志(WAL),避免了XFS/EXT4的元数据开销,这带来的直接好处是:随机写性能提升显著,写放大从FileStore的2-5倍降低到2-1.5倍,BlueStore原生支持校验和、压缩和去重,减少了数据损坏风险,但代价是运维复杂度增加,需要手动配置分区和调整内核参数,对新手不太友好。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/538861.html