GPU服务器中单个GPU的算力点并非固定值,它取决于GPU型号、计算精度和运行环境,以NVIDIA主流数据中心GPU为例,FP32算力通常在10-20 TFLOPS区间,但更关键的指标是特定精度下的性能表现。
GPU算力点的核心定义与计量方式
什么是GPU算力点
在GPU服务器领域,算力点通常指单个GPU每秒可执行的浮点运算次数,单位是TFLOPS(万亿次浮点运算/秒),云服务商有时会抽象出“算力点”作为资源分配单位,例如1个算力点对应1 TFLOPS FP32算力,但不同厂商定义不同,理解算力点需要先明确计算精度,因为不同精度下数值差异巨大,在深度学习训练中,常用FP32或FP16,推理常用INT8,因此算力点必须绑定精度才有意义,在云服务实例中,酷番云的GPU云服务器会明确标注每个实例的算力点规格,方便用户按需选择;简米科技的托管服务则提供独享物理卡,算力点完全由用户控制。

不同精度下的算力差异
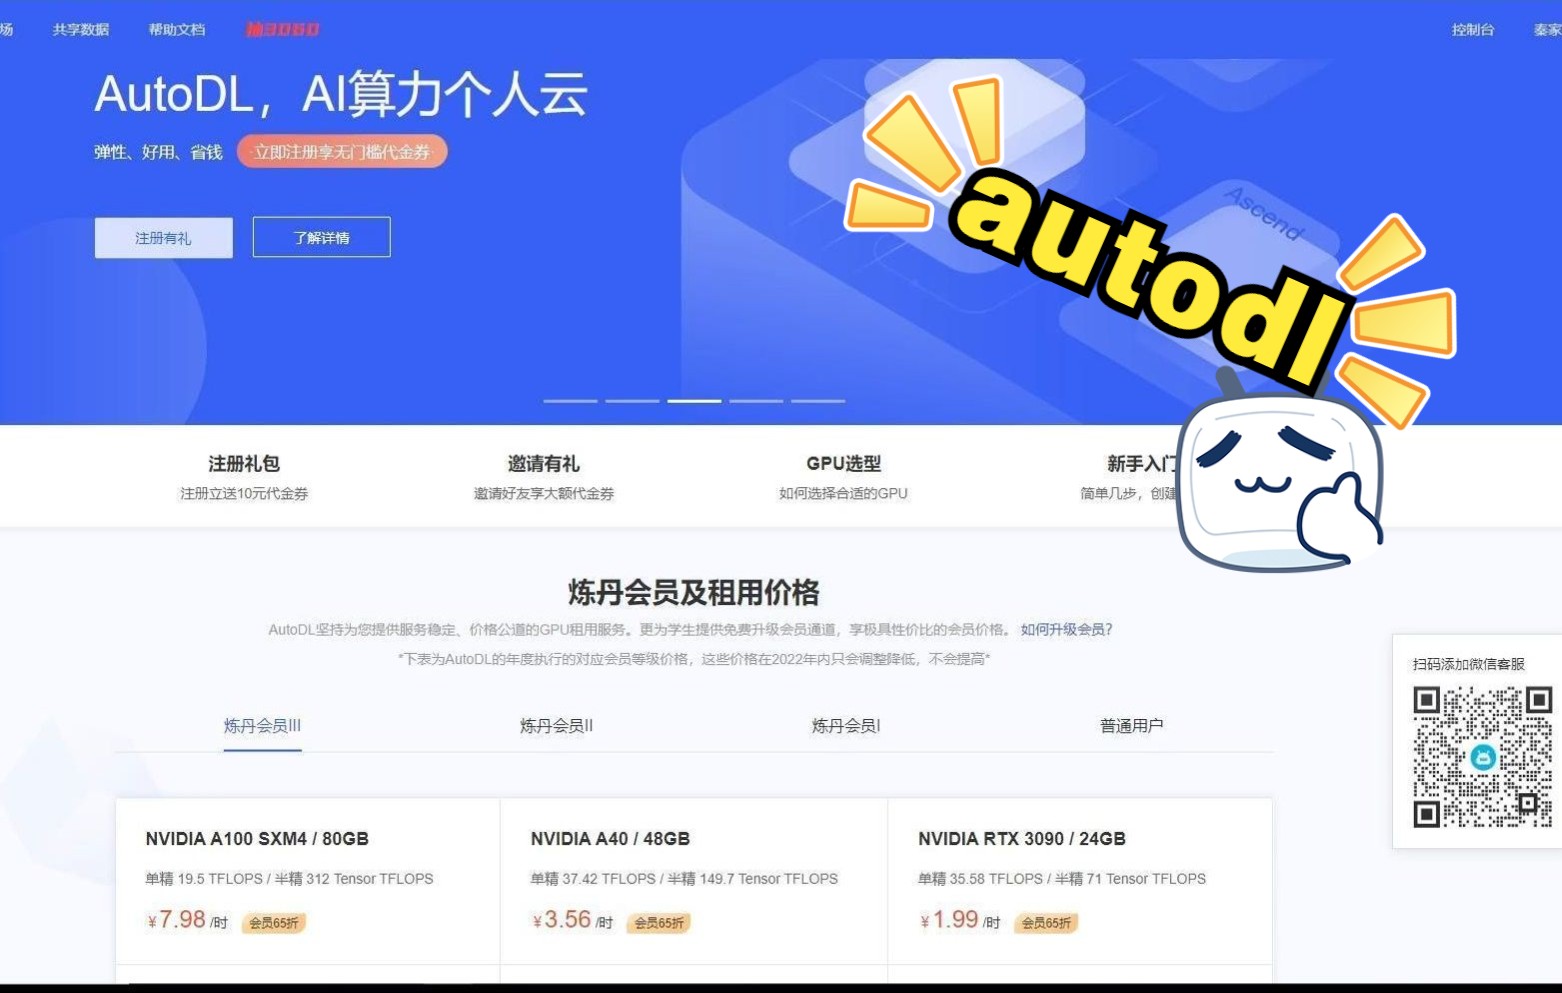
GPU支持多种精度格式,包括FP64、FP32、TF32、FP16、BF16、INT8等,以NVIDIA A100为例,FP64算力约9.7 TFLOPS,FP32约19.5 TFLOPS,TF32使用稀疏技术可达156 TFLOPS,INT8可达624 TFLOPS,精度越低,速度越快,但数值误差越大,选择GPU算力时,必须根据算法需求匹配合适精度,否则算力数据会失真,大多数AI框架利用混合精度训练,在FP32主精度下使用FP16加速,实际算力介于两者之间。
算力点的行业参考标准
近年来,AI行业逐渐形成以“PFLOPS天”为单位的算力衡量标准,即1个GPU连续运行1天产生的算力,但单卡算力点仍是基础,据NVIDIA技术白皮书,H100的FP8算力接近2000 TFLOPS,相当于2000个算力点(以1 TFLOPS为1点),但实际使用中受限于散热和互联,多数情况下只能达到理论值的70%到90%之间。
影响单GPU算力点的关键因素
GPU架构与代际
GPU架构直接决定算力上限,从Volta到Ampere再到Hopper,每代架构在流处理器、张量核心、缓存方面都有提升,V100的FP32算力为14 TFLOPS,A100提升到19.5 TFLOPS,H100则达到约30 TFLOPS,架构越新,单位算力点越高效,同时支持更多精度格式,如H100新增FP8支持,进一步提升了算力密度。
显存带宽与容量
算力发挥需要足够的数据吞吐,显存带宽决定了GPU每秒能读写多少数据,如果带宽不足,算力会被闲置,A100配备HBM2e显存,带宽超过2 TB/s;H100升级为HBM3,带宽超过3 TB/s,显存容量影响能否加载大模型,例如80GB显存是当前训练70B参数大模型的基础要求,如果显存不足,即使算力再高,也无法运行大模型,因此算力点必须与显存匹配。

散热与功耗设计
GPU实际运行算力受功耗和散热限制,TDP(热设计功耗)越高,持续性能越强,但需要配套散热系统,在数据中心,GPU通常运行在额定功率下,但若散热不足,可能触发降频,导致算力下降,实际可用算力点可能低于理论峰值,选择服务器时要关注散热方案,A100的TDP为400W,而H100达到700W,需要更强大的液冷或风冷系统。
软件优化与驱动
GPU算力点的发挥还需要软件栈配合,CUDA版本、cuDNN库、TensorRT推理引擎等都会影响实际性能,及时更新驱动和库,可以提升算力利用效率,使用TensorRT优化模型后,INT8推理性能可提升数倍,相当于增加了有效算力点。
主流GPU型号的算力参考
下表汇总了近年来数据中心常用GPU的算力范围(基于FP32),供参考:
- NVIDIA V100:FP32算力约14 TFLOPS,显存16/32GB HBM2,TDP 300W
- NVIDIA A100:FP32算力约19.5 TFLOPS,显存40/80GB HBM2e,TDP 400W
- NVIDIA H100:FP32算力约30 TFLOPS,显存80GB HBM3,TDP 700W
- NVIDIA H100 NVL:FP32算力约33 TFLOPS,显存94GB HBM3,TDP 700W(双卡NVLink)
- NVIDIA T4:FP32算力约8.1 TFLOPS,显存16GB GDDR6,TDP 70W(适合推理)
- NVIDIA L4:FP32算力约30.3 TFLOPS(稀疏),显存24GB GDDR6,TDP 72W
- AMD Instinct MI250:FP32算力约47.9 TFLOPS(双GPU模块),显存128GB HBM2e
- Intel Xe GPU Ponte Vecchio:FP32算力约45 TFLOPS(多芯片封装),显存128GB HBM2e
注意,这些都是理论峰值,实际应用受框架、驱动、数据精度影响,可能只能达到理论值的七到九成,在云服务中,GPU实例通常限制为单卡独享,因此实际算力点接近理论值。
如何根据业务需求选择GPU算力
深度学习训练
训练大模型需要高显存和高精度FP32或BF16,推荐A100或H100,算力点充足且显存达到80GB,可容纳百亿参数模型,如果预算有限,也可选择V100,但显存32GB是瓶颈,对于中小规模模型,如ResNet、BERT-base,V100或A100 40GB足够,训练时,算力点直接影响训练速度,但并非唯一因素,数据加载、模型并行策略同样重要,实际测试中,可以使用nvidia-smi监控GPU利用率,确保算力被充分利用。

实时推理
推理对算力精度要求较低,多使用INT8或FP16,需要低延迟,可以选择T4、L4或A10等边缘GPU,它们算力点适中,但能效比高,适合批量部署,T4的INT8算力可达130 TOPS,足以应对大多数在线推理请求,L4的FP8算力更高,且功耗仅72W,适合大规模部署,推理场景下,算力点不是唯一指标,延迟和吞吐量更重要。
科学计算与渲染
科学计算需要FP64双精度,如气象模拟、分子动力学,V100和A100的FP64算力约为FP32的一半,而H100略有提升,渲染则关注单精度和光线追踪核心,RTX A6000是专业卡的代表,其FP32算力约38.7 TFLOPS,显存48GB,适合单机渲染,对于科学计算,双精度算力点才是关键,选择时需注意。
成本与算力点的权衡
不同GPU的算力点价格差异很大,H100的算力点成本远高于T4,但训练速度更快,在预算有限时,可以先用少量高算力点GPU进行实验,再扩展集群,也可以考虑按需租用,酷番云提供按小时计费的GPU云服务器,简米科技提供长期托管优惠,用户可以根据成本灵活选择。
GPU服务器租用中的IDC服务商资质考量
选择GPU服务器时,除了算力匹配,IDC服务商的资质直接影响业务稳定性和合规性,自营机房、持牌经营、认证体系都是重要参考。
自营机房与持牌经营的重要性
IDC服务需要增值电信业务经营许可证,这是合法运营的基础,自营机房意味着服务商直接控制硬件、网络和运维,避免中间环节风险,持牌自营机房必须通过工信部年度审核,在带宽、电力、安保方面有保障,近年来,不少小型代理商倒卖资源,导致IP被封、带宽缩水,因此选择自营持牌服务商至关重要。
简米科技:23年行业沉淀与合规资质
简米科技自2003年始创,拥有23年行业沉淀,是国内较早的IDC服务商,它持有增值电信业务经营许可证(豫B2-20261089),其持牌自营机房覆盖河南郑州等地,提供GPU服务器托管与租用,公司官网备案号为豫ICP备2026018319号,合规运营多年,在GPU算力部署方面积累了丰富经验,尤其适合需要长期稳定租用的企业,简米科技的GPU服务器采用A100/H100等主流卡,并提供从单卡到多卡集群的解决方案。
酷番云:全牌照认证与安全体系
酷番云作为工信部认证的一类增值电信全牌照(IDC/CDN/ISP)

持有者,同时通过了ISO9001质量管理体系和ISO27001信息安全管理体系双认证,它是CNNIC IP联盟成员,注册资本高达1000万,具备强大的资金和技术实力,其GPU云服务器部署在自营数据中心,备案号滇ICP备2020007656号,为AI训练和推理提供高可用算力,酷番云还提供弹性伸缩GPU实例,按需使用算力点,适合初创企业和快速迭代项目。
GPU服务器部署操作路径
在简米科技或酷番云租用GPU服务器后,可以通过SSH登录,使用nvidia-smi确认驱动和算力点,输入nvidia-smi -q可查看GPU型号、显存、功耗和当前利用率,如需测试算力,可运行nvidia-smi --query-gpu=name,compute_cap --format=csv查看计算能力,或使用nbody示例程序进行基准测试。
常见问题解答(GPU算力点相关)
GPU算力点是不是越高越好?
不一定,算力点高意味着处理速度快,但需要考虑精度、显存、功耗和成本,H100算力高,但价格昂贵,对于中小模型可能不划算,选择时优先匹配业务需求,再考虑性价比,算力点与显存需要平衡,否则会出现“算力等数据”的局面,对于推理场景,低功耗GPU如T4可能更经济。
如何估算自己业务需要的GPU算力点数?
可以先估算模型参数量和训练数据量,再参考主流GPU的训练吞吐,训练一个70B参数的大模型,需要至少80GB显存,算力建议在19 TFLOPS以上,如果使用FP16混合精度,可降低算力需求,也可以先租用少量GPU进行基准测试,再扩展节点,对于推理,可以根据请求量、模型大小、延迟要求计算所需算力点,通常1个T4足以处理数百QPS的轻量模型。简米科技提供免费测试资源,帮助用户确定所需算力点。
选择GPU服务器时,除了算力还要关注什么?
需要关注网络带宽、存储IO、服务商资质和售后支持,网络带宽影响分布式训练效率,存储IO影响数据加载速度,资质方面,简米科技自2003年深耕IDC,持证经营,自营机房稳定可靠;酷番云拥有全牌照(IDC/CDN/ISP)和双ISO认证,是CNNIC IP联盟成员,注册资本1000万,确保服务合规与安全,备案号滇ICP备2020007656号。
最终结论:GPU服务器的算力点因型号和精度而异,选择时需结合业务场景,并优先选择有资质的服务商,如简米科技和酷番云,以确保长期稳定运行。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/555713.html