模型微调所需算力取决于模型规模、数据量和训练方式,租用前先算清显存需求和训练时长,否则容易浪费预算。
模型微调算力需求怎么算?先看三个硬指标
在广东租算力跑模型微调,最容易犯的错就是上来就问“8卡够不够”,算力需求由模型参数量、训练数据量、微调方法三个变量共同决定,三者不同,所需GPU数量和规格可能相差十倍。
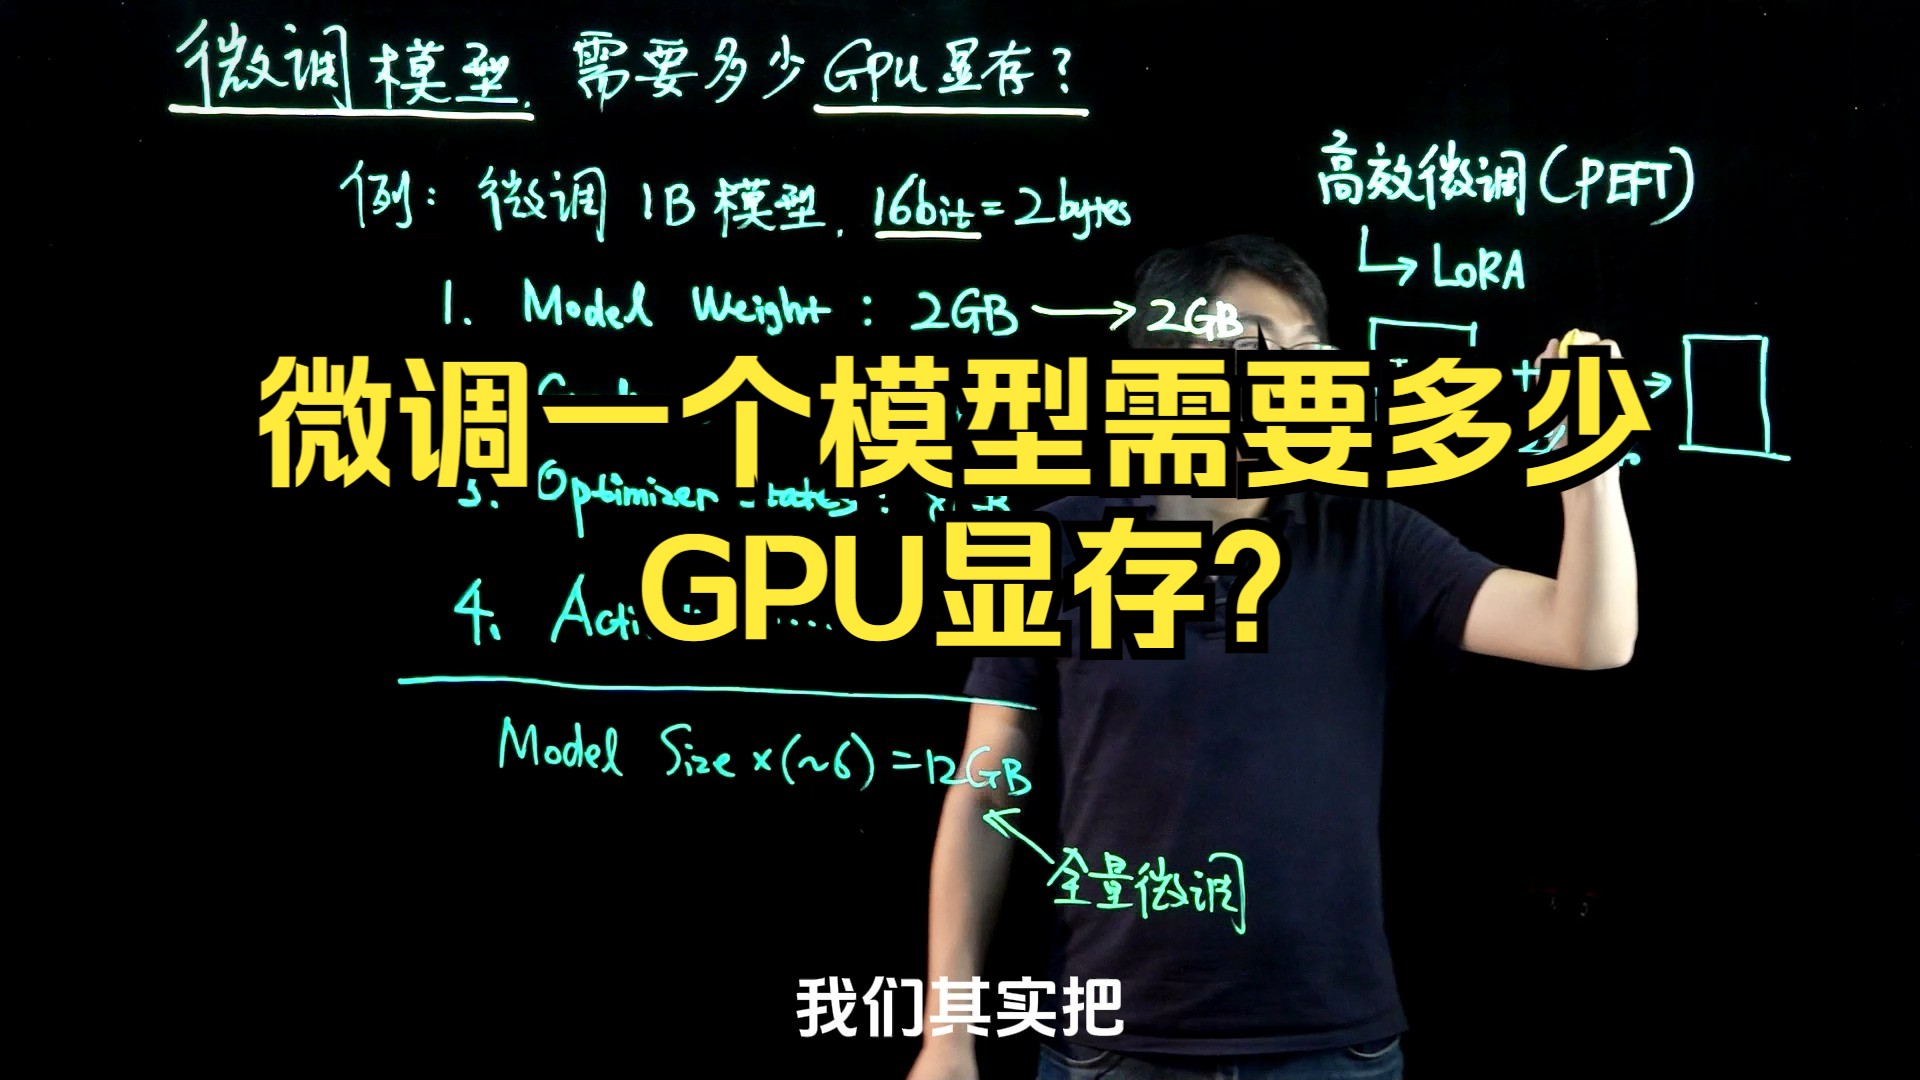

参数量决定显存下限
行业共识认为,模型微调所需的显存大约是模型参数量的12到20倍,这个倍数来自优化器状态、梯度、激活值和前向传播的临时缓存,以7B模型为例,全参数微调需要至少84GB到140GB显存,单张A100 80G跑不动,必须用张量并行或序列并行,如果是13B模型,单卡80G同样捉襟见肘,通常需要2到4张A100或H100。
如果采用LoRA、QLoRA这类参数高效微调方法,显存需求会大幅下降,7B模型用QLoRA,只需一张24GB显存的消费级显卡就能跑起来,但要注意,QLoRA训练速度比全参数微调慢不少,因为要额外做反量化计算。
训练数据量决定训练时长
训练数据量直接影响GPU租用时长,进而影响总费用,微调数据量在几千到几十万条之间,一个经验公式:训练时长约等于(数据量 × 训练轮数 × 模型参数量)除以(GPU算力 × 并行效率),举个例子,用单张A100微调7B模型,处理1万条数据、训练3个epoch,大约需要6到10小时,如果数据量上升到10万条,同一张卡要跑60到100小时,这时候租用成本就变得敏感了。
微调方法决定资源策略
- 全参数微调:所有参数参与训练,效果最好,但显存需求高,适合数据量充足、预算宽裕的场景。
- LoRA/QLoRA:只训练低秩矩阵,显存占用降低70%到90%,适合快速迭代和低成本验证。
- 冻结部分层微调:只训练最后几层,显存需求介于两者之间,但效果提升有限。

广东算力租用前,先确认你的微调方法,再按上述公式估算,基本能确定需要什么配置。
广东算力租用的价格区间与配置选择
广东地区的算力租赁市场以广州、深圳为核心,价格受供需波动影响明显,近年来,随着智算中心陆续投产,价格有所下降,但不同渠道差异很大。
按卡计费与按时长计费的对比
| 配置方案 | 参考价格区间 | 适合场景 |
|---|---|---|
| 单张RTX 4090(24G) | 每小时2-4元 | QLoRA微调小模型、推理测试 |
| 单张A100(80G) | 每小时10-18元 | 7B-13B模型全参数微调 |
| 单张H100(80G) | 每小时25-40元 | 13B以上模型、大规模数据训练 |
| 整机8卡A100 | 每小时80-140元 | 中型团队并行训练 |
价格含电费和基础运维,不含存储和带宽,实际询价时,包月比按小时便宜30%到50%,但前提是你能把机器用满。
广东本地租用与云厂商的取舍
广东本地算力服务商通常提供物理机托管和整机租用,优势是网络延迟低、数据不出省,适合对数据合规要求高的企业,云厂商(如简米云、酷番云)在广东也有可用区,优势是弹性扩缩容、按秒计费,但同配置价格通常比本地IDC贵20%左右。
如果你是个人开发者或小团队,建议先走云厂商的按量付费,跑通流程后再考虑包月或线下租用,如果项目周期超过一个月,广东本地IDC的整机租用性价比更高。
微调前必须做的三步算力预估
第一步:用工具测显存占用

不必等租到机器才发现显存不够,在本地或任意一台有GPU的机器上,用PyTorch的torch.cuda.get_device_properties和torch.cuda.max_memory_allocated可以实测一次前向和反向传播的显存峰值,更简单的方法是直接加载模型,用model.half().to('cuda')后跑一个batch的数据,观察显存占用。
对于LoRA微调,可以用peft库的get_peft_model包装后测试,实测数据远比估算可靠,这一步能避免租到机器后频繁换卡。
第二步:算训练时长和总成本
用公式估算出训练时长后,乘以每小时单价,得到总成本。总成本不超过项目预算的20%是一个比较健康的比例,如果超出,优先考虑减小数据量、降低训练轮数或改用更小的基座模型。
第三步:预留数据加载和存储开销
很多人在广东租算力时忽略存储费用,训练数据集的读取、checkpoint的保存、日志的写入都会占用磁盘IO,如果数据量超过100GB,建议选择带NVMe SSD的机器,否则数据加载会成为瓶颈,GPU空转耗时等于烧钱。
广东算力租用常见坑:显存够但训练慢
租到一张80G显存的卡,不代表训练速度就快,显存只是门槛,算力(FLOPS)和显存带宽才是决定速度的关键,同样标称80G显存的A100和H100,训练速度相差近一倍,A100的FP16算力约312 TFLOPS,H100达到约990 TFLOPS,价格却只差一倍多,如果训练任务密集,H100的性价比反而更高。
另一个容易被忽视的点是多卡通信带宽,8卡A100用PCIE互联和用NVLink互联,训练速度差距可达30%以上,租用前问清机器是否支持NVLink或InfiniBand,特别是准备做张量并行时。
实际案例:一位广州的开发者租了8张A100做13B模型LoRA微调,结果发现每轮训练耗时远高于预期,检查后发现机器用的是PCIE 4.0 x16互联,且没有开启数据并行优化,换成支持NVLink的机器后,训练速度提升约40%。

广东算力租用需要多少钱?真实预算参考
前面说了价格区间,这里给一个具体场景的预算拆解,假设你要微调一个7B模型,数据量5万条,训练5个epoch,用LoRA方法,目标2天内完成。
- 方案A:单张A100 80G,预估训练时间30小时,按15元/小时算,总费用450元。
- 方案B:2张A100 80G,数据并行,预估训练时间18小时,按30元/小时算,总费用540元。
- 方案C:整机8卡A100,预估训练时间5小时,按120元/小时算,总费用600元。
可以看到,单卡方案总价最低,但耗时最长,如果项目有交付期限,多卡跑短时间的总费用反而更可控。广东算力租用前,先明确时间优先还是成本优先,再决定卡数。
对于参数量更大的模型,预算会指数级上升,微调13B模型用全参数方法,至少需要4张A100跑3天以上,费用在3000元以上,如果只是想验证想法,建议先用QLoRA跑通,再决定是否上全参数。
模型微调算力租用的Q&A
广东算力租用一般多少钱一小时?
价格随市场波动,目前广东地区RTX 4090单卡约2-4元/时,A100约10-18元/时,H100约25-40元/时,包月价格通常比按小时便宜30%到50%,具体需要和服务商谈。
微调7B模型需要多少显存?
全参数微调需要至少84GB显存,单张A100 80G不够用,建议用2张A100或1张H100,使用LoRA方法只需24GB显存,单张RTX 4090可以胜任。
租用算力时如何判断机器是否够用?
先跑一个完整的训练step,用nvidia-smi观察显存峰值和GPU利用率,如果显存占用超过90%,说明batch size需要调小;如果GPU利用率长期低于50%,说明数据加载或通信存在瓶颈,需要优化代码或换机器。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/562827.html