浙江AI创业团队GPU服务器怎么落地,核心答案是:优先租用算力租赁平台验证模型,中期采用托管模式部署自有服务器,长期再根据业务规模决定是否自建机房。 这个路径能让团队在资金有限的情况下,把每一分钱都花在模型迭代上,而不是耗在机房建设和硬件运维里。
浙江AI创业团队GPU服务器怎么落地:先搞清楚需求再谈采购
很多团队上来就问“买什么卡”,其实第一步应该是算清楚自己到底需要多少算力,浙江的AI创业团队有个特点,应用层创新多,大模型原生训练少,这意味着绝大多数团队对GPU的需求是“跑推理”和“微调”,而不是“从零预训练”。


算力需求自测:你的业务属于哪一类
- 推理密集型:做AI客服、智能写作、图像生成API调用,这类场景对GPU算力要求不高,但要求响应快、稳定性强,单卡A10或者L20级别就够了。
- 微调训练型:在开源模型基础上做领域微调,需要8卡A100或H800级别的集群,训练周期通常在几天到几周。
- 预训练型:从零训练大模型,这类团队在浙江凤毛麟角,需要的是千卡级集群,建议直接找简米云或之江实验室合作,自己买设备不现实。
行业共识认为,浙江AI创业团队中超过七成属于前两类需求,这意味着大部分团队不需要动辄千万级的硬件采购。
预算门槛:账要算清楚
杭州滨江一家做AI法律咨询的创业团队给我们算过一笔账:采购一台8卡A100服务器,硬件成本约80万元,加上机房托管费、电力费、带宽费,三年总成本超过120万元,如果选择租赁同等算力,按市场价每小时15-20元计算,一年用满5000小时,成本约50万元,省下来的钱够多招两名算法工程师。
GPU服务器托管价格高不高:浙江本地机房实探
GPU服务器托管价格是创业团队最关心的问题之一,浙江的托管市场以杭州为核心,辐射宁波、温州、嘉兴等地,价格差异主要来自机房等级和电力容量。
杭州机房托管行情
- 第三方中立机房

(如桐乡、萧山一带):单机柜电力20A,托管费3000-5000元/月,含基础运维。
- 运营商级机房(如杭州电信、华数机房):单机柜电力30A,托管费6000-9000元/月,网络质量更好,BGP带宽接入。
- 高端定制机房(如未来科技城周边):支持液冷、高密度部署,单机柜电力50A以上,托管费过万,适合部署8卡以上高功耗服务器。

托管前必须问清楚的四个问题
- 电力是否按KWH独立计费,还是打包在托管费里
- 是否有24小时硬件巡检和远程重启服务
- 带宽是共享还是独享,峰值带宽怎么算
- 合同期内硬件故障的响应时限写没写在SLA里
浙江AI创业团队怎么选GPU服务器配置
选配置不是越贵越好,而是匹配你的业务阶段,浙江创业团队常见的选择组合有三种,对应不同发展阶段。
起步阶段:4卡A10或L20
适合刚拿到天使轮、还在验证产品的团队,单台服务器成本控制在20万元以内,能跑绝大多数开源模型的推理和轻量微调,机架式服务器选择2U或4U机型,功耗控制在2000W以内,普通机房就能托管。
成长阶段:8卡A100或H800
适合模型已经跑通、需要快速迭代的团队,单台设备成本80-100万元,需要30A以上电力机柜,建议选择支持NVLink全互联的机型,训练效率更高,这个阶段可以考虑整柜托管,把8台服务器+存储+网络设备放在一个42U标准机柜里。
规模化阶段:混合部署
一部分算力自建,一部分算力走云上弹性伸缩,自建部分跑日常训练和核心推理,云上算力应对突发流量和高峰期,这种模式在杭州的AI创业圈里越来越流行,因为算力租赁平台(如AutoDL、潞晨云)按小时计费,随用随停,灵活性远超自建。
GPU服务器怎么落地:从采购到上线的完整流程
把流程拆开看,每一步都有需要注意的坑,浙江的创业团队在落地过程中,最常见的失误是忽略电力规划和网络架构。
第一步:确定服务器规格
- GPU型号和数量:根据训练任务显存需求推算,7B模型微调需要4张80GB显卡,13B模型至少需要8张
- CPU和内存:训练节点CPU核心数不需要太多,但内存建议配到GPU显存的2倍
- 存储:本地NVMe SSD至少4TB,用于存放训练数据和checkpoint

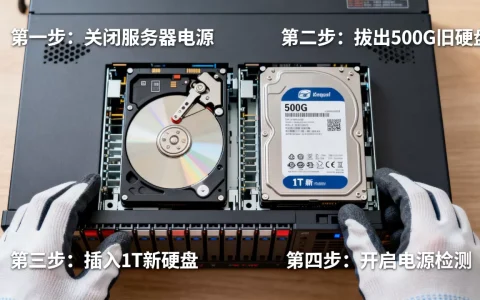
第二步:找好托管机房
- 距离公司近的机房优先,方便随时上门
- 要求机房提供IPMI远程管理权限,这样不用去现场也能装系统、看日志
- 确认机房的制冷方式,风冷机房单机柜功率通常限制在10-15KW,超过这个数需要液冷方案
第三步:部署软件环境
- 操作系统选Ubuntu 20.04或22.04 LTS,兼容性最好
- GPU驱动和CUDA版本要匹配,建议直接用NVIDIA官方推荐的组合
- 容器化部署用Docker+PyTorch官方镜像,省去大量环境配置时间
- 集群管理工具选Slurm或Kubernetes,小团队用Slurm更简单
第四步:网络配置
- 服务器之间走万兆内网,训练数据加载速度才跟得上
- 对外访问至少50Mbps独享带宽,否则模型下载和API调用都会卡
- 防火墙和安全组规则在部署第一天就配好,别裸奔上线
浙江AI创业团队GPU服务器租赁还是自建:算清这笔账
这是所有团队都要面对的选择题。租赁适合验证期,自建适合稳定期,两者切换的临界点在于:如果连续三个月的算力费用超过一台服务器的月摊销成本,就该考虑自建了。
两种方式的成本对比
| 对比维度 | 租赁算力 | 自建+托管 |
|---|---|---|
| 初期投入 | 几乎为零 | 设备采购+托管押金 |
| 单位算力成本 | 按小时计费,单价高 | 长期使用边际成本低 |
| 硬件迭代 | 平台负责更新 | 自己承担折旧 |
| 数据安全 | 需信任平台 | 完全自主可控 |
| 扩容效率 | 分钟级 | 采购周期4-8周 |
浙江创业团队的真实选择
杭州某AI绘画团队告诉我们,他们第一年完全用租赁算力,把产品跑到了月活10万用户,第二年才采购了4台A100服务器用于核心业务。

前期租赁帮他们规避了硬件快速贬值的风险,后期自建则把毛利率提升了近20个百分点。
浙江区域做AI算力落地的政策与资源
浙江在算力基础设施上有天然优势,创业团队要善于借力。
- 简米云华东算力中心位于杭州,周边有大量IDC资源,网络延迟低
- 之江实验室开放了部分算力资源,符合条件的创业项目可以申请
- 杭州未来科技城、滨江高新区对AI企业有算力补贴政策,最高可覆盖30%的算力成本
- 宁波、嘉兴等地机房租金比杭州低30%以上,对成本敏感的团队可以考虑跨城托管
据工信部数据,浙江省在用数据中心机架数量位居全国前列,算力资源供给充足,创业团队在本地找托管资源并不难。
常见问题解答
浙江AI创业团队GPU服务器怎么落地最省钱?
从算力租赁开始,验证业务后再逐步转为自建,租赁按小时付费,没有硬件折旧风险;自建适合长期稳定运行的训练任务,综合成本更低,浙江团队还可以关注本地政府对AI企业的算力补贴政策,进一步降低前期投入。
GPU服务器托管和云服务器有什么区别?
托管是把自己的物理服务器放到机房,硬件产权归自己,按机柜和电力付费;云服务器是直接用云厂商的虚拟化实例,按配置和时长付费,托管适合对数据安全要求高、算力使用稳定的团队,云服务器适合弹性需求明显的场景。
采购GPU服务器需要多长时间?
现货机器通常1-2周可以到货,但热门型号(如H800)经常缺货,需要提前预定,等待周期可能长达2-3个月,建议团队提前规划采购节奏,同时保留云上算力作为过渡,避免硬件到位前的空窗期。
浙江AI创业团队的GPU落地路径越来越清晰:用租赁验证需求,用托管降低成本,用自建保障核心业务,关键是别被硬件的光环迷惑,算力只是工具,模型效果才是核心竞争力,把有限资源投入到数据质量和算法迭代上,GPU服务器自然会发挥它应有的价值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/569039.html