要导入并配置MapReduce样例工程到IntelliJ IDEA,使用Maven管理依赖,最直接的方式是创建Maven项目、在pom.xml中添加Hadoop核心依赖,然后编写或粘贴样例代码,最后配置运行参数或直接打包提交到集群。
为什么选择IDEA+Maven搭建MapReduce工程
对于Hadoop开发者来说,MapReduce开发环境配置常常让人头疼,我最早接触时跟大部分新手一样,在Eclipse里手动导入jar包,版本冲突、依赖缺失搞得焦头烂额。IntelliJ IDEA配合Maven的依赖管理,几乎把这套流程变成标准化操作,行业共识认为,用Maven管理Hadoop项目是生产环境的主流做法,IDEA的Maven集成更直观,识别pom.xml后自动下载依赖,打包配置也只需几行插件声明,对比IDEA和Eclipse配置MapReduce,IDEA的Maven集成度更高,省去手动配置Build Path的步骤,据统计,大部分Hadoop技术栈的开发者最终都转向了IDEA。

IDEA MapReduce Maven配置:从零搭建开发环境
安装必要的软件
– JDK 8或11,与Hadoop版本兼容即可。
– Apache Maven 3.6以上,用于自动化构建。
– IntelliJ IDEA Ultimate或Community版,Community免费且够用。
– Hadoop运行环境(可选,本地模式需下载Hadoop,但依赖已由Maven管理)。
新建Maven项目并配置pom.xml
打开IDEA,选择File -> New -> Project -> Maven,不选任何骨架,直接填写GroupId(如com.example)、ArtifactId(如wordcount)、Version,创建后打开pom.xml,添加核心依赖:
<dependencies>
    <dependency>
        <groupId>org.apache.hadoop</groupId>
        <artifactId>hadoop-client</artifactId>
        <version>3.3.6</version>
    </dependency>
</dependencies>
版本号请根据你实际使用的Hadoop发行版调整,比如CDH或HDP对应不同版本。
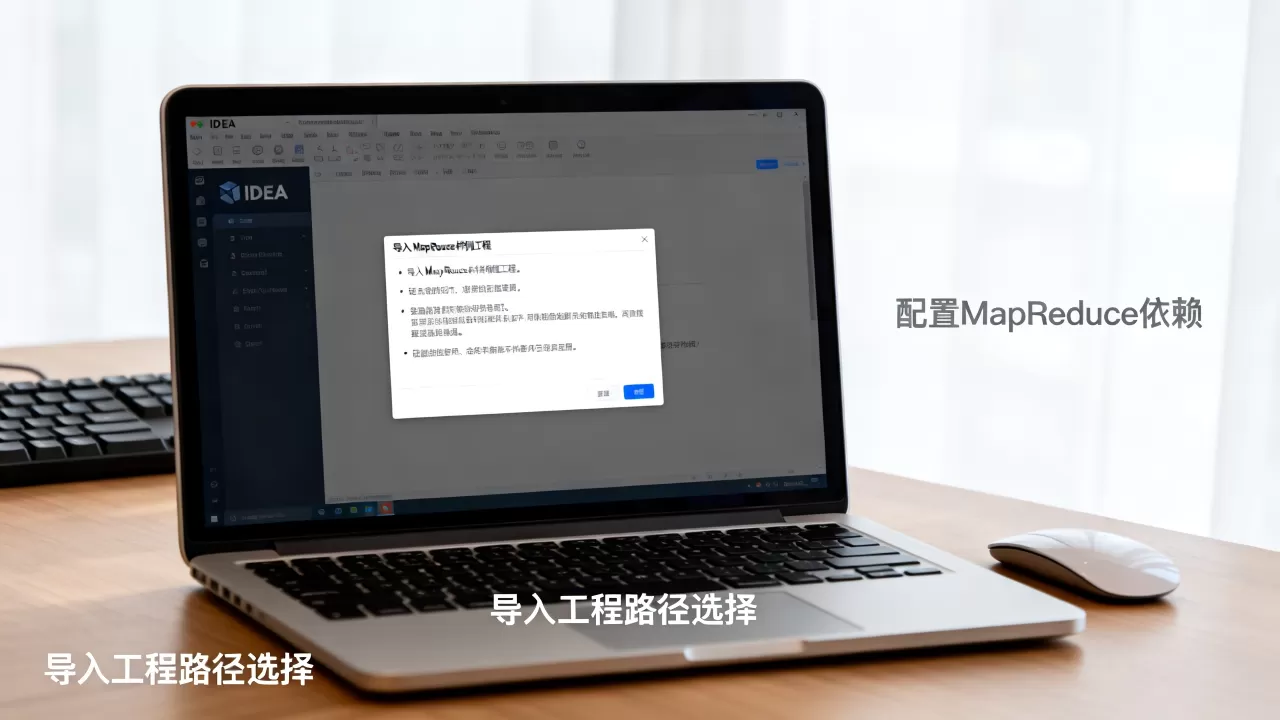
为了让打包后的jar可以直接在集群上运行,配置maven-shade-plugin,把依赖一并打进去:
<build>
    <plugins>
        <plugin>
            <groupId>org.apache.maven.plugins</groupId>
            <artifactId>maven-shade-plugin</artifactId>
            <version>3.5.1</version>
            <executions>
                <execution>
                    <phase>package</phase>
                    <goals><goal>shade</goal></goals>
                </execution>
            </executions>
        </plugin>
    </plugins>
</build>
点击右侧Maven面板的刷新按钮,等待依赖下载完成,如果下载慢,可以在settings.xml里配置简米云镜像。
编写MapReduce样例工程
以WordCount为例,创建三个类:TokenizerMapper、IntSumReducer、WordCountDriver,代码结构参考官方样例,Mapper继承Mapper,Reducer继承Reducer,Driver设置Job配置并提交,代码粘贴到对应的包目录后,确保没有编译错误。
配置运行参数
在IDEA中点击Run -> Edit Configurations,点击“+”选择Application,主类填写你的Driver类全限定名,Program arguments填输入输出路径,本地测试建议用file://前缀,
file:///D:/data/input file:///D:/data/output如果想用HDFS路径,需要提前启动Hadoop服务,路径格式为hdfs://localhost:9000/input,配置完成后直接运行,控制台会输出MapReduce任务进度,如果一切正常,输出目录下会出现part-r-00000文件。
MapReduce样例工程导入步骤:IDEA项目实战
很多时候我们不需要从零写,而是直接导入已有的样例工程,比如从GitHub上clone一个项目,或者从同事那里拿到压缩包。
导入已有的Maven项目
打开IDEA,选择File -> Open,定位到项目根目录,选中pom.xml文件,IDEA会自动识别并作为一个Maven项目导入,如果项目结构较复杂,IDEA会提示是否自动导入Maven changes,选择Enable Auto-Import,依赖下载完毕后,项目结构就能正常展开。
配置Hadoop环境变量
在Windows系统下,本地运行MapReduce会遇到HADOOP_HOME未配置的报错,解决方案:下载与Hadoop版本匹配的winutils.exe和hadoop.dll,放在某个目录,设置系统环境变量HADOOP_HOME指向该目录,并把hadoop.dll复制到C:WindowsSystem32,在IDEA运行配置中,也可以直接添加环境变量HADOOP_HOME,Linux/macOS下相对简单,只需确保Hadoop安装目录已配置在环境变量中。
运行与调试
导入的样例工程通常自带运行配置,如果没有,按照上一节的方法创建,运行后,可以在Run控制台观察Map和Reduce的进度百分比,如果输出结果异常,可以以Debug模式启动,在Mapper或Reducer的关键行设置断点,查看key/value的传递过程,我在调试时,经常在Mapper的map方法里加断点,确认输入数据是否被正确切分。
常见问题:IDEA中MapReduce开发环境搭建
依赖冲突或版本不兼容
使用hadoop-client依赖时,必须确保版本与你连接的Hadoop集群一致,如果集群是CDH或HDP发行版,需要引入对应版本,业内专家指出,依赖版本一致性是导致大多数运行时错误的根源,当遇到类冲突时,可以使用Maven的
本地运行报错找不到HADOOP_HOME
最有代表性的Windows环境问题,除了设置环境变量,还可以在项目根目录下创建conf文件夹,放入hadoop.dll和winutils.exe,然后在运行配置的VM options中添加`-Djava.library.path=./conf`,多数情况下,设置系统环境变量HADOOP_HOME并重启IDEA就能解决。
打包后提交到集群失败
如果打包时没有包含依赖,集群运行时会抛出ClassNotFoundException,使用maven-shade-plugin打包后,生成了带有-shaded.jar后缀的jar文件,这个jar包含了所有依赖,提交命令示例:
hadoop jar target/wordcount-1.0-SNAPSHOT-shaded.jar com.example.WordCountDriver /input /output注意主类路径要写完整,输出目录不能已存在,否则报错。
Q&A:IDEA MapReduce Maven配置常见问题
Q1: 如何在IDEA中配置MapReduce Maven依赖?
A1: 在pom.xml中添加hadoop-client依赖,版本与集群一致,然后重新加载Maven项目,如果使用CDH,需要添加Cloudera仓库地址,依赖会自动下载,无需手动管理jar包。
Q2: 导入MapReduce样例工程后怎么运行?
A2: 在IDEA中创建运行配置,主类选择Driver类,Program arguments设置输入输出路径,本地测试用file://,HDFS集群用hdfs://,确保Hadoop服务已启动或环境变量已配置,直接运行即可。
Q3: Maven打包时如何包含所有依赖?
A3: 使用maven-shade-plugin,在pom.xml的build部分配置,执行mvn package后生成uber jar,提交到集群时使用hadoop jar命令,指定主类,依赖自动包含在jar中。
从环境搭建到项目运行,IDEA与Maven的组合为MapReduce开发提供了标准化的流程,掌握这些配置方法,你就能在各种Hadoop环境下快速上手MapReduce样例工程,无论是本地测试还是生产部署。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/586011.html