服务器里躺着2TB数据,别想着一次全拖下来,正确思路是用断点续传工具按队列批量拉取,配合压缩和分卷,两天内稳定落地。不少朋友第一次面对这个量级的数据,第一反应是挂个迅雷链接让同事点,或者压缩成一个包用浏览器硬下,这两种想法都可以理解,但实际操作起来,要么服务器带宽被跑满导致线上业务卡顿,要么传到一半连接断了,前功尽弃,处理2TB文件,本质上是处理传输的可靠性,而不是单纯追求瞬时速度。
服务器2t文件怎么弄出来先说最稳妥的核心逻辑
文件在服务器上怎么出来,取决于你手头有什么权限、服务器是什么系统、以及目标机器在哪里,但不管场景怎么变,答案都收敛到一条主线上:在服务器端部署一个支持断点续传的传输服务,客户端用对应工具去拉取。
搞清楚文件是“热数据”还是“冷数据”
热数据是网站程序、数据库文件、正在运行的日志,这些不建议直接打包下载,因为文件被占用时会报错,而且打包动作本身会吃CPU和内存,影响线上服务,冷数据是备份包、历史归档、图片视频素材这类不常访问的东西,随便折腾。
先花十分钟用du -sh /data看一眼目录大小分布,找到占空间的大头。如果是数据库文件,业内专家通常建议先用mysqldump或物理备份工具导出一次,再对导出结果做传输,直接拷数据目录的做法容易踩到文件不一致的坑。
首选Rsync,而不是打包下载
对于2TB这种量级,用rsync增量同步是最稳的,命令大概长这样:
rsync -av --progress --partial /data/ user@目标IP:/backup/
几个参数的说一下:
--partial保留传输中断的临时文件--progress显示进度-a归档模式保留权限和时间戳
这种做法的好处是,哪怕传了1.8TB时断网,恢复后它会自动对比,只传剩下没完成的200GB,不用从头来过,这是传输2TB文件最重要的续传能力。
服务器大文件传输方案对比三种常用路子
不同环境下,传输手段的选择直接决定了效率和稳定性,这里给出一组对比,供不同场景选用。

| 方案 | 适用条件 | 优点 | 缺点 |
|---|---|---|---|
| Rsync + SSH | Linux到Linux/Windows(需装客户端) | 增量同步,断点续传 | 单线程,速度受限于CPU |
| Rclone + 对象存储中转 | 服务器到云存储再下载到本地 | 支持多线程,云端加速 | 走公网上传也有时间成本 |
| 压缩分包 + HTTP/FTP下载 | 少量文件,目标机器随处可下 | 操作直观,适合小白 | 打包时间长,单包可能损坏 |
Linux服务器常规操作:用Screen配合Rsync
在Linux服务器上长时间跑传输任务,最怕SSH窗口一关任务就没了,用screen或tmux把任务挂后台,是每个运维的基本操作:
screen -S transfer
rsync -av --progress --partial /data/ user@目标IP:/backup/
然后按Ctrl+A+D分离会话,下次用screen -r transfer重连查看进度。本地没有静态IP或公网IP时,用Rsync推流往往走不通,那就改用Rclone从服务器拉到对象存储,再从本地下,对于2TB数据,这个中转思路目前是主流。
Windows Server的图形化方案
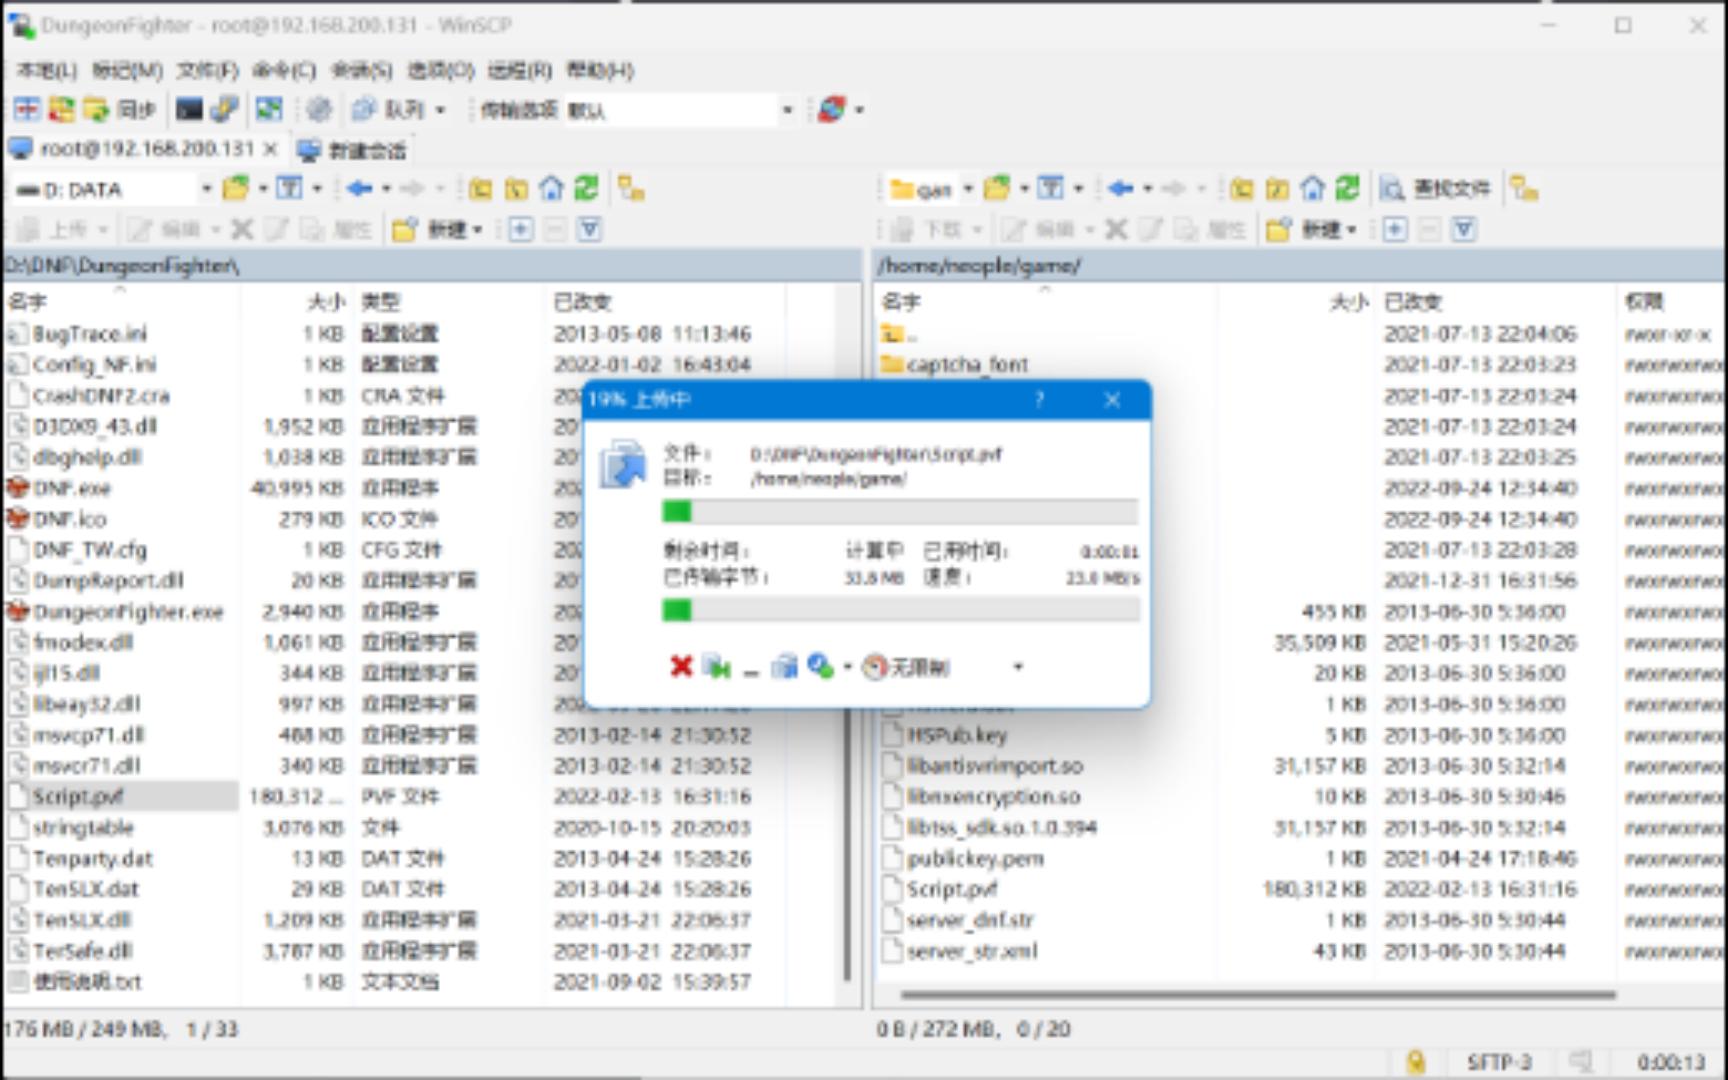
如果是Windows Server,图形化工具首选FTP服务搭配FileZilla客户端,在服务器上安装FileZilla Server,设置好端口和账号后,本地用FileZilla客户端连接,它天然支持断点续传,右键队列就能管理所有文件的传输状态。
注意一点:FTP默认端口21容易被安全组拦掉,记得在服务器防火墙里放行。文件数量多且零散时,FTP传输的单个文件排查能力不如Rsync,但胜在好上手。
文件太大先压缩还是直接传要分开看
压缩的代价
2TB数据压缩时间几个小时起步,而且压缩过程中一旦服务器负载过高,可能导致线上接口变慢,更重要的是,如果压缩到一半服务器重启,这个压缩包直接作废,影视素材、备份包这类本来就压缩过的文件,再压一遍体积也不会变小,纯属浪费时间。
不压缩的代价
不压缩直接传输,最直观的问题是文件数量多导致同步耗时增长,散文件遍历需要大量IO操作,动辄几十万个文件,光扫描目录就要半小时,行业共识认为,

把几十万个小文件打成几个大分卷,传输效率提升相当明显,操作上建议用tar分卷而非zip:
tar -czf - /data | split -b 50G - /backup/data.tar.gz.
这样每个分卷50GB,万一某个包传坏了,只需要重新下载对应的一个分卷,不用全盘重来。
传输完成后的校验
分卷传输完成后必须做校验,用md5sum生成每个分卷的哈希值,对比本地的校验文件,如果对不上,说明传输过程中出现了丢包,需要重传这个分卷,这一步不要省略,2TB数据出现几个损坏的包太正常了。
服务器文件下载速度慢怎么解决先看瓶颈在哪
很多人一传大文件就怪服务器带宽小,但真实情况往往不是这样,需要先做一次速度诊断:
- 本地用
iperf3测一下到服务器的带宽,如果上下行都在百兆以内,那是基础带宽问题 - 如果带宽充足但传输速度上不去,多半是单线程传输跑不满带宽,这时候要用多线程工具
多线程工具怎么选
Linux下用aria2,配合-x 16 -s 16参数开启16线程下载,对单文件提速很有效,如果你已经把2TB数据打包成多个分卷,那么在服务器上直接给分卷目录起个HTTP服务,本地用IDM(Internet Download Manager)创建多个下载任务并行拉取,比任何命令行工具都简单。
价格敏感型方案
预算有限的场景下,服务器2t文件怎么弄出来便宜确实是个问题,如果你只是偶尔传一次大文件,不介意多花点时间,直接买台按量计费的临时云服务器做中转,用内网传输,速度跑满千兆,成本可控,参考目前国内主流云厂商的定价,按量计费的流量费大约在0.5到1元每GB区间,2TB的传输成本在千元上下,这个价格多数人听了会觉得肉疼,但内网传输的速度优势是公网无法比的。
本地硬盘空间不足怎么办
2TB文件下到本地,如果发现本地磁盘剩余空间不够,可以用

Rclone Mount把服务器目录挂载为本地磁盘,先按需访问,再挑选重要文件下载,这不算严格意义上的“全部弄出来”,但能解决燃眉之急。
传完怎么确认文件没坏校验不可省
下载完成后,第一件事不是打开文件夹看,而是先比对哈希值,在服务器上生成校验文件:
md5sum /data/.tar.gz > checksums.txt
把这个文本文件一起下载到本地,然后执行:
md5sum -c checksums.txt
如果出现OK字样,说明这批文件传输没有问题,如果出现FAILED,针对那个分卷单独重新下载,不用全盘再来一遍,这一步也是很多新手最容易忽略的地方传完发现视频文件损坏,又得重传一次,耗时一整天。
Q&A:服务器2t文件怎么弄出来最容易踩的几个坑
问:传输到一半断网了,之前的进度还在吗?
看用的工具,Rsync和FileZilla都支持断点续传,只要没手动删除临时文件,重新连接后会自动跳过已传完的部分,继续传输剩余数据,如果用的是FTP命令行不带-c选项,或者HTTP下载没开断点续传,那就只能从头再来,所以传输开始前,先确认下载工具开启了断点续传选项。
问:文件量特别大,200个GB共享文件加上一堆小图片,总共2TB,直接传还是打包后再传?
建议打包分卷后再传,原因有两个:一是碎文件太多会拖慢磁盘IO,导致传输速率上不去;二是打包成几个大分卷后,断点续传的逻辑更清晰,哪个包坏了单独重下哪个,前提是打包时预留足够空间,用tar -czf - /data | split -b 50G - /backup/data.tar.gz.这套组合语句,不用在磁盘上产生完整中间文件。
问:服务器只有一台,本地电脑也需要这个数据,有没有最省事的办法?
给服务器装个同步盘程序,比如NextCloud或Seafile,把2TB文件放进同步目录,本地客户端自动同步,整个过程不用命令行,进度条可见,断点续传内置,文件多时还能按需同步,不过这个方案对服务器内存消耗稍大,部署前先确认内存不低于4GB。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/586401.html