Intel CPU 搭配 Intel MPI 在机器学习分布式训练中能够提供稳定高效的并行计算支持,特别适合中小规模集群和注重性价比的AI应用场景。
Intel CPU 在机器学习中的实际表现如何?
CPU 在机器学习中的角色定位
很多人以为机器学习只靠GPU,实际上CPU在完整流程中扮演着不可替代的环节,数据预处理、特征工程、模型推理中的低延迟场合,以及部分不依赖大规模矩阵运算的算法(如决策树、XGBoost),依然以CPU为主力,Intel CPU 凭借成熟的指令集生态和内存架构,在这些场景下表现出色。

Intel CPU 的指令集优势
Intel 从 Skylake 开始引入 AVX-512 指令集,后续又加入了 VNNI(向量神经网络指令),专门优化卷积和矩阵乘法的推理计算,行业共识认为,在推理吞吐量上,Intel Xeon 处理器配合 OpenVINO 优化工具,可以在不损失精度的情况下将速度提升 2-3 倍,Large Page 支持和 Cache 层次设计,使得频繁的参数交换场景下,CPU 的响应延迟远低于普通加速卡。
适用场景:中小规模训练与推理
- 单机训练:当模型规模不大(如 ResNet-50、BERT-base)且数据量有限时,CPU 完全胜任,不少高校实验室和学生项目用 Intel 酷睿 i9 或 Xeon 跑轻量级模型,成本可控。
- 推理部署:生产环境中,CPU 推理的灵活性更高,无需额外设备,维护简单,Intel 的 oneAPI 和 TensorFlow 的 CPU 优化,让模型在 Intel 芯片上运行丝滑。
- 混合负载:在分布式场景中,CPU 节点常作为参数服务器或数据加载器,负责协调 GPU 节点之间的通信,这时 Intel CPU 的稳定性和内存带宽成为关键。

Intel MPI 如何优化机器学习分布式训练?
MPI 在分布式训练中的必要性
分布式训练需要节点间频繁交换梯度或参数,消息传递接口(MPI)是底层通信的标准方案,Horovod、TensorFlow 分布式策略等主流框架都依赖 MPI 实现 AllReduce 操作,Intel MPI 是 Intel 基于 MPICH 优化的商业级 MPI 实现,针对 Intel 硬件做了深度适配。
Intel MPI 与 OpenMPI 对比
很多用户在搭建集群时会纠结“Intel MPI 与 OpenMPI 哪个更好”,下面从几个关键维度对比:
| 对比维度 | Intel MPI | OpenMPI |
|---|---|---|
| 硬件兼容性 | 对 Intel CPU 网络卡(如 OmniPath)有原生优化,自动检测拓扑 | 支持多种硬件,但部分场景需手动调参 |
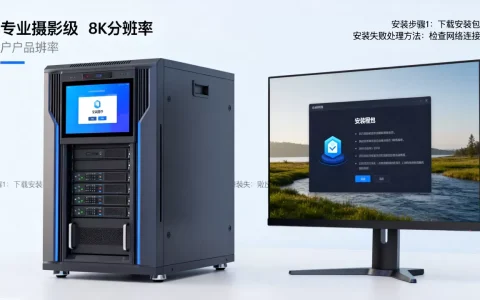
| 安装部署 | 提供一键安装包,包含常用运行时库,环境变量自动配置 | 通常需要编译源码,依赖库较多 |
| 通信性能 | 在 Intel 以太网和 InfiniBand 上延迟低,带宽利用率高 | 通用性强,但某些场景下性能不如 Intel MPI |
| 商业支持 | Intel 提供技术支持和更新,适合企业级用户 | 社区驱动,免费但无商业保障 |
| 价格 | 随 Intel 系统预装或单独授权,部分场景免费 | 完全开源免费 |
如果你的集群是 Intel CPU 配 Intel 网络,Intel MPI 开箱即用且性能更优;如果涉及异构硬件或预算极紧,OpenMPI 也是成熟选择,近年来,更多用户选择 Intel MPI 来减少调优时间。
Intel MPI 安装与配置步骤
以下是常见的操作路径,以 CentOS 7 为例:

- 下载 Intel MPI 库:从 Intel 官网或系统镜像中获得 l_mpi_2020.4.304.tgz 等版本。
- 解压并安装:
tar -xzf l_mpi_2020.4.304.tgz && cd l_mpi_2020.4.304 && ./install.sh,选择默认路径即可。 - 设置环境变量:
source /opt/intel/mpi/2020.4.304/env/vars.sh(根据实际路径)。 - 验证安装:
mpirun --version应显示 Intel MPI 版本信息。 - 编译测试程序:
mpicc -o test test.c并运行mpirun -n 4 ./test检查多节点通信是否正常。
在分布式训练中,只需在启动脚本中指定 mpirun -np 8 -hostfile hosts python train.py,Intel MPI 会自动优化节点间通信。
Intel CPU + Intel MPI 组合的性价比分析
集群搭建成本考量
对于预算有限的中小企业,一台 GPU 服务器往往需要 5-10 万元起步,而同等性能的 CPU 集群(4-8 台双路 Xeon 服务器)价格可能更低,且具有更高的灵活性,Intel CPU 的折旧周期较长,二手市场活跃,不少用户通过购买二手 Xeon 服务器搭配 Intel MPI 来搭建实验环境。
与 GPU 方案的成本对比
- GPU 方案:训练速度快,但显存限制大,且单卡昂贵(如 NVIDIA A100 单卡 5-6 万元),对于数据量在 10GB 以内的模型,GPU 利用率可能不足 30%,性价比不高。
- CPU 方案:每台双路 Xeon 服务器约 2-3 万元,4 台集群总价不到 10 万元,可同时处理多个小任务,Intel MPI 的零拷贝通信让节点间传输高效,接近单机性能。

适用场景:当你的模型训练需要频繁调整参数、数据预处理耗时较长,或者推理环节需要低延迟响应时,CPU 集群配合 Intel MPI 往往能更快回本。
地域性采购建议
Intel CPU 的采购渠道广泛,北京、上海、深圳等一线城市有大量认证经销商,提供整机定制和售后支持,如果你在二线城市,可通过线上平台对接本地服务商,并确认 Intel MPI 的授权是否包含在服务器报价中,部分地域经销商提供“硬件+软件”打包方案,能进一步降低集成门槛。
Q&A: Intel CPU 机器学习常见问题
Intel CPU 到底能不能训练深度学习模型?
能,但要看模型规模,对于 ResNet-50、BERT-small 等中小模型,使用 Intel 酷睿 i7 或 Xeon 跑几个 epoch 完全可行,特别是当数据量小于 1GB 时,CPU 训练速度不比入门级 GPU 慢太多,对于大规模模型(如 GPT-3),CPU 训练效率过低,更适合作为推理节点或参数服务器。
Intel MPI 与 OpenMPI 在性能上有多大差距?
在 Intel 硬件上,用 Intel MPI 跑集合通信(如 AllReduce)通常比 OpenMPI 快 10%-20%,具体取决于网络拓扑和消息大小,如果节点使用 Intel 以太网卡或 OmniPath,差距更明显,但 OpenMPI 在非 Intel 硬件上表现更稳定,所以选择前最好用实际模型跑一下基准测试。
Intel CPU 机器学习 价格 一般是多少?
一台适合机器学习的入门级 Intel 工作站(如 ThinkStation P520,配 Xeon W-2225)价格约 1.5-2 万元;双路 Xeon 服务器(如 Dell PowerEdge R740,配两颗 Xeon Gold 6248)约 3-5 万元,如果考虑二手,价格可降至 6000-1 万元,Intel MPI 软件通常随 Intel 集群工具包免费提供,无需额外付费。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/587189.html