可观测性不是简单装一套监控就能达成,因为监控回答“系统挂了没有”,可观测性回答“系统为什么挂、挂在哪、下一步会发生什么”,两者是不同维度的能力建设。很多团队误以为上了Prometheus加Grafana就算完成可观测性建设,结果故障发生时依旧两眼一抹黑,真正落地可观测性,需要从数据采集、指标设计、链路追踪、日志关联、组织协作等多个层面重构技术栈和工作流。
可观测性和监控的区别:理解“为什么”比“有没有”更重要
行业共识认为,监控体系的核心是预设已知风险,用阈值告警告诉你“CPU高了”“接口慢了”,但可观测性面向的是未知问题,它允许你在没有预设规则的情况下,通过探索数据找到根因。
监控是“已知的未知”,可观测性是“未知的未知”
- 监控模式:定义指标→设定阈值→触发告警→人工排查,这套流程天然依赖运维经验,对没见过的故障模式无能为力。
- 可观测性模式:全面采集事件发生时的所有上下文,包括请求链路、日志上下文、业务参数、资源水位,事后可以通过任意维度切片查询,像侦探一样还原现场。
举个具体场景:某电商大促期间订单量激增,监控系统告警“支付服务响应时间超过500ms”,团队登录服务器发现CPU和内存正常,数据库连接池也没满,最后查了链路追踪才发现是下游优惠券服务的Redis热点key导致线程阻塞,这个根因,监控根本无法预判,只有全链路数据能回答。
数据采集的深度和广度完全不同
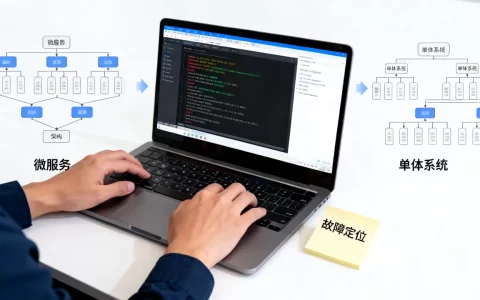
传统监控采集的是主机和中间件的离散指标,而可观测性要求三大支柱(Metrics、Logs、Traces)关联打通,很多团队装了一堆监控工具,但指标、日志、链路各自独立,故障时需要在三个系统间来回切换,手动对齐时间戳,真正的可观测性平台,应该能够通过一个请求ID,同时查看到这条请求经过的每个服务、消耗的时长、产生的日志、以及当时的系统状态。
设备供应商或云厂商提供的默认监控面板,覆盖的是基础设施层,业务层的可观测性,购物车放弃率突然升高”“推荐位点击率下跌”,这些必须由业务团队自己定义关键事件并埋点,工具只是载体,方法论缺失才是普遍痛点。
可观测性平台怎么选:先看团队现状,再谈工具
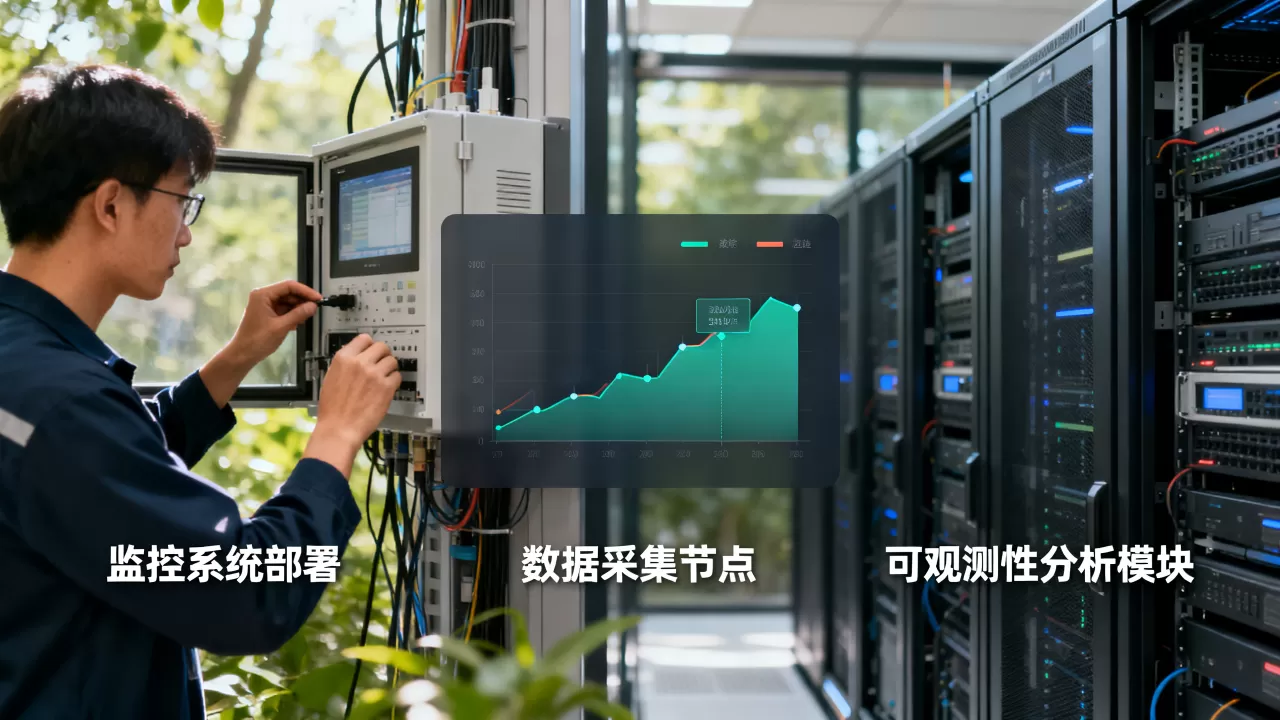
市面上的可观测性工具五花八门:开源的有Prometheus、Grafana、Jaeger、SkyWalking,商业的有Datadog、New Relic、简米云ARMS等,选择背后其实是团队技术栈、预算、运维能力的综合权衡。
自建开源方案的成本往往被低估
很多中小团队为了省钱选择自建,但只算了软件授权费,没算人力成本,Prometheus虽然部署简单,但要做到高可用、长期存储、多集群监控,需要额外搭配Thanos或VictoriaMetrics,链路追踪选Jaeger还是SkyWalking?日志系统用ELK还是Loki?每个组件都要有人维护,版本升级、性能调优、存储扩容都是隐性成本。
业内专家指出,一个中等规模(50个微服务)的团队,自建可观测性体系至少需要一位专职SRE投入半年时间,期间还要忍受功能不完整,商用SaaS方案按数据量收费,价格看似不低,但把人力成本算进去,对于百人以下的研发团队反而更划算。
多云和混合架构下的决策要点
如果业务部署在多家云厂商或自建机房,选择可观测性平台时需要重点考察数据接入能力和统一查询能力,一些平台对特定云厂商的深度集成会成为锁定风险,建议先用两周时间,让核心业务系统接入测试,对比不同平台的数据采集完整性、告警延迟、查询响应速度,顺便估算月度成本。
常见价格陷阱在于“按量计费”的隐藏成本,日志量增长、自定义指标增多、Trace采样率调整都会直接影响账单,选型时最好让厂商提供基于当前业务量级的预估报价,并预留50%的缓冲空间。
可观测性建设方案:从基础设施到业务价值的三个台阶
落地可观测性没有一蹴而就的方案,需要分阶段推进,每个阶段有明确的目标和验证指标。
第一阶:统一日志、指标、链路的数据接入规范
- 所有服务必须输出结构化日志,禁止用print拼接字符串。
- 统一Trace的透传协议(推荐W3C Trace Context),确保跨语言调用能串联。
- 明确指标命名规范,比如用
_total后缀表示计数器,_bucket后缀表示直方图。 - 在Kubernetes环境下部署全局的Agent服务,通过annotations自动发现上报端点。
这一阶段的目标是“能完整看到一次请求的来龙去脉”,完成标准是:随机抽取一个线上请求ID,可以在5分钟内找到所有相关日志和调用链。
第二阶:建立SLO驱动的告警体系
告别乱设阈值的时代,先用错误预算指导告警配置,例如某核心接口的SLO是99.9%可用性,一个月允许的不可用时间约43分钟,当错误预算消耗接近阈值时,才触发高优先级告警,而不是CPU一超过80%就半夜拉人起床。
- 把告警分成三类:页面告警(需要立即处理)、工单告警(当天处理)、巡检告警(周报里跟踪)。
- 为每类告警配置明确的责任人,避免“告警风暴”后大家都麻木。
- 定期做告警有效性复盘,删除无效规则,合并重复规则。
第三阶:利用可观测性数据驱动容量规划与性能优化
当数据积累超过三个月,可观测性平台就能发挥预测价值,比如通过分析历史流量趋势,预测下个月大促需要的Pod副本数;通过链路追踪找出耗时集中在哪个第三方调用,推动服务商优化;通过日志分析用户异常行为模式,提前发现薅羊毛风险。
杭州某物流公司的技术负责人分享过一个案例:他们通过转移链路数据发现,每次暴雨天气,调度系统的数据库慢查询数量翻倍,原因是查询SQL里没有带城市分区索引,这个发现不是监控告警触发的,而是团队在复盘一次超时事故时,通过Trace数据反向推导出来的。
可观测性和监控的区别为什么仍然被混淆
很多技术文章喜欢列举“监控与可观测性的差异对比表”,但实际工作中两者的边界越来越模糊,更多时候,混淆源于组织分工而非技术本身。
工具链碎片化加剧了认知偏差
大厂内部往往有多套监控系统:Zabbix看主机、Prometheus看K8s、Cat看业务、SkyWalking看链路、ELK看日志,每个系统都由不同团队维护,一线开发遇到问题需要登录五六个平台,复制粘贴各种ID,这种碎片化体验让很多人觉得“已经装了很监控,为什么还是救不了火”。
好的实践是打造一个统一的可观测性入口,比如在内部开发者平台中嵌入Grafana面板,通过单点登录和全局搜索,让所有数据在一个界面上关联,或者采用开源的OpenTelemetry作为统一数据采集标准,后端子组件可以逐步替换。
运维团队与研发团队协作模式需要改变
传统监控时代,运维负责看监控、接告警、抄单给开发,可观测性时代,开发必须主动消费数据,因为业务逻辑的根因只有写代码的人最懂,国内某头部云厂商内部推行“开发自监控”文化,要求每个服务Owner为自己负责的服务配置SLO面板,并每周review错误预算消耗情况,制度执行三个月后,线上故障平均恢复时间缩短了40%,告警数量反而下降了60%,因为他们在发布前就通过预发环境的链路分析拦截了问题。
可观测性是一种工程文化,不是仪表盘数量
回到开头的结论:监控是工具集,可观测性方法论,前者告诉你水泵压力超限,后者帮你理解为什么水管里流的是泥浆,每个团队都应该先盘点自己的故障盲区,再决定在数据采集、存储、分析、告警协作上的投入比例,与其纠结“装哪款监控软件”,不如先回答三个问题:你的请求链路是完整的吗?你的日志能反映业务状态吗?你的告警能直接定位到代码行吗?想清楚这些,才算是真正迈入了可观测性的大门。
可观测性平台常见问题解答
可观测性建设需要投入多少人力和预算?
取决于团队规模和业务复杂度,对于10人以下的初创团队,使用云厂商全托管方案加上OpenTelemetry SDK,一人兼职维护即可,月度成本几千元,百人以上且业务链路复杂的团队,建议配置专职SRE小组,采用混合方案:核心链路用商用平台,外围系统用开源组件,总成本控制在研发预算的3%到5%。
已经买了APM工具,还需要做日志集中管理吗?
需要,APM工具侧重调用链分析和性能诊断,日志则是查询业务异常细节的唯一权威来源,最合理的做法是让APM的Trace ID贯穿日志系统,通过Trace ID直接跳转到对应日志上下文,如果工具不具备该能力,考虑在日志采集端注入Trace ID字段,实现人工关联。
落地可观测性初期最容易踩的坑是什么?
过度追求全面的数据采集,导致存储成本失控和无效告警刷屏,建议从最高频的用户请求路径入手,只采集前三个核心服务的完整链路数据,其余服务先记录错误日志和基础指标,等团队熟悉了数据消费方式再逐步扩展,记住可观测性的目标是减少平均恢复时间,而不是收集所有数据。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/622342.html