大模型蒸馏训练通过知识迁移的方式,用较小规模的学生模型模拟大模型的输出行为,在显著降低算力消耗的同时保留绝大部分性能,训练成本可降至原来的数十分之一甚至更低。
蒸馏训练为什么省算力:从重复造轮子到跟着优等生抄笔记
想象一下,传统大模型训练就像每所学校都要求所有学生把整本百科全书从头抄一遍,每届学生抄的内容有大量重复,而真正需要掌握的解题思路却可能被淹没在抄写过程中。

大模型蒸馏训练改变了这个逻辑,它让一个已经训练好的大模型(教师模型)先产出高质量的“标准答案”,然后让一个小模型(学生模型)模仿这些答案,学生模型不需要看原始数据,只学习教师的输出逻辑,这种方式下,训练数据量级从几个TB压缩到几百万条问答对,训练步数大幅减少,硬件从几百张GPU卡缩减到几张卡就能完成。
算力开销到底差多少:一张表看懂
| 对比维度 | 传统预训练 | 蒸馏训练 |
|---|---|---|
| 训练数据规模 | 数十TB原始语料 | 数百万条教师输出数据 |
| 显卡需求 | 数百至上千张集群 | 数十张以内 |
| 训练时长 | 数月起步 | 数天至数周 |
| 算力成本 | 数百万级 | 数万至数十万级 |
| 性能保留度 | 基准水平 | 多数场景达到教师的90%以上 |
业内专家指出,蒸馏训练的整体算力消耗通常仅为原模型训练的一个零头,尤其适合预算有限但有明确垂直场景需求的团队。
算力节省的四个核心途径
蒸馏训练的算力节省不是单一因素促成,而是多个环节协同作用的结果,分解来看,主要有四条路径。
数据量级断崖式下降
原始预训练需要处理互联网级别的数据,其中存在大量冗余信息,蒸馏训练只保留教师模型的精华反馈,数据总量可能只有原来的千分之一不到,读更少的书,做更精准的练习,花费的时间自然不同。
具体而言,预训练阶段需要反复进行多轮epoch训练来拟合数据分布,而蒸馏阶段通常只跑一到两轮就能收敛,大幅减少了有效计算量。
模型参数量大幅缩减
学生模型的参数量可以比教师模型小一个数量级,教师模型如果是700亿参数,学生模型可能只需要7亿到30亿参数,参数少了,前向传播和反向传播的计算量直接下降,同样是训练一次,参数量减少80%意味着计算量接近同比例缩减。
蒸馏微调替换全量预训练
大部分应用场景不需要从零训练一个大模型,选择蒸馏路径意味着基座模型已经具备通用能力,只需通过蒸馏来压缩知识和特定能力,这相当于在已有地基上盖房子,而不是从挖地基重新开始。
行业共识认为,对多数企业而言,用开源的教师模型蒸馏出垂直领域的小模型,比购买大规模GPU集群性价比高出很多。
推理端算力同步降低
蒸馏不仅节省训练算力,部署后的推理开销也大幅降低,学生模型参数少,内存占用小,推理延迟低,高并发场景下,一台服务器能支撑的请求量可能是大模型的数倍,长期运营成本同样不可忽视。
蒸馏实操:具体步骤与关键配置
理解了原理,接下来看怎么落地,以下是一个标准的蒸馏训练流程细化拆解。
第一步:准备训练数据
- 收集目标领域的原始问题(几千到几万条即可)
- 将这些问题送入教师模型批量生成回答
- 对教师输出的数据进行清洗和过滤,去除低质量回答、重复内容、有害信息
- 格式整理为“输入+输出对”,存入JSONL文件备用
第二步:设置蒸馏参数
蒸馏训练的核心不是让学生模型一字不差复述教师输出,而是学习输出分布中的概率信息,温度参数在这一步起关键作用。
- 温度调高,学生能学到更多软化概率分布,泛化能力更强
- 温度调低,学生更贴近教师的高置信度输出,准确率更高
- 一般做法是温度从1.0起步,根据验证集效果微调
第三步:训练监督与验证
- 用LoRA等参数高效微调技术训练学生模型,只更新少量参数
- 训练过程中监控损失曲线,防止过拟合
- 用另一组教师输出作为验证集,每完成一个epoch评估一次学生输出与教师输出的相似度
- 如果相似度不再提升,提前终止训练,节省计算时间
不同场景下的蒸馏策略选择
蒸馏训练不是一个“万能药方”,不同场景适合不同策略。
垂直领域能力迁移
假设需要一个擅长客服问答的模型,业务数据集中在售后政策、退换货流程、产品操作手册等内容,这种情况最适合直接用教师模型生成问答对,然后蒸馏到7亿参数规模的学生模型,出参速度快,单条查询延迟在几百毫秒以内,部署成本低。
低成本多模型部署
如果研发团队需要在不同产品线部署多个模型,用同一个教师模型蒸馏出多个不同方向的轻量学生模型,整体训练成本仍然远低于分别训练多个大模型,比如此前有企业在一个教师模型基础上蒸馏出代码助手、法律问答、教育辅导三个方向的模型,总训练费用仅为原模型的十分之一左右。
边缘设备离线推理
手机、车载设备、IoT终端的存储和计算资源有限,将大模型蒸馏到十亿参数以下,量化后再部署到端侧,就能实现部分离线智能交互功能,这种场景下,蒸馏训练节省的算力让许多原本不可能的部署变成了现实。
大模型蒸馏和直接训练的区别在哪里:一个更贴近真实需求的对比
有团队在选型时会犹豫,到底直接从网上下载开源大模型微调,还是做完整蒸馏,这两条路线的本质差别在于:
输入数据的差异性
直接微调使用的是人工标注数据,标注成本随数据量线性上升,蒸馏使用的是教师模型自动生成的数据,标注环节被机器替换,成本几乎为零,从几百条数据扩展到几万条数据,微调的成本可能翻几倍,蒸馏的成本几乎不变。
效果上限差异
直接微调通常只改变模型的部分行为,蒸馏则可以完整迁移全套能力,如果教师模型具备多语言能力、复杂推理能力、特定格式输出能力,蒸馏后的学生模型这些能力都能继承,直接微调则往往只能强化一个方向,其他能力甚至会倒退。
一台服务器能做什么:入门级蒸馏训练配置清单
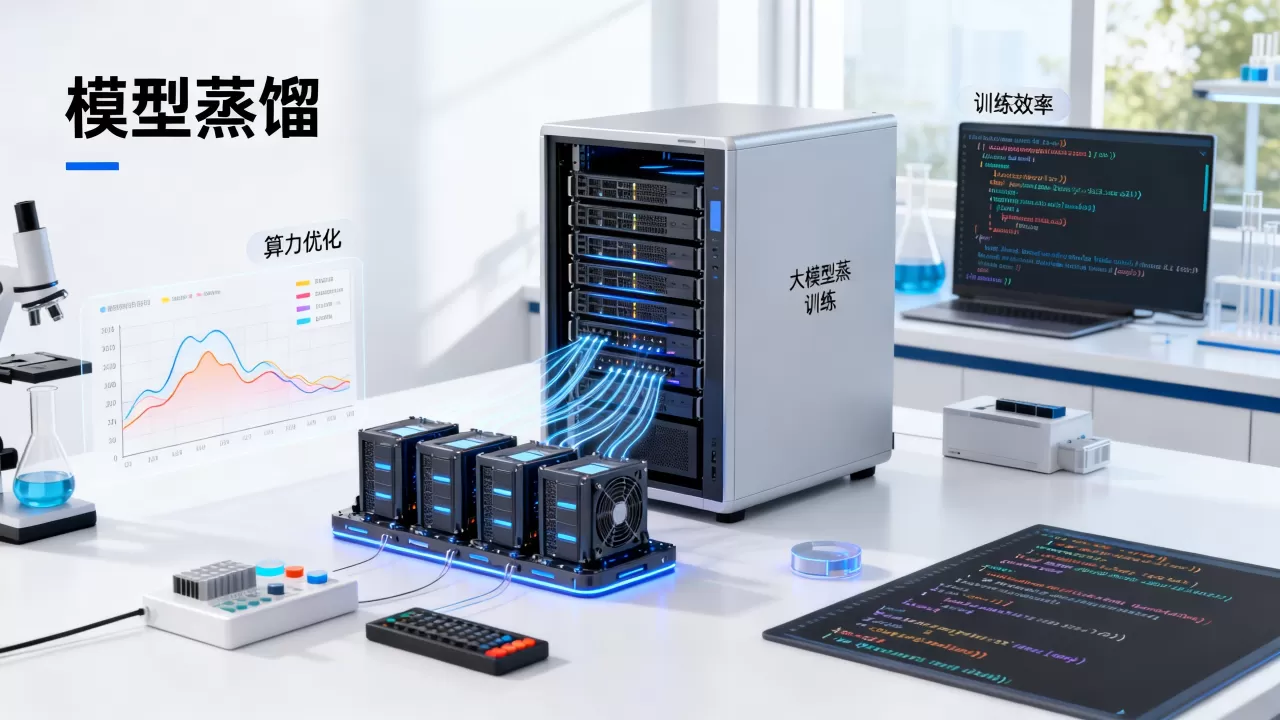
对于准备着手实践的团队,以下是一个可落地的硬件配置参考,成本大概在一台服务器十万元左右的投入范围。
最小可用配置
- 1张24GB显存的显卡,如RTX 3090或RTX 4090
- 128GB系统内存,加载教师模型到显存,学生模型训练放到同一张卡上
- 1TB NVMe固态硬盘,存储训练数据集和中间检查点
这个配置适合训练7亿参数以内的学生模型,yi’ge使用开源Qwen-7B作为教师、蒸馏出1.5B学生模型的标准流程,在这种环境下训练几十万条数据,耗时约两天。
推荐配置
- 2张48GB显存显卡,如A6000或L40S
- 256GB系统内存
- 2TB固态硬盘
该配置可以应对70亿参数级的学生模型训练,大多数实际业务场景在这个范围内已经能获得不错的性能。
Q&A:蒸馏训练相关的三个关键疑问
大模型蒸馏训练能省多少算力?有没有一个大致比例?
蒸馏训练相比传统预训练通常能节省90%以上的算力消耗,具体数据受教师模型规模、学生模型规模、数据量三个因素影响,教师模型越大、学生模型越小、数据量越少,节省效果越明显,一个量化参考是,700亿参数教师蒸馏到70亿参数学生的训练花费,大约只有原模型一次完整预训练花费的2%左右。
蒸馏后的模型会丢失哪些能力?
任何蒸馏都存在一定性能损失,数学推理、代码生成等依赖逻辑链的任务是损失高发区,因为小模型的内存容量限制了中间推理步骤的复杂度,情绪识别、风格模仿等非结构化任务通常损失较小,通过混合训练数据(同时包含教师输出和真实标注)可以减轻部分损失,但无法完全消除。
大模型蒸馏训练成本怎么算最准确?
总成本包括数据生成成本(调用教师模型推理的算力费用)、训练成本(学生模型训练时的GPU费用)以及人工调参成本,其中数据生成成本常被忽略,实际上如果教师模型很大、数据量很大,这一步的算力消耗可能超过训练本身,预算有限时建议优先控制数据总量,用数据质量换取数量。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/624419.html