GPU故障漂移是长训练任务最大的隐性杀手,它不会直接让训练崩溃,而是通过间歇性性能下降、微小计算错误和悄无声息的降频,让训练时间拉长、模型质量受损,甚至让数周的算力投入化为泡影。
GPU故障漂移到底“漂”在哪:从稳定到崩塌的四个阶段
GPU故障漂移(GPU Fault Drift)指的是显卡从健康状态到完全失效之间那段漫长的“亚健康”区间,这个过程中,GPU不会突然黑屏宕机,而是一点一点失去稳定性,长训练任务之所以最怕这种状态,在于它的欺骗性表面上一切正常,损失函数在下降,显存占用在跳动,但实际上硬件早已在出错边缘反复试探。

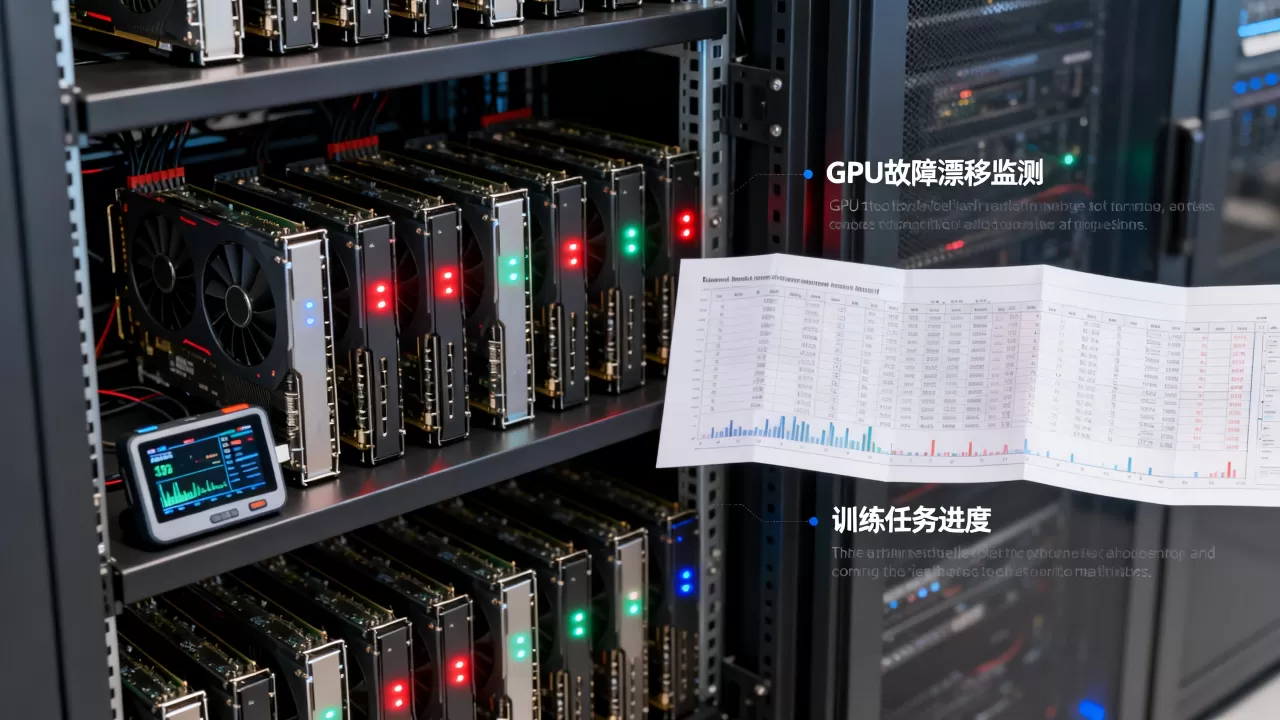
结合近年来的行业观察,故障漂移大致可分为四个阶段:
- 偶发ECC纠错期:显存出现零星单比特错误,被ECC机制静默修正,用户无感知,训练日志中无任何报错。
- 性能衰减期:核心温度升高导致BOOST频率不稳定,同一步迭代耗时增加5%到15%,但波动幅度不大,容易被误认为数据加载问题。
- 间歇性计算错误期:SM单元出现逻辑错误,Loss曲线出现异常尖峰,偶发NaN梯度,但重跑同一batch又能正常通过。
- 彻底失效期:驱动重置、CUDA报错、训练进程被杀死,此时故障才真正“显性化”。
对于动辄运行数周甚至数月的大模型预训练任务,前三个阶段才是真正的成本黑洞,它们不触发检查点回滚机制,但会让每一次迭代的质量都在悄然劣化。
训练中断只是冰山一角:故障漂移如何放大算力损失
业内专家指出,评估故障漂移对长训练任务的伤害,不能只看“中断那一刻”,多卡并行训练的同步机制会把单卡故障的影响扩散到整个集群。
单卡性能衰减引发的“木桶效应”
数据并行训练中,每轮迭代的耗时取决于最慢的那张卡,当某张GPU进入性能衰减期,它的算力输出降低10%,整个集群的有效算力就会同步降低10%,其余七张卡被迫进入闲置等待状态,这种隐性资源浪费比显性宕机更令人头疼监控面板上所有指标都是绿的,但训练总时长却莫名其妙多出数天。
静默数据损坏(SDC)比直接报错更危险
ECC只能修正单比特错误,当故障漂移进入多比特错误阶段时,错误数值会直接参与前向传播和反向传播的计算,训练进程不会死掉,模型却会在不知不觉间“学坏”,这类问题通常要等训练结束后做评测才能发现,而排查成本极高你无法判断是数据问题、超参数问题,还是硬件早已在某个凌晨算错过一次。
下表总结了故障漂移不同阶段对长训练任务的具体影响模式:
| 漂移阶段 | 训练任务表现 | 损失函数特征 | 资源浪费程度 |
|---|---|---|---|
| 偶发ECC纠错期 | 无明显异常 | 正常收敛 | 极低 |
| 性能衰减期 | 迭代耗时波动 | 收敛速度放缓 | 中等 |
| 间歇计算错误期 | 偶发NaN梯度 | 异常尖峰后恢复 | 较高 |
| 彻底失效期 | 进程终止 | 训练中断 | 极高 |
为什么常规监控抓不到“漂移中的GPU”
很多团队直到训练任务失败复盘时,才在日志里发现GPU早就有过异常记录,根本原因在于常规监控体系的设计目标是“捕捉故障”,而不是“捕捉劣化”。
- 温度与功耗阈值过宽:GPU温度80度以内都被判定为健康,但故障漂移期的GPU往往在70度左右就开始出现计算抖动。
- 只看利用率不看稳定性:利用率维持在95%以上不代表计算正确,它只说明GPU没在偷懒,不代表它没在算错。
- 日志级别设置过高:CUDA的ECC警告默认不打印到应用日志,需要手动开启
nvidia-smi -q -d ECC查看,绝大多数训练脚本没有这一步。 - 检查点间隔过疏:每2小时保存一次检查点,如果GPU在保存后10分钟开始漂移,意味着后续110分钟的算力全部建立在错误计算之上。
在实际运维中,部分规模较大的智算中心已经开始引入实时ECC事件监控和SM健康度探针,但这一做法尚未普及到中小型团队。
如何准确评估故障漂移对当前训练任务的影响
评估这件事需要分两条线走:一条是量化当前损失,一条是估算未来风险,前者决定你是否需要止损,后者决定你是否需要更换硬件。
实操:三步定位故障漂移是否已影响训练
以下是可直接执行的排查路径,适用于单机多卡和中小规模集群:
- 查看ECC历史计数:执行
nvidia-smi -q -d ECC
,重点观察
Volatile(易失性)计数,如果多比特错误(Aggregate Multi Bit)数值在训练期间持续上涨,说明显存正在劣化。 - 对比同批次GPU性能基线:记录每张卡训练同一batch(建议固定batch size)的平均耗时,计算标准差,若某张卡的耗时标准差超过其他卡的3倍,基本可以判定进入性能衰减期。
- 开启CUDA警告日志:在训练脚本中加入
export CUDA_LAUNCH_BLOCKING=1(仅用于诊断),配合torch.backends.cudnn.deterministic=True,观察是否有非确定性输出波动,此方法较慢,适合小batch快速验证。
估算损失的两种思路
如果追求精确:对比健康GPU与疑似故障GPU在相同数据子集上的Loss下降曲线,在固定随机种子、固定学习率的前提下,若Loss差值超过0.05且持续扩大,说明故障漂移已实质性干扰训练。
如果追求效率:直接查看训练日志中的NaN梯度出现频率,统计近24小时内NaN出现的次数,若超过3次且每次发生的位置都与同一块GPU相关,建议立即将任务迁移至其他节点,同时对该GPU执行nvidia-smi -q -d PERSISTENCE_MODE检查供电稳定性。
从被动救火到主动排雷:长训练任务的GPU健康管理策略
既然故障漂移不可完全避免,就需要把管理重心前移,在训练任务启动前、训练过程中和任务结束后三个节点设置对应策略。
训练前:建立GPU健康基线档案
- 为新购入或长期闲置的GPU跑一遍压力测试,推荐使用
gpu-burn工具持续满载运行30分钟以上,记录温度曲线和功耗曲线作为基准数据。 - 查询设备保修状态,深度学习训练服务器显卡保修政策因厂商和渠道差异较大部分品牌整机享受三年原厂保修,但散片显卡通常只有一年店保,甚至无保,建议在采购阶段就把“训练场景保修”作为硬性指标,优先选择支持企业级RMA(退货授权)的渠道,对于已过保的GPU,可以额外购买延保服务,单卡成本约在数百元区间,与训练中断造成的算力损失相比依然划算。
- 检查供电链路,尤其是多卡服务器的电源负载分配,供电不稳是诱发故障漂移的重要外部因素。
训练中:把监控粒度从“分钟级”细化到“步级”
- 给
nvidia-smi加一个持续后台记录任务,每30秒写一行关键指标(温度、功耗、利用率、显存错误计数)。 - 开启训练框架的内置容错机制,PyTorch用户可关注
torch.distributed.elastic的agent日志,其中包含对设备健康状态的默认检查项。 - 建议每一到两个训练小时,自动对比当前Loss与历史同期Loss的滑动平均差,设置告警阈值,超过阈值就触发手动介入流程。
训练后:用固定负载复测GPU
训练结束后不要立即安排新任务,先跑一个短时(5到10分钟)的计算一致性测试,例如重复计算某个固定矩阵的卷积结果并对比哈希值,如果结论不一致,说明该GPU已不适合再进入长训练任务队列,应当降级为推理任务或短期微调任务使用,同时向运维提交换卡工单。
关于GPU故障漂移对长训练任务影响的常见疑问
GPU故障漂移与GPU驱动崩溃是一回事吗?
不是,驱动崩溃属于显性故障,发生时CUDA上下文丢失,训练进程直接退出,问题定位简单,故障漂移是隐性劣化过程,GPU仍能执行指令,但计算结果的准确性无法保证,隐蔽性和破坏性反而更大,两者的处理策略也有明显区别:驱动崩溃重装驱动大概率能恢复,故障漂移则需要从硬件层面识别原因,例如显存颗粒老化或供电模块电容衰减。
单卡训练遇到故障漂移,重启进程能否解决问题?
不能,重启进程只是让训练从头开始,GPU本身的硬件状态并没有任何改变,故障漂移是累积性的物理退化过程如果ECC错误计数已经持续增长,说明显存颗粒的可靠性已不可逆地下降,此时继续使用同一块GPU重新训练,大概率在相同甚至更短的时间内再次触发问题,正确做法是先换卡完成训练,再对旧卡做诊断,判断是否有维修价值。
如何判断一块出现故障漂移的GPU是报废还是可修复?
在大多数情况下,不建议个人或中小企业自行维修GPU,显卡的显存颗粒和核心芯片采用BGA封装,需要专业回流焊设备才能更换,务实做法是先用MATS(NVIDIA官方显存测试工具)或mods(开源显存扫描工具)确定具体损坏的显存颗粒位置,若损坏颗粒不超过两个,可以联系专业维修机构更换,费用通常在百元级,若核心SM单元出现逻辑错误,建议直接报废处理,因为核心损坏的维修成本已接近显卡残值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/624978.html