推理网关屏蔽GPU异构差异的核心思路,是把“模型服务”和“底层硬件”彻底解耦上层只认统一的推理接口,下层用网关做路由、适配和动态分配。
这种架构在2026年的大模型落地场景里几乎成了标配,原因很简单,没有哪个团队愿意被某一家GPU厂商绑定,但真把A卡、H卡、国产卡混在一个集群里用的时候,问题远比想象的多,推理网关就是那个在中间“收拾烂摊子”的角色。

GPU异构差异到底卡在哪:推理网关需要先承认差异
很多人对异构的第一反应是“算力不一样”,算力差异反而是最容易被处理的部分,真正棘手的是下面这些维度,它们直接决定了网关的设计逻辑。
驱动和底层库的兼容性裂缝
同一个模型,在N卡上用CUDA跑得好好的,换到国产加速卡上,可能连算子都编译不过去,这不是模型代码的问题,而是底层软件栈割裂,推理网关必须能识别后端类型,把请求分发到对应能力的节点上。今年行业共识是,网关不一定要统一底层,但必须统一上层的对接方式,也就是说,模型服务内部随便怎么折腾,对外暴露的接口必须是一致的。
显存规格与模型切分的错配
有的卡显存大但带宽低,有的卡显存小但算力猛,当模型需要张量并行或多卡切分时,网关要清楚每个后端能塞下多大的模型,如果网关不做这层感知,调度器可能把一个70B模型分配到一个显存只有32G的节点上,直接OOM。
推理引擎的多样性
同一个GPU上,可以跑vLLM、Triton、TensorRT-LLM,也可以跑国产框架,不同引擎的吞吐和延迟特性差异极大,推理网关的作用不是消灭引擎多样性,而是把引擎差异封装在路由规则里,比如优先走vLLM,或者按请求延迟要求分流。
推理网关如何屏蔽后端GPU异构差异:核心机制拆解
网关要做的事情,概括起来四件:接口统一、路由感知、自适应批处理、可观测性,每一件都有具体的落地路径。
统一推理接口与协议转换
这是最基础的一层,也是用户感知最强的一层,网关对外暴露OpenAI兼容的/v1/chat/completions接口,内部再转换成各个推理引擎的native格式,比如后端的vLLM和Triton原生接口不同,但网关层统一处理掉这种差异。
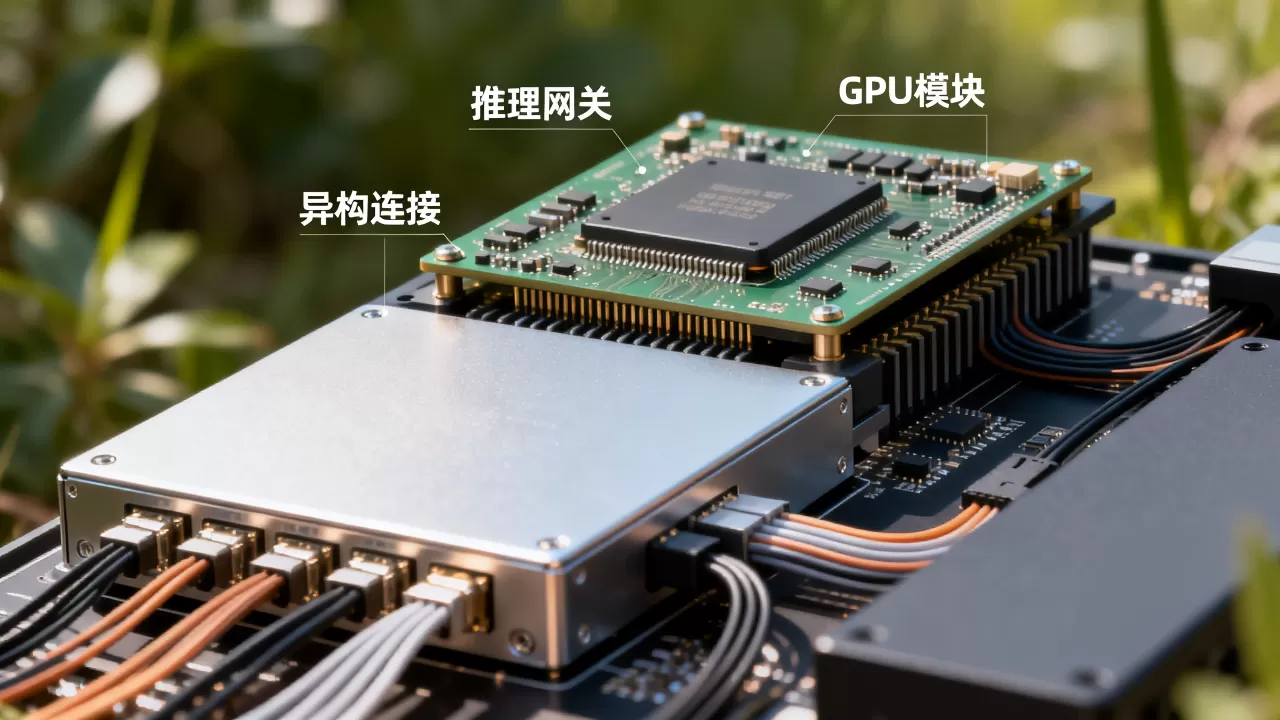
具体操作上,网关会做三件事:
- 解析上游请求的JSON Schema,提取model、prompt、sampling参数。
- 将标准化参数映射为后端引擎能识别的格式,比如把temperature映射为Triton的override参数。
- 将后端返回的token级流式响应,统一转为SSE(Server-Sent Events)格式回传给客户端。
这样前端开发不需要关心GPU型号和推理框架,只看一个API地址就行。
路由策略:不只是负载均衡
异构场景下,路由不能只看健康检查,同样一个模型部署在两批机器上,一批用A800,一批用国产卡,网关需要根据请求特征做精细化分发。
关键在于多维度的路由判定:
- 按延迟SLA路由,高优先级请求走高性能卡,普通请求走性价比卡。
- 按上下文长度路由,短请求走显存较小的节点,长序列走显存充裕的节点。
- 按并发压力路由,统计每个后端当前活跃请求数和queue占用,动态调整权重。
实操中,一套有效的模型调度策略模板再搭配动态权重更新,就能在不大改后端代码的前提下,把两个异构节点的吞吐利用率都拉高,网关内部维护一张节点表,每隔几秒刷新一次健康度和负载状态,RPS、TPOT、TTFT这些指标会被送进一个加权评分函数,分数高的节点获得更多流量。
自适应批处理与显存动态分配
这一条对推理网关而言是真正的技术难点,GPU推理优化的一个关键手段是连续批处理,也就是动态batching,但异构环境下,不同GPU的batch上限差异巨大。
网关需要具备以下能力:
- 持续监控每个GPU的显存余量,按百分比而不是固定值来做阈值判断。
- 根据后端反馈的prefill和decode阶段耗时,动态调整发给每个节点的batch size。
- 当某个节点出现显存压力时,网关自动降低该节点的并发配额,把流量引导到其他空闲节点。
这一层做好,异构集群的利用率差距能被拉回到很小,不过国内不少团队在落地时依然沿用固定batch值的写法,导致异构节点一混部就出现性能回退,要解决,得从静态配置思维转变到动态感知思维。
两段式服务化:流量入口与弹性伸缩分离
在推理网关的设计中,有一个容易被忽视的结构化技巧:把流量入口网关(North-South)和节点调度网关(East-West)分开,前者负责鉴权、限流、API Key管理,后者负责任务调度,这样,即便底层GPU池子频繁扩缩容、重启,对上层调用方完全透明。
实操步骤大致如下:
- 在流量入口层配置统一的API Key和配额策略。
- 在节点调度层接入Kubernetes,通过自定义CRD描述GPU类型和数量。
- 让调度层依据资源监控指标(如GPU利用率和显存碎片率)来自动伸缩后端Pod。
- 训练好一套模型后,打包成镜像,下发到不同架构的GPU节点,网关通过协议头中携带的硬件版本号,让不同节点上的服务实例注册到不同分组,来让模型推理永远选择匹配的后端。
模型推理API是什么,为什么网关是它的“交通警察”
很多刚接触大模型工程的开发者会混淆概念:模型推理API是什么?简单说,它就是客户端调用模型能力的那一组HTTP或gRPC接口,而推理网关,就是站在这些API背后的流量管理组件。
没有网关,客户端就得直连GPU节点,带来的问题远不止“不方便”,GPU节点IP一变,客户端就得跟着改配置;后端扩容了新卡,客户端完全感知不到;甚至GPU节点发生慢请求雪崩时,调用方会毫无预警地超时,有了网关这一层,这些东西全被屏蔽掉,调用方面对的始终是同一个稳定域名。
从行业实践看,网关在API之上的价值有两种体现:一是提供多租户隔离,二是实现按量和优先级计费,而这两种能力的实现,恰好都是建立在“网关知道所有后端GPU存在”这个前提上的,这也是为什么越来越多的开源项目开始把网关内置进推理框架,而不是让用户自己拼接组件。
推理网关如何屏蔽后端GPU异构差异的Q&A环节
推理网关部署在哪里性能损耗最小?
建议放在和GPU节点同一个VPC或K8s集群内,两者之间走内网通信,网关的延迟开销通常在毫秒甚至亚毫秒级,相比一次推理动辄几百毫秒到几秒,这个损耗几乎可以忽略,避免跨地域调用,那是网关性能下降的大坑。
一套推理网关能同时管理N卡和国产加速卡吗?
可以,但前提是两边的推理后端都必须支持通过HTTP/gRPC方式提供服务,网关本身不直接操作GPU,它只和数据平面打交道,只要国产加速卡能够正常运行一个OpenAI兼容的服务镜像,网关就能纳入管理,差异点在于显存调用接口和性能基线不同,需要在分组时进行手工标记。
网关调度策略如何适配不同GPU的算力等级?
用一个加权模型即可,把每张卡的算力、显存、带宽打成分数,网关在算总分时乘以这个权重,N卡的FP16算力通常设定为一个基准值,其他卡按实测跑分折算,多跑几个常见模型做benchmark,然后让网关把这些反馈数据记录到节点档案里,再根据实际指标持续调整。这不只是技术取舍,也是成本问题GPU推理成本测算单里的每一项,最后都落在这些调度决策上。
写在最后:网关不是银弹,但它是异构落地的必选项
如果后端GPU都是同一型号、同一驱动,那确实不需要推理网关,负载均衡就够用,但现实是,大多数团队都处于一个混部状态:一批存量N卡,一批新买的国产卡,还有可能穿插着几台T4在跑轻量模型,这种情况下,推理网关的屏蔽能力就不再是可选项,而是工程刚需。
拥抱异构,意味着拥抱配置上的脏活、性能上的不确定性、以及排障时的复杂度。推理网关的价值,就是把这些脏活挡在业务代码之外,让团队可以把精力放在更上层的模型效果和应用功能上,这条路没有捷径,但方向是对的。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/625475.html