私有云资源利用率为何总在低位徘徊
私有云资源利用率低往往源于粗粒度的分配,把整台服务器、整颗CPU当作最小分配单位,资源注定被白白浪费。这个结论不是推测,而是运维一线摸爬滚打后的共识。
粗粒度分配的三大坑
一次性分配整台物理机的“土豪”做法
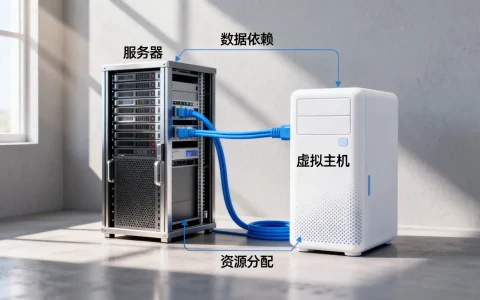
很多企业建私有云时,习惯用原先物理机的思路来规划,某个业务部门申请资源,直接划分两路CPU、三十二GB内存、四TB存储,看起来豪爽,实际利用率惨不忍睹,业务峰值可能只有两天,其余时间计算资源在睡觉,但别人没办法用,因为这台机器名义上已经“属于”张三部门了。粗粒度分配的本质,是用物理分割代替了逻辑共享。

规格僵化导致“大马拉小车”
以OpenStack或VMware为主的私有云环境,管理员创建虚拟机时,往往从预设模板里选规格,这些模板是谁定的?多半是采购服务器时厂商给的默认配置,默认配置讲究“够用有余”,一个跑内部Wiki的虚机,分到八核十六G,日常负载只有百分之五,想调小?流程审批走两周,改来改去没人愿意碰,结果就是集群里到处是“虚胖”的虚拟机,真实负载低得可怜。
资源释放流程形同虚设
项目结束后,研发环境不回收、测试机器不销毁、临时扩容的节点长年挂着这是资源利用率低的头号杀手,据统计,在较为规范的IDC机房里,僵尸资源占比依然相当可观,更麻烦的是,有些管理员不敢回收,怕万一哪天业务又要用,这种“留着保险”的心态,让资源池里堆满了无人认领的“遗产”。
细粒度分配到底该怎么做
第一步:做一次彻底的资源审计
别急着优化,先搞清楚现状,打开你的虚拟化管理平台,按CPU平均利用率、内存占用率、磁盘IO三个维度,给所有虚机排个序,找出那些运行超过九十天、CPU平均使用率低于百分之五的虚机,列成清单,跟业务方逐台确认,能合并的合并,能销毁的销毁,这一步通常能释放出三成以上的闲置资源。
第二步:引入配额管理,从源头控制
给每个项目组设置资源配额,不是限制,而是让分配变得可量化。配额的概念必须细化到虚拟CPU核数、内存GB、存储容量三个维度,而不是简单说“给你四台物理机”。配额的粒度决定了你能回收的最小颗粒度,用Quota系统或者云管平台的配额模块,让业务方自己申请、自己管理、自己负责,超了要申请扩展,不用的要主动释放。
第三步:开启超分,把闲置资源用起来
超分是KVM虚拟化的基本能力,把一台物理机的CPU超分成两倍甚至三倍给虚机用,前提是你要清楚业务负载特性。如果是跑批处理、离线计算这类CPU密集型业务,超分比率控制在1.5倍以内;如果是内部办公系统、开发测试环境,超分到2.5倍都问题不大。内存超分要谨慎,因为内存不像CPU可以排队,超了直接OOM Killer,建议内存超分只给开发环境用,生产环境保持1比1。
容器化改造是最终的解题思路
容器让“按需分配”变成现实
虚拟机再怎么优化,thick disk和thin disk的差距始终摆在那里,启动要几十秒,扩容要重启,容器没有这些烦恼,一个Pod的CPU请求写成100毫核,内核就精准分配100毫核的计算资源,不用管底层物理机还有几个核。容器和Kubernetes的出现,让私有云从“卖整鸡”变成了“卖鸡胸肉、鸡腿、鸡翅分开卖”,你要多少,我就切多少。行业共识认为,完成容器化改造的企业,资源利用率普遍能翻一倍以上。
动态伸缩才是真正的细粒度
Kubernetes的Horizontal Pod Autoscaler可以根据CPU使用率自动扩缩Pod副本数,低峰期两个副本,高峰期二十个副本,整个过程无人干预,这解决了一个根本问题:不再需要为峰值预留资源。
峰值不是常态,为常态分配资源才是理性的选择。配合Cluster Autoscaler,节点级资源也能动态伸缩,业务高峰期自动加机器,低谷期自动回收,彻底告别“买一堆机器等着过年”的粗放模式。
私有云成本怎么算才算精细
提到私有云,绕不开成本问题,粗粒度分配下,你看到的成本是物理机的采购价加电费,看似不高,实际浪费的钱都藏在看不见的地方。精细核算成本,要把每一颗虚拟CPU、每一GB内存都当作可计费资产。有些企业上私有云,花了上百万买设备,最后跑的业务只用了二十万的价值,剩下的全在吃灰,换个角度来看,私有云和公有云哪个更省钱本身就是伪命题用得好,私有云便宜;用不好,私有云比公有云贵得多。
从技术到管理,落地路径要清晰
- 建立资源利用率日报机制,每天上午十点自动推送前一天的CPU内存均值报表。
- 设置闲置资源自动回收策略,连续三十天负载低于百分之五的虚机,自动进入待回收池。
- 改造虚机规格标准,从原来固定的四档改为八档细粒度,每一档差异控制在两倍以内。
- 培训业务团队,让项目负责人学会看报表,理解“资源是要花钱的,浪费是可耻的”。
- 逐步推进容器化,先选一两个无状态业务试点,跑通之后再横向复制。
一个典型的优化案例
某中型企业的私有云集群有四十台物理机,底层是OpenStack,跑的虚机超过三百台,刚接手时,运维团队也说不清资源到底够不够,只觉得总在报警,后来做了资源审计,发现两百多台虚机CPU平均利用率不到百分之三,大部分是两年前项目留下的一台老应用,逐台确认后,停掉了一百五十台虚机,释放出一百二十核CPU和四百GB内存,随后把剩余业务全部做了规格瘦身,从八核降到了四核,高峰期也没受影响,再后来,核心业务迁到Kubernetes,用HPA自动伸缩,
资源利用率从百分之五提升到百分之四十,整体只花了一个季度的时间。
私有云资源利用率低怎么优化才是最优解
回到开头那句话,粗粒度分配是根因,那细粒度就是药方,这个药方不复杂,但需要耐心:先审计,再配额,然后超分,接着容器化,最后用数据驱动管理,每一步不需要都做,但要做到行业平均水平,至少得完成前三步。
具体的操作路径应该这样走:先拿到真实负载数据,再制定粒度规范,然后引入自动化能力,最终形成以容器为单位的资源调度体系,整个链条走下来,你的私有云资源利用率就不会再是个尴尬的数字了。
常见问题解答
容器化改造难度大不大,小团队能不能做?
难度主要不在技术,而在业务适配,成熟的开源方案很多,Rancher、KubeSphere都有完整的界面化操作,普通运维人员学习两周就能上手,如果担心改造周期太长,可以先从新建的业务开始容器化,存量业务慢慢迁移。
超分会带来性能下降的风险吗?
多数情况下不会有明显影响,前提是做好监控告警,当物理机CPU超过八成时,系统会根据权重调度,个别虚机可能出现性能抖动,解决的办法是给关键业务设置CPU优先级,或者使用CPU QoS特性做隔离,虚拟内核的数倍超配在内部网络中运行完全可接受,同城多活的业务架构本身也对性能不敏感。
私有云还能怎么和公有云配合使用?
将私有云的存储、数据库服务保留在本地的同时,将海量计算类业务转发至公有云,利用其弹性资源应对突发流量,是混合云最经典的形态,通过各类容器方案和网络隧道,数据连通也不存在什么瓶颈,核心是保留私有云安全合规的优势,同时享受公有云的规模效应。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/627520.html