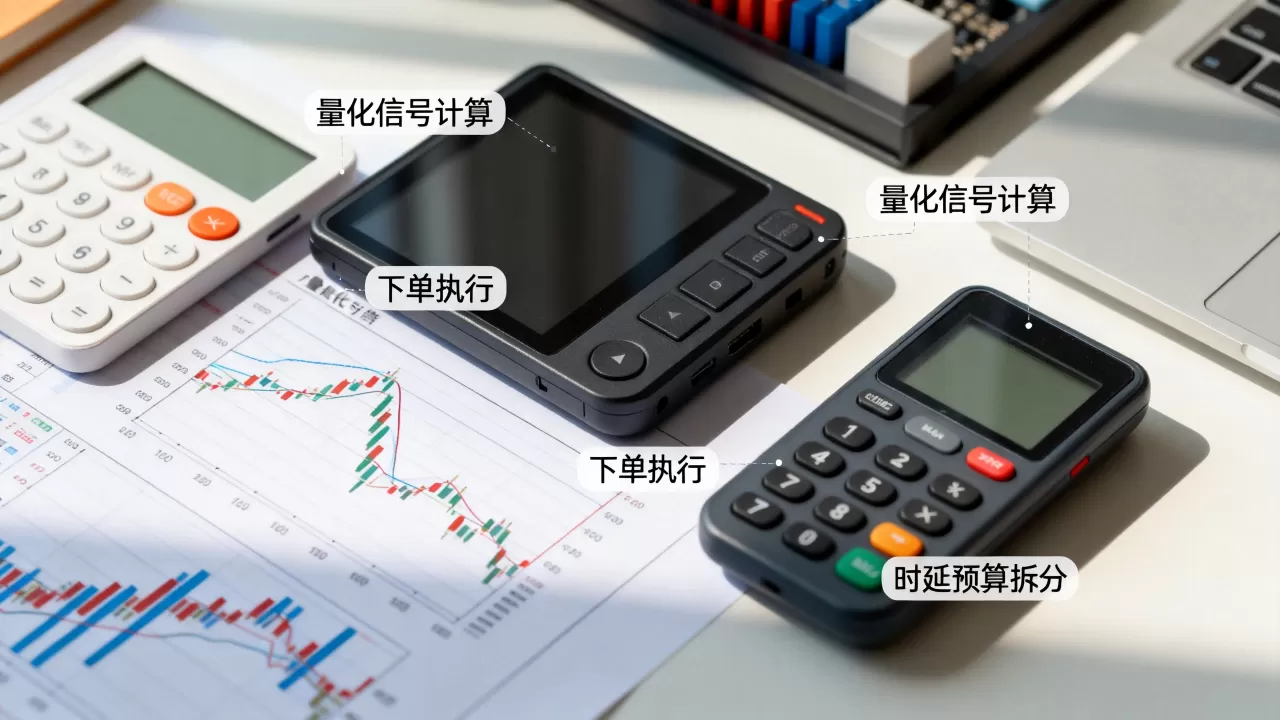
量化交易中,从行情数据到达至订单送达交易所的端到端时延预算,应严格控制在50毫秒以内,其中信号计算与下单执行的时延分配比例约为4:6,具体切割需依据策略类型与硬件环境动态调整。
时延预算的总体框架:先分蛋糕再谈优化
量化交易的本质是时间套利,每一微秒的延迟都可能意味着成交价的滑点,业内专家指出,一个完整的交易链路通常包含行情接收、信号计算、风控校验、订单生成、网络传输五个核心环节,在开始优化之前,需要先明确总体预算池的大小,再进行合理切割,行业共识认为,普通中频策略的端到端预算在100-200毫秒之间,而高频策略则需压降至10毫秒以内,以最常见的50毫秒总预算为例,建议执行以下分配原则:
- 行情解析与分发:5-10毫秒,占比20%以内,主要消耗在数据解码和组播转发
- 信号计算与策略逻辑:15-20毫秒,占比30%-40%,需预留足够的CPU计算余量
- 风控校验与仓位管理:5-8毫秒,占比10%-15%,主要受数据库访问和内存状态检查影响
- 订单封装与发送:10-15毫秒,占比20%-30%,包含TCP/NATS序列化及网卡传输
- 交易所撮合与回报接收:5-10毫秒,占比10%-20%,属于外部不可控因素
为什么信号计算不能压缩到极致
许多团队在优化时犯的最大错误是试图将信号计算压至极限,却忽视了策略容错空间,信号计算的时延预算需涵盖三部分:数据预处理(如K线合成、指标计算)、模式识别(如均线交叉、布林带突破)、仓位决策(如资金管理、止损触发),以双均线策略为例,单次信号计算通常仅需5毫秒,但若策略涉及多周期共振或机器学习推理,则需预留20毫秒以上,压得过紧会导致两个后果:一是行情剧烈波动时CPU满载引发计算超时,二是信号精度下降产生无效交易,建议在预算分配时为信号计算额外加设20%的缓冲余量,避免极端行情下的链路雪崩。
信号计算环节的成本清单
信号计算并非单纯消耗CPU,其延迟来源分布在多个层面,理解这些细节,才能做出精准的预算分配决策。
数据预处理阶段的隐藏耗时
行情解码是最易被低估的环节,二进制行情协议解析、时间戳对齐、数据缓存更新这三步看似简单,但在每秒处理万笔行情时,耗时会被显著放大,若使用Python进行数据处理,行情解码耗时通常在2-3毫秒;改用C++后,同一环节可压缩至
5毫秒以内,内存分配和垃圾回收机制在Python中会带来不可预测的延迟尖峰,多数情况下,这也是将核心信号计算迁移至C++或Rust的首要动因。
策略逻辑执行的时间陷阱
策略逻辑的耗时取决于三方面:指标计算复杂度、数据读取频率、对象创建方式,以布林带策略为例,计算20周期移动平均与标准差时,若每次Tick全量重算,耗时约1毫秒;若采用增量更新算法,耗时可降至2毫秒,另一个常见陷阱是过度使用面向对象设计,每次信号计算都创建新对象,导致堆内存频繁分配,更合理的做法是预分配复用对象,将耗时稳定在微秒级。
信号输出的序列化瓶颈
信号计算完成到订单生成的过渡环节常被忽视,但隐含延迟不容小觑,策略线程需将信号结果(如买/卖标记、目标价格、手数)写入共享内存或消息队列,再通知交易执行线程,若使用进程间通信(IPC)方式,序列化与反序列化耗时约0.5-1毫秒;若通过共享内存直接传递结构体指针,则可压缩至1毫秒以下,据量化社区实践统计,有相当一部分团队在此环节因不合理的JSON序列化浪费了2-3毫秒。
下单执行链路的延迟切割与并行优化
订单执行链路的时延优化空间远大于信号计算,因为这一部分涉及网络I/O和操作系统内核交互,且存在并行化改造的可能性。
从信号到订单的直通模式
传统做法中,信号计算线程与交易发送线程分离,中间经过消息队列传递这一进一出至少消耗2毫秒,直通模式则将信号计算与订单封装置于同一线程内完成,通过原子操作直接更新发送缓冲区,行情的实测数据表明,直通模式可将信号到订单封装的时延从3-4毫秒压缩至0.8毫秒,前提是策略逻辑本身足够精简,且不会阻塞行情接收回调,需要根据自身策略频率权衡:高频策略信号简单,适合直通模式;复杂策略信号计算耗时较长,强行合并会阻塞行情接收,反而增加整体时延。
风控校验的旁路设计
风控校验是交易链路中最头疼的环节,因为其必须串行执行,但耗时却很高,常见做法是使用Redis存储账户持仓和委托状态,一次查询耗时约1-2毫秒,优化方案是将风控数据镜像到本地共享内存,由交易进程直接读取,耗时骤降至
50微秒以内,将风控逻辑拆分为事前检查(如可用资金校验、涨跌停板检查)与事后监控(如持仓超限报警),前者嵌入下单链路串行执行,后者旁路异步处理,可额外节省2-3毫秒。
网络传输与交易所连接的物理极限
网络时延在总预算中占比较小但绝对值固定,在同一机房部署的策略服务器至交易所柜台,内网往返延迟约5-1毫秒;若跨机房部署,则需增加2-5毫秒,订单经TCP协议发送至交易所网关后,交易所内部的撮合排队时间在正常情况下维持在1-3毫秒,但在极端行情下可能膨胀至几十毫秒,这部分不可控时延需在预算中预留缓冲,想要计算端到端延迟的精确值,最简单的验证方式是使用tc命令模拟网络延迟,测试策略在100ms延迟下的表现,再逐步缩减至目标值。
时延预算的实测方法与调优路径
理论拆分完成后,需要通过实测确认各环节耗时占比,并据此迭代调优,以下是可重复执行的验证路径:
打点监控与火焰图分析
在代码关键路径插入耗时打点(使用clock_gettime或std::chrono),分别记录以下数据:行情回调进入时间、信号计算完成时间、风控校验完成时间、订单发送完成时间、交易所回报接收时间,将采集数据汇总至Grafana或自研监控面板,按P50/P95/P99分位观察时延分布,若发现P99远高于P50(如信号计算P50为5毫秒,P99为20毫秒),则需排查GC暂停、锁竞争或CPU调度问题。
常见瓶颈与对应解法
- CPU调度抖动:为交易线程绑定独立CPU核心(
taskset -c 3 ./trading),隔离中断干扰 - 锁竞争:将信号计算中的共享状态改为无锁数据结构(如
moodycamel::ConcurrentQueue) - 内存分配:改用预分配对象池,关闭调试日志,避免
printf等系统调用阻塞 - 网卡中断:启用RSS(Receive Side Scaling)和Busy Polling,降低网络包处理延迟
- 内核参数调优

:调整
net.core.rmem_max、net.core.netdev_budget,增大套接字缓冲区
回测与实盘的延迟差异校准
回测系统通常无法模拟网络延迟与交易所排队,导致实盘表现与回测差异显著,执行前需按以下步骤校准:第一,在回测引擎中启用撮合延迟模拟模块,将订单撮合时间设置为固定3毫秒;第二,记录信号产生到下单动作完成的时间戳差,对比回测数据,确认偏差在5毫秒以内;第三,使用市价单与限价单分别测试,捕捉不同订单类型在交易所侧的处理时间差异。
高频场景下的极限压缩实践
针对高频策略,时延预算的分配逻辑需要彻底重构,信号计算不再是主要矛盾,网络传输与系统调用优化成为核心突破点,具体目标可设定为:行情解析到下单完成总耗时不超过5毫秒,其中信号计算裁剪至1毫秒以内,下单执行压缩至2毫秒以内,风控校验与网络传输占剩余2毫秒,实现方式包括:采用FPGA硬件加速行情解析、使用Solarflare或Onload内核旁路技术、将交易进程运行于DPDK环境,这类极致优化虽然成本较高,不适合多数量化团队,但其方法论可借鉴至中频策略的局部优化中。
Q&A:量化信号计算时延与下单执行时延的常见疑问
Q1:信号计算耗时和下单执行耗时怎样才算合理比例?
A1:未做极致优化前,信号计算占40%,下单执行占60% 是平衡状态,若信号计算占比超过60%,说明策略逻辑过于复杂或数据读取低效;若下单执行占比超过80%,则应优先排查网络延迟、序列化方式及系统调用开销。
Q2:云服务器比物理机部署的时延差距有多大?
A2:在相同地域的云服务器与物理机环境下,网络时延差距不大,但云服务器的CPU调度抖动和虚拟化层开销在极端行情下会造成明显延迟尖峰,P99差异可达5-15毫秒,属于竞价型高频策略无法接受的范围。
Q3:时延预算拆分后,哪一部分最容易在优化中被忽略?
A3:在多数情况下,交易所撮合排队延迟和本地回报处理时间最易遗忘,前者不可控但需留预算余量,后者常因订单回报回调里的日志记录和状态更新繁重而暗藏2-3毫秒额外耗时,应使用异步日志替代同步日志。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/632235.html