请求重试和故障转移是应对瞬时系统故障的两种核心手段,前者解决“偶发抖动”问题,后者应对“节点失效”场景,二者结合可以显著降低网络波动或服务闪断带来的业务影响。在一次完整的请求链路中,瞬时失败往往表现为连接超时、连接池耗尽或单节点返回5xx错误,这类问题并不代表服务永久不可用,合理的重试策略能挽回大部分请求;而故障转移则是在重试也无法解决时,将流量切换到健康节点的兜底方案,下面从实际场景出发,拆解这两套机制如何配合,以及落地时容易踩的坑。
故障转移和重试机制的分工逻辑
很多开发者会把重试和故障转移混为一谈,实际上它们解决的维度完全不同,重试是在同一个节点上再次发起请求,前提是相信这个节点只是临时状态不佳;故障转移则是在不同节点之间切换,前提是认为当前节点已经不可靠。

重试适合处理哪些瞬时抖动
瞬时抖动最常见的来源有网络丢包、TCP连接超时、GC暂停导致的接口变慢,以及数据库连接池短暂打满,这类问题有个共同特点:持续几秒到几十秒,之后自行恢复,比如数据库连接池被慢查询占满,前端的请求会排队超时,但慢查询结束后连接池会逐渐释放,此时发起重试大概率能成功。
实操中,重试需要关注三个参数:
- 重试次数:通常控制在1到2次,超过3次反而会加剧服务压力
- 超时时间:总超时时间=首次超时时间+重试间隔×重试次数,不能无限叠加
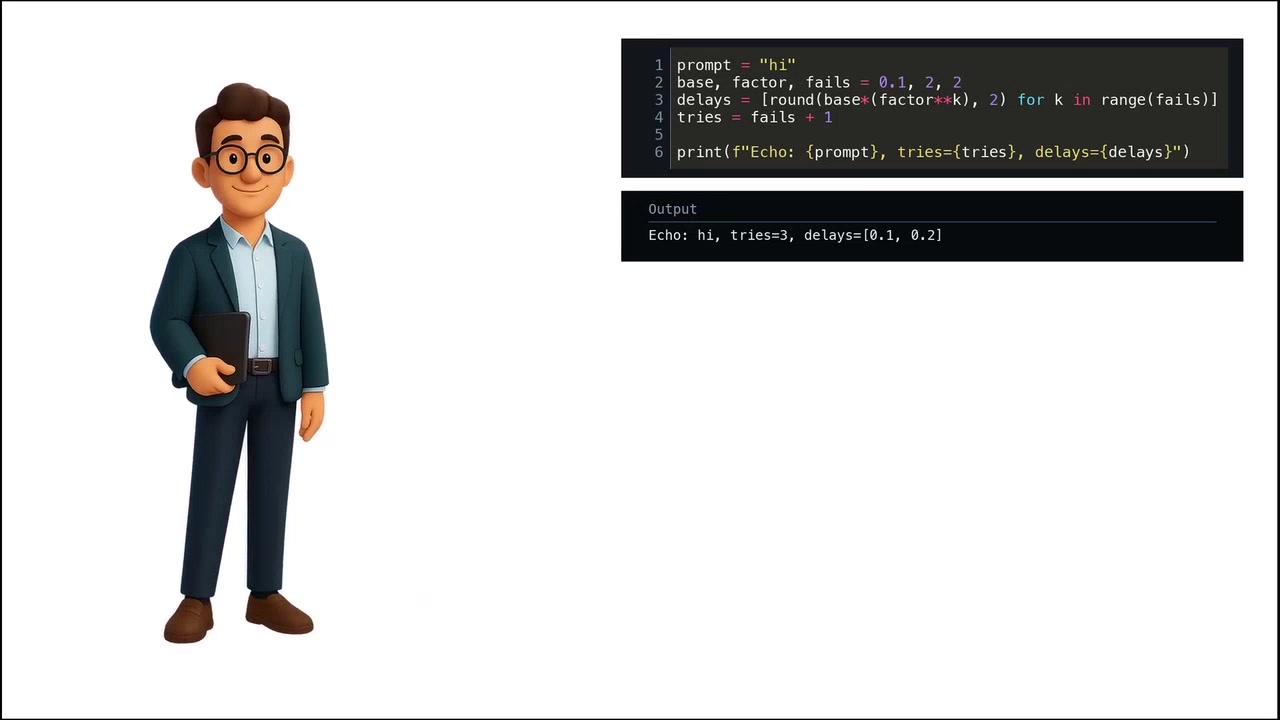
- 退避策略:不要固定间隔重试,使用指数退避(比如1秒、2秒、4秒)能有效避免重试风暴
另一个关键点是重试必须在超时或明确的连接错误时触发,而不是收到业务错误码(比如参数校验失败、权限不足)也盲目重试,那样不仅浪费资源,还会放大问题。
故障转移负责兜底哪些硬故障
故障转移处理的是节点级失效,比如进程崩溃、服务器断电、网络分区、健康检查连续多次失败等,这种情况下,反复重试同一节点没有意义,必须把请求发给其他健康实例。
以微服务架构为例,服务注册中心(如Nacos、Consul)会维护实例列表,消费者通过负载均衡策略挑选节点,当某个实例的故障转移被触发时,负载均衡器会将其从候选列表剔除,后续请求全部转发到剩余实例。
健康检查的频率和阈值决定了故障转移的响应速度,一般建议每5秒检查一次,连续3次失败即标记为不可用。
需要留意的是,故障转移本身也有代价,如果所有节点都出现同类问题(比如数据库挂了),故障转移并不能解决问题,反而会放大集群压力,所以通常要搭配熔断器(如Sentinel、Hystrix)一起使用,服务熔断降级和故障转移的侧重点不同,前者是主动拒绝流量防止雪崩,后者是流量切换,两者配合才能形成完整的高可用策略。
重试和故障转移一起用有哪些坑
很多系统同时配置了重试和故障转移,但效果不佳,甚至引发连锁故障,问题往往出在两者叠加后产生的不协调行为上。
幂等性缺失导致重复操作
这是最常见的问题,一个支付接口,第一次请求超时了,发起重试,如果接口没有做幂等处理,用户会被扣两笔钱,接口超时重试怎么设置才安全?必须保证接口在超时或故障场景下具备幂等性,通常通过携带业务唯一ID(如订单号、流水号),服务端记录处理状态来去重,故障转移同理,请求被转发到另一个节点时,该节点也要能识别这是同一个业务请求。
重试风暴与超时叠加
假设网关设置了超时3秒,下游服务高峰期耗时2秒,重试一次后总耗时4秒,此时网关已经超时,但下游还在处理,造成了资源浪费,更严重的是,当瞬时故障发生时,所有请求同时发起重试,在退避策略缺失的情况下,下游服务收到的请求量成倍增长,会从“偶发抖动”演变成“雪崩”。
行业共识认为,重试应该遵循“快速失败”原则:优先缩短首次超时时间,再配合有限的几次重试,网关层重试次数建议为0,服务间调用重试建议为1,且必须设置全局超时上限(比如3秒)。
故障转移与重试同时触发的混乱局面
有些系统在负载均衡层配置了重试,又在服务消费方配置了故障转移,导致同一请求被复制多份发给多个节点,这时候需要明确边界:重试尽量放在调用发起方,故障转移放在负载均衡层,调用方负责处理单节点的瞬时抖动,负载均衡层负责剔除失效节点,各管一段,不要重复设置。
如何判断应该重试还是切换节点
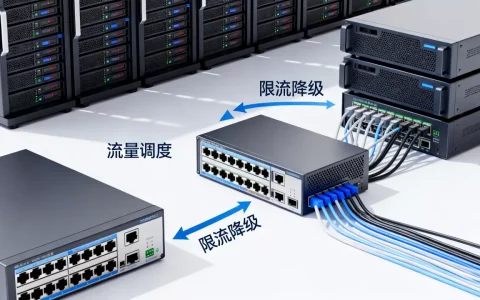
这是架构选型中的高频问题,请求重试和故障转移的区别可以总结为:如果错误类型是连接超时、读取超时、5xx临时错误,优先考虑重试;如果错误类型是连接拒绝、DNS解析失败、健康检查失败,直接走故障转移。
用错误码和异常类型做判断依据
在实际代码中,可以通过异常类型来做分支:
- IOException、SocketTimeoutException:网络层面抖动,重试价值高
- ConnectionRefusedException:端口无监听,说明进程可能挂了,不应该重试
- HTTP 503:网关或服务端过载,这种情况下重试需要谨慎,建议结合熔断器
- HTTP 404/400:业务错误,直接返回,不重试
区分接口类型决定重试策略
不是所有接口都适合重试。查询接口(GET请求)天然适合重试,因为重复查询没有副作用;写接口(POST/PUT/DELETE)需要特别小心,必须结合幂等设计,对于非核心链路(如日志上报、异步通知),重试次数可以放宽,因为这些场景数据最终一致性要求不高;对于核心链路(如支付、订单创建),要做到“不重试比错误重试更安全”。
生产环境的参数配置参考
超时与重试组合建议
| 场景 | 连接超时 | 读取超时 | 重试次数 | 退避策略 | 故障转移 |
|---|---|---|---|---|---|
| 内部API同步调用 | 500ms | 1500ms | 1次 | 固定500ms | 开启 |
| 数据库访问 | 1s | 3s | 0次 | 无 | 主从切换 |
| 支付回调通知 | 3s | 5s | 3次 | 1s/5s/30s | 手动触发 |
| 日志异步上报 | 1s | 2s | 2次 | 2s/10s | 不开启 |
故障转移的触发配置
- 健康检查间隔:5秒/次
- 失败阈值:连续3次即标记不可用
- 成功恢复阈值:连续2次成功即重新标记可用
- 半开状态:允许少量请求探测,验证节点是否恢复
数据库层面的故障转移通常依赖中间件实现,比如MySQL主从切换、Redis哨兵模式,配置上需要重点设置切换超时时间(一般在10到30秒之间),超时太短会频繁切换,超时太长会导致服务长时间不可用。
故障转移提高服务可用性的实践清单
- 核心服务必须冗余部署

,至少两个节点分布在不同的物理机或可用区
- 负载均衡层启用健康检查,并且检查的路径要有实际业务逻辑,不能只检查TCP端口
- 故障转移触发后要有告警,通知运维人员介入排障,否则节点静默消失会造成容量下降
- 定期做故障演练,比如通过Kill一个Pod来验证流量切换是否正常,避免配置在真实故障时失效
- 全链路超时控制,从网关到服务到数据库,每一层的超时时间要逐层递减,避免请求在深层堆积
关于地域场景,国内企业的多机房部署通常涉及跨地域容灾,异地多活的故障转移策略比单机房更复杂,需要考虑数据同步延迟,建议优先在同城双活层面做故障转移,跨城容灾作为第三级保障。
常见问题解答
请求重试与故障转移哪个先触发?
通常先重试,后故障转移,调用方在同一节点上的单次请求超时后,先发起一次或者两次重试,仍然失败说明该节点状态可疑,此时将请求标记为失败并触发负载均衡层的节点剔除,后续新请求才会切换到其他健康节点,如果健康检查已经提前标记节点不可用,那么新请求会直接走故障转移路径,不会发起无效重试。
重试与幂等键如何配合使用?
幂等键是传入请求头中的业务唯一标识,服务端以该键作为缓存存储请求状态,重试时携带相同的幂等键,服务端识别到已有同名请求在处理,就会直接返回结果而不重复执行业务逻辑,这样可以保证重试和故障转移过程中不产生重复订单或重复扣款。
如何防止重试拖垮下游服务?
通过限制重试比例来保护下游,设置最大重试并发数,超出部分直接快速失败,流量较大时启用“自动退避”,当服务端持续返回5xx时自动降低重试频率,等待服务恢复后再逐步放开,网关层的超时时间和重试次数应该比应用层更保守,避免层层叠加放大流量。
重试和故障转移不是越激进越好,而是要在快速恢复和保护系统之间找到平衡点,瞬时失败处理方案的落地核心在于参数调优和日常演练,把配置固化到代码和运维流程中,才能在真实故障来临时从容应对,把重试次数、超时时间、健康检查阈值都写清楚,坚持每个季度做一次故障注入测试,你的系统就能扛住大多数瞬时故障场景。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/635116.html