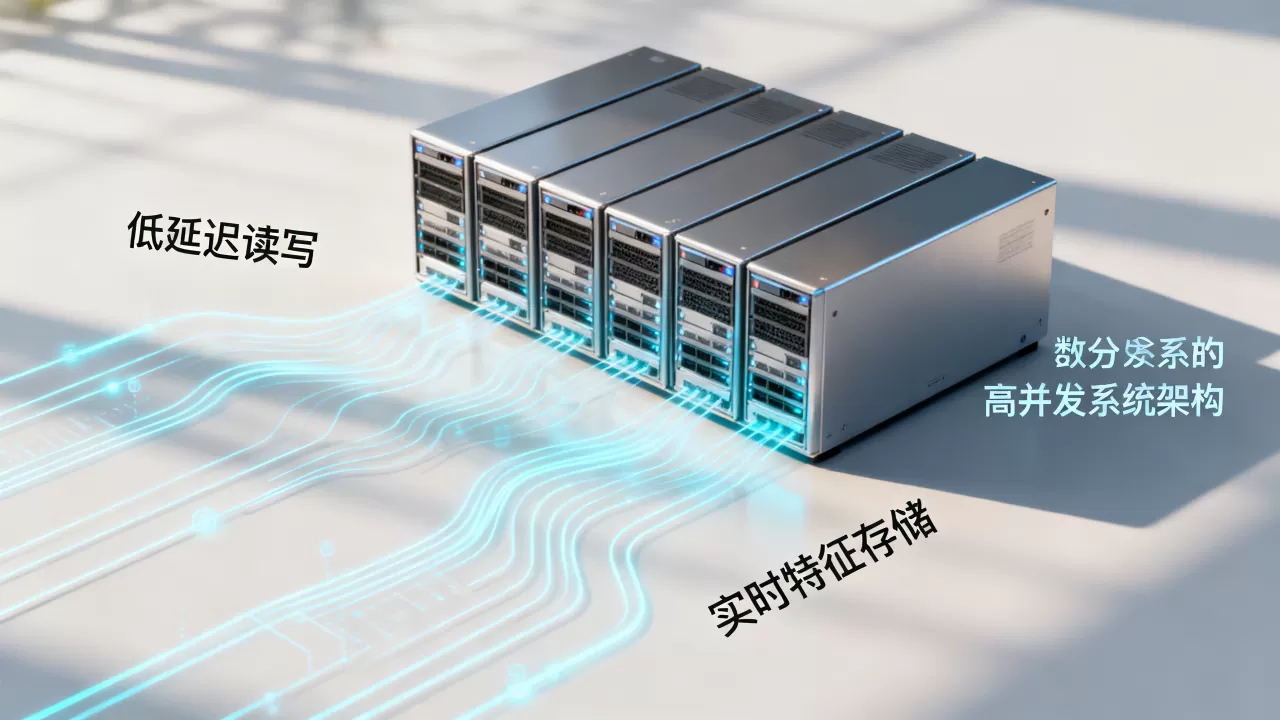
实时特征存储的低延迟读写,核心是把在线特征放进内存级存储,并用分片副本加异步刷盘承接高并发;多数团队从Redis加Flink加Kafka的组合起步,再按特征治理需求升级为独立特征存储。
实时特征存储低延迟读写怎么做:先拆开读路径和写路径
实时特征存储通常服务于推荐排序、风控反欺诈、动态定价、广告竞价这类在线决策场景,它的写入来自流计算任务,读取来自在线推理服务,写要快,读也要快,但两者的优化重心不同。
读路径上的三个优化点
读路径的延迟预算往往只有几毫秒到二十毫秒,超过这个范围,推荐接口的整体延迟就会拖垮用户体验。
- 把热特征放在内存级存储里,比如Redis Cluster、Aerospike、ScyllaDB,磁盘型存储比如HBase、Cassandra在随机点查场景下很难稳定压进十毫秒以内。
- 尽量使用KV结构而不是范围扫描或复杂查询,一个用户ID对应一串特征值,一次
GET或HMGET完成读取,比ZRANGE或SQL查询快得多。 - 在SDK侧做合并读取,推荐服务启动或刷新用户画像时,一次批量取几十个key,而不是逐条远程调用,批量读可以把网络往返开销摊薄。
写路径上的两个实时化手段
写路径的实时性决定了特征的新鲜度,用户刚刚点击一个商品,最好能在下一次请求里就用到这个行为产生的特征。
- 用Flink从Kafka消费行为日志,做滚动窗口聚合后直接写入特征存储,典型写入命令是
HSET user:12345:click_cate_30m electronics 7,把最近30分钟电子类目点击次数更新为7。 - 面对迟到数据或离线特征,采用Lambda架构,实时层负责秒级更新,离线层每天全量重算,用版本号合并,这样即使实时链路丢了消息,第二天也能修正。
特征存储和Redis对比:独立特征存储解决什么问题
很多团队一开始用Redis存特征,跑得也不错,但当特征数量膨胀到几百维甚至上千维,或者多个业务团队要共享同一批特征时,纯Redis就会暴露短板。
| 维度 | Redis 直接存储 | 独立特征存储(如Feast+Tecton类方案) |
|---|---|---|
| 在线读写延迟 | P99可做到几毫秒 | 取决于在线存储选型,通常也在毫秒级 |
| 特征版本管理 | 需要自行维护 | 内置版本回溯和血缘追踪 |
| 离线训练与在线一致性 | 容易不一致 | 通过统一注册和采样保证一致 |
| 特征共享复用 | 靠文档和口口相传 | 有中央注册表和搜索能力 |
| 运维复杂度 | 低 | 较高,需要额外元数据服务 |
什么时候用Redis就够
- 特征数量在几十个以内,团队只有一两个算法工程师。
- 逻辑简单,没有多团队复用诉求。
- 不需要严格的训练预测一致性,离线打个表也能接受。
什么时候必须上独立特征存储
- 特征维度超过数百,多团队同时读写。
- 需要特征血缘和回溯,排查线上指标波动时能快速定位哪条特征变了。
- 在线推理和离线训练必须用同一套特征定义,避免线上线下不一致。
电商推荐场景下实时特征存储:从点击到推荐位更新的链路
电商推荐场景对实时特征存储的压力非常具体,一个用户点击了蓝牙耳机,行为事件进入Kafka,Flink计算该用户最近30分钟对数码类目的点击偏好,写入特征存储,推荐服务在下一个请求里读到这个偏好,把数码类商品权重调高。
实操步骤:一个最小可用链路
- 在Kafka创建
user_behavior_topic,消息包含user_id、item_id、category、event_type、ts。 - 使用Flink SQL定义滑动窗口,按
user_id和category聚合点击次数。 - 将聚合结果写入Redis Hash,key格式为
user_id:feature_name,field为category,value为计数。 - 推荐服务启动时用Pipeline批量读取该用户的全部实时特征,设置超时时间如50毫秒。
- 用Prometheus监控两个指标:特征写入延迟的P99和读取延迟的P99,写入超过1秒就说明链路有堆积,读取超过20毫秒就要检查内存命中率。
这个场景里,读取高峰集中在推荐服务重启、缓存过期或者大促流量峰值时刻,高并发支撑必须提前设计好。
高并发支撑的四个关键设计
高并发不等于堆机器,没有合理的分片、副本和本地缓存,集群越大反而越容易雪崩。
分片与水平扩展
采用一致性哈希把用户ID打散到多个分片,避免使用递增ID或省份前缀做key,否则会出现明显热点,比如北京地区的请求集中在一个分片,大促时直接打满。
读写分离与副本
在线特征存储通常配置一主多从,主节点承载写入,从节点分担读请求,读多写少的场景下,从节点数量可以按QPS比例扩展,Redis Cluster本身支持从节点只读,配置项是cluster-replica-read-only。
连接池与本地缓存
SDK内部维护两层缓存:进程内存缓存和连接池,远程调用前先查本地缓存,未命中再走网络,本地缓存时长通常设置为1到5秒,既降低远程QPS,又不会让特征过于陈旧,这条设计被相当一部分高并发推荐系统采用。
背压与限流
写侧流量突增时,不能让存储无限接收,可以在Flink写入端配置背压,或者在SDK层做令牌桶限流,读侧超过容量时,快速失败返回默认特征,避免拖垮整个链路。
自建实时特征存储成本多少:从服务器到研发人力的粗略账
自建实时特征存储的成本由四块组成:在线存储节点、流计算资源、消息队列、研发运维人力,具体金额因云厂商和地域而异,但可以用一个最小可行方案来估算方式。
- 最小方案:3节点Redis Cluster(每节点8核16G内存)加3节点Kafka加2个Flink任务槽,仅云资源月成本数千元,适合小团队跑通单条业务线。
- 完整方案:独立特征存储需要再加元数据库(MySQL或TiDB)、对象存储(用于离线特征)、监控告警、数据血缘服务,云资源月成本会到数万元甚至更高。
- 人力成本:至少需要1到2名熟悉流计算和分布式存储的工程师,负责运维、调优、故障排查。
成本大头往往不是机器,而是特征治理和在线离线一致性维护,能用Redis跑通的场景,不必急着上完整Feature Store。
北京上海算法团队选型时的常见误区
北京、上海等地的互联网公司算法团队节奏快,业务压力大,容易在实时特征存储选型上踩几个坑。
- 把Redis当作万能层:所有特征都往里塞,结果内存占用失控,key数量太多导致淘汰频繁。
- 忽视离线在线一致性:离线特征用Spark算,在线特征用Flink算,口径不同导致线上模型效果忽高忽低。
- 低估GC停顿影响:Java技术栈的在线特征服务如果使用JVM,频繁Full GC会让P99延迟飙到几百毫秒,选择C++或Rust实现,或者调整GC策略,多数情况下能改善。
- 认为Feature Store太重大:小团队先手动维护一份特征注册表,用Redis加定时采样也能解决大部分问题,不必一开始就引入复杂平台。
实时特征存储的选型没有标准答案,先明确读写延迟预算、QPS量级、特征规模和团队人力,再决定用Redis还是独立Feature Store。
Q&A:实时特征存储低延迟读写与高并发支撑常见问题
实时特征存储低延迟读写怎么做才能稳定在10毫秒以内?
把特征数据全部放在内存存储里,避免任何磁盘随机IO,使用SDK本地缓存,让热key不经过网络,部署时保证在线服务和特征存储在同一机房,减少跨地域网络延迟,监控P99而不是平均延迟,因为平均延迟会掩盖长尾问题,另外关闭不必要的持久化阻塞,比如Redis的AOF_FSYNC_EVERY_SEC改成异步刷盘。
特征存储和Redis对比,独立特征存储值得投入吗?
取决于特征复用程度和团队规模,单业务线、特征少、没有严格离线一致性要求时,Redis足够,多团队共享特征、需要版本管理、需要在线离线一致时,独立特征存储能减少重复开发和口径混乱,长期看更划算。
高并发场景下实时特征存储如何避免热点问题?
打散key设计,不要让单个key的读写量远超其他key,增加从节点副本,让读请求分散到多个节点,写热点可以用异步合并,把多次小幅更新合并成一次写入,实际生产环境多数采用Redis Cluster加本地缓存两层架构,将远程读写比例控制在较低水平。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/637887.html