Shuffle 阶段对网络带宽消耗极大,本质是数据在分布式节点间进行全量重分区,必须从压缩、分区、调度、硬件四个层面同时下手才能显著降低带宽压力。
shuffle阶段网络带宽消耗大怎么办?先看清它的三个“带宽黑洞”
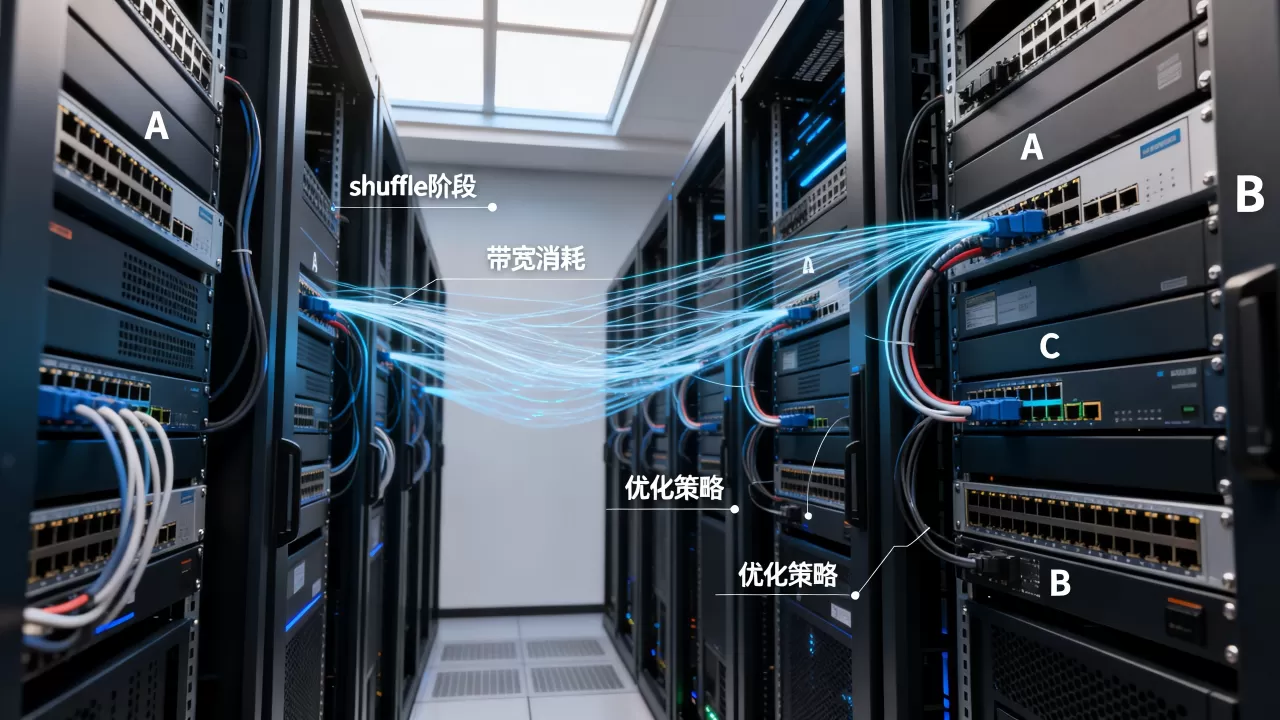
在批处理作业里,shuffle 阶段像一场突然爆发的“早高峰”:所有 Map 任务把中间结果写到本地磁盘后,Reduce 任务几乎同时发起远程拉取,瞬间把机架交换机和核心链路推满,要回答“shuffle阶段网络带宽消耗大怎么办”,得先明白带宽到底花在哪儿。

数据重分区的“搬运”本质
批处理任务通常按 key 做聚合或排序,这意味着 Map 端产出的每一行数据都要根据分区函数发送到对应的 Reduce 节点,跨节点传输不像本地读写,它要经过网卡、交换机、机架间光纤,数据量没有减少,反而因为序列化和协议头略有膨胀,业内专家指出,在典型的 TPC-DS 类批处理负载中,shuffle 阶段占整个作业网络流量的比重相当可观,是集群带宽竞争的主要来源。
中间结果落盘后的“二次搬运”
很多开发者误以为 shuffle 是内存到内存的传输,Spark、MapReduce 等主流框架都采用“Map 端本地写盘、Reduce 端远程拉取”的模型,这带来两次 I/O:先写本地磁盘,再读出来发网络,磁盘和网络轮流成为瓶颈,但网络常常先被打满,因为 Reduce 拉取是并发且突发的。
小文件与低效序列化放大带宽消耗
key 分布不均或分区数过多,shuffle 会产生大量小文件,每个小文件都要独立建立连接、传输元数据、校验,开销远大于传输本身,Java 原生序列化更是体积大、速度慢,直接推高带宽占用,这里的优化空间非常具体,下文会展开。
集群 shuffle 网络拥塞怎么解决?从硬件到调度的实操手册
当集群规模到几百节点,shuffle 造成的网络拥塞不再是单点问题,而是拓扑问题,解决思路可以拆成三层:减少数据量、优化传输路径、隔离与限流。
减少数据量:压缩与序列化
这是投入产出比最高的手段,以 Spark 为例,开启压缩只需两个参数:
spark.shuffle.compress truespark.shuffle.spill.compress true
这会让 Map 端写盘前先压缩,Reduce 端拉取时再解压,用 LZ4 或 ZSTD 算法,CPU 开销小,带宽节省明显,序列化方面,优先使用 Kryo:
spark.serializer org.apache.spark.serializer.KryoSerializer
Kryo 比 Java 原生序列化体积更小,尤其在处理对象和集合时,对网络传输体积有直接压缩效果。
优化传输路径:本地化优先与机架感知
Reduce 任务拉取数据时,调度器会尽量选择同一机架甚至同一节点的 Map 输出,开启机架感知后,节点会周期性上报自己的机架名,调度器据此计算网络距离,在 YARN/Kubernetes 上,可以检查:
topology.script.file.name是否配置- 节点标签是否准确
本地化优先不是万能的,因为 shuffle 天然跨节点,但至少能避免不必要的跨机架流量,集群 shuffle 网络拥塞怎么解决,很大程度上取决于机架拓扑是否合理、交换机是否分层。
隔离与限流:大作业不把集群拖垮
在 YARN 上,可以通过 Capacity Scheduler 的队列资源限制和网络带宽管控组件,给批处理作业设置最大容器数,Kubernetes 下则用 NetworkPolicy 和 CNI 插件做限速,如果条件有限,至少要做到:
- 大作业和小作业分队列
- 夜间跑批和在线查询错峰
- 对 shuffle 阶段单独设置并发拉取上限,如
spark.reducer.maxSizeInFlight调低,减少瞬时带宽尖峰
Spark shuffle 网络带宽优化:参数、压缩与序列化
很多开发者会在 Spark 批处理作业遇到网络瓶颈后问“Spark shuffle 网络带宽优化”到底该调哪些参数,下面按优先级排列。
必须调的三个基础参数
spark.sql.shuffle.partitions:默认 200,对大数据量偏小,会加大单个 Reduce 任务数据量,拖长拉取时间;对中小数据量偏大,会制造过多小文件,应根据数据规模和集群核数调整。spark.reducer.maxSizeInFlight:默认 48MB,控制每个 Reduce 任务从 Map 端拉取数据的单次请求大小,调小能降低瞬时带宽峰值,但会增加请求次数;调大能提升吞吐,但可能打满网卡。spark.shuffle.file.buffer:默认 32KB,Map 端写盘的缓冲,适当调大能减少磁盘随机写,间接降低后续网络读取的碎片化。
进阶:External Shuffle Service 与动态资源
External Shuffle Service 让 Executor 退出后 shuffle 文件依然可读,减少重算,它对带宽的影响是间接的:避免因为 Executor 丢失而重新 shuffle,也就是避免“重复搬运”,开启参数:
spark.shuffle.service.enabled truespark.dynamicAllocation.enabled true
诊断命令
想确认 shuffle 网络是否瓶颈,可以看 Spark UI 的 Shuffle Read/Write 数据量,以及系统层面网卡监控:
sar -n DEV 1ifstat或nload
若 Read 数据量远大于输入数据,且网卡利用率稳定在较高水平,就可以判断是 shuffle 阶段在大量消耗带宽。
批处理 shuffle 与 stream shuffle 对比:为什么前者更容易打满带宽
触发时机与持续时间
批处理 shuffle 与 stream shuffle 对比,最大差异在突发性,批处理作业启动后,Map 阶段集中完成,Reduce 阶段集中拉取,几分钟内产生海量并发连接,流处理作业的 shuffle 分散在持续不断的微批或窗口内,带宽占用曲线更平缓,因此批处理更容易瞬间打满交换机,导致丢包和重传。
数据规模与重分区范围
批处理通常处理历史全量数据,shuffle 数据量动辄 TB 级,流处理每个微批数据量小得多,shuffle 持续时间短,即使在准确一次语义下需要状态迁移,流处理 shuffle 的网络开销也更可控。
优化侧重点不同
批处理 shuffle 优化强调压缩、分区、并行度,流处理则更关注状态后端、检查点和背压,用批处理作业的经验直接套到流处理上,效果往往有限。
大数据 shuffle 网络带宽成本:地域和价格差异
云上带宽费用
在云上跑批处理,shuffle 产生的跨可用区流量通常要额外计费,不同地域的跨可用区流量单价不同,一线城市可用区之间可能比同地域同可用区贵,如果集群节点跨可用区甚至跨地域,shuffle 会显著推高成本,解决办法是把批处理集群部署在同一个可用区内,并开启压缩减少传输量。
硬件成本与机架设计
自建机房场景下,shuffle 带宽消耗直接关系到交换机端口数和光模块成本,一个典型的几百节点集群,shuffle 阶段经常打满核心交换机,要么升级到更高端口密度的万兆交换机,要么重新设计机架内聚合比,这些硬件投入和云上带宽费用本质上是一回事:都要为数据搬运付费。
下表对比几种优化手段对带宽成本的降低效果(以影响程度排序,非精确比例):
| 优化手段 | 主要作用层面 | 对带宽成本的影响 |
|---|---|---|
| 开启压缩 | 减少传输字节数 | 高 |
| Kryo 序列化 | 减少数据体积 | 高 |
| 调整分区数 | 减少小文件与连接开销 | 中高 |
| 本地化/机架感知 | 减少跨机架流量 | 中 |
| 限流与错峰 | 平滑带宽峰值 | 中 |
| 升级网络硬件 | 提升吞吐上限 | 高但一次性投入大 |
Q&A
问题1:shuffle阶段网络带宽消耗大怎么办?
优先开启压缩和高效序列化,然后调整分区数避免小文件,再配合机架感知减少跨机架拉取,如果仍拥塞,考虑错峰调度和网络限流,这是最经济、见效最快的组合。
问题2:Spark shuffle 网络带宽优化参数有哪些?
核心参数包括 spark.shuffle.compress、spark.serializer、spark.sql.shuffle.partitions、spark.reducer.maxSizeInFlight、spark.shuffle.file.buffer,以及启用 spark.shuffle.service 避免重算。
问题3:批处理 shuffle 与 stream shuffle 对比,谁的网络开销更可控?
流处理更可控,因为微批数据量小、传导平缓,批处理 shuffle 是集中突发流量,对网络冲击大,需要更主动的压缩和调度优化才能收敛。
一句话总结:shuffle 阶段的带宽消耗不是无法治理的“顽疾”,只要把压缩、序列化、分区和调度这四件事做到位,批处理作业的网络体验会有显著改善。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/638752.html