大容量数据湖要同时解决存储容量和读写带宽两条增长曲线,可水平扩展的对象存储能把这两条曲线绑在同一套分布式架构上,避免越存越慢。
数据湖对象存储怎么选:先看水平扩展的底层逻辑
数据湖里最先不够用的往往不是磁盘,而是数据进出通道,PB级数据写入后,如果读取带宽不能随节点线性增加,计算任务就会排队等待,数据湖会变成“数据沼泽”。

为什么单独堆存储容量没有用
传统存储扩容思路是加硬盘柜、加控制器,容量上去了,但控制器和前端网络带宽是固定的,多块盘共享一条窄链路,数据越大,全量扫描时间越长。
数据湖的典型场景是每天新增TB级日志、图片、视频特征,以及后续的SQL查询、机器学习训练,这些任务需要同时读取大量对象,如果对象存储节点之间只有几个固定的吞吐出口,那么客户端连接数一多,延迟就会明显上升。
带宽扩展能力决定数据湖上限
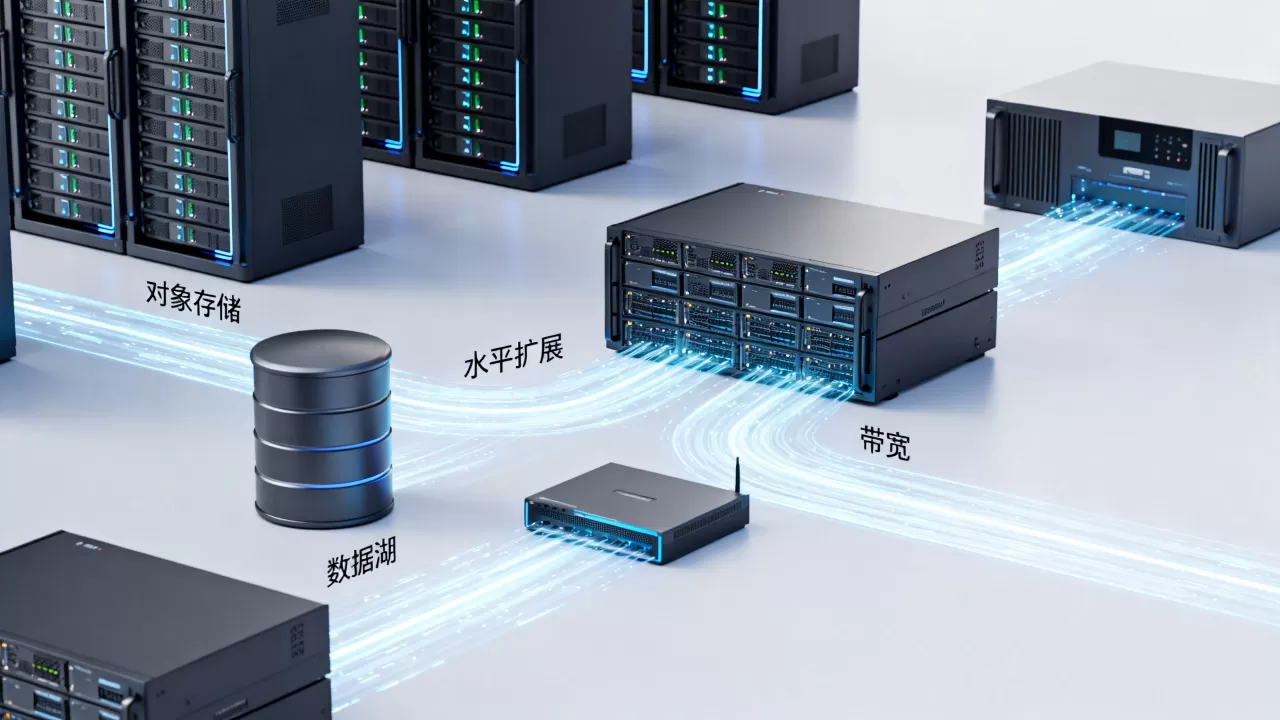
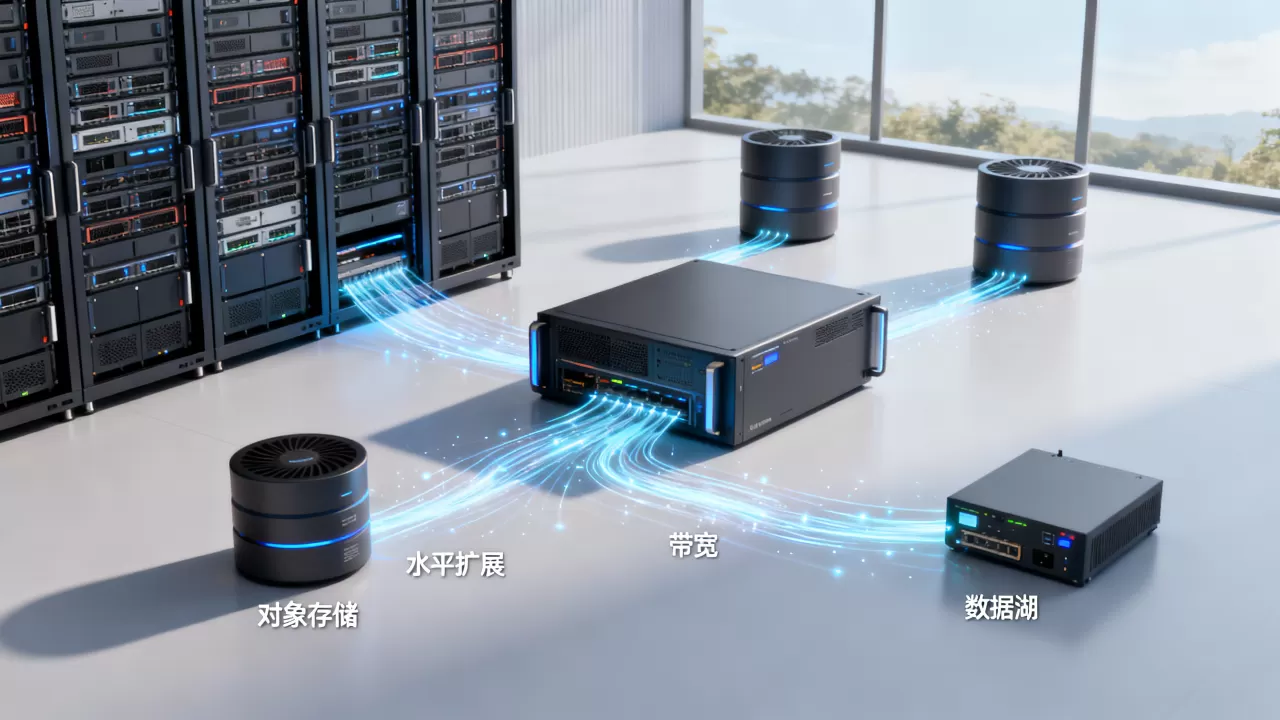
可水平扩展的对象存储,核心特征是把存储、元数据、访问带宽都设计成分布式,增加存储节点,不仅容量增加,读取和写入吞吐也随之增加,这跟原来的“容量扩了、带宽不变”有本质区别。
行业共识认为,数据湖架构下带宽瓶颈往往先于容量瓶颈出现。
所以在选型时,要问清楚几个具体问题:
- 单个桶的最大吞吐量是否随节点数量线性增长
- 是否支持多个客户端并发读写同一前缀而不互相阻塞
- 元数据查询是否会成为高并发List操作时的短板
- 是否提供S3兼容接口,方便接入Spark、Flink、Trino等计算引擎
不要只看每GB单价,还要看“每GB带宽能力”是否够用。
对象存储和HDFS对比,大容量数据湖该怎么选?
很多团队还在纠结用HDFS还是对象存储,直接给结论:数据湖场景下,对象存储更适合做长期主存储,HDFS更适合作为计算近距离缓存层。
| 对比项 | 对象存储 | HDFS |
|---|---|---|
| 容量扩展 | 增加节点即可,几乎无上限 | 需要扩容DataNode,受NameNode元数据限制 |
| 带宽扩展 | 随节点和并发连接扩展 | 受单个NameNode吞吐影响,大集群需联邦 |
| 运维复杂度 | 托管服务多,无需关注节点故障 | 需要自己维护副本、机架感知、块报告 |
| 成本模型 | 按容量和请求计费,冷热分层灵活 | 需要预留大量低成本服务器,但也要为三副本买单 |
| 计算兼容 | 通过S3协议被主流计算引擎支持 | 原生支持,但需要HDFS客户端 |
什么时候不要急着替换HDFS
实时写入压力极大、对延迟毫秒级敏感的部分,可以保留HDFS作为热数据层,对象存储负责全量数据湖底座,HDFS只放最近几天的热数据,这样兼顾性能和成本。
大容量数据湖带宽要求:从实际计算场景倒推
批处理与实时分析场景
假设数据湖里有一个原始日志分区,每天新增数据量在TB级,夜间跑Spark ETL,需要把当天的数据全部读一遍、清洗、写回ORC格式。
如果对象存储提供的聚合读取带宽有限,任务可能拉长到第二天白天,影响实时分析,此时带宽要求取决于并发任务数。
可以这样估算:
- 单任务需要的数据吞吐量 = 数据量 / 允许完成时间
- 聚合带宽需求 = 单任务吞吐量 × 同时运行的任务数
- 再加上实时查询、机器学习数据加载等额外流量
- 留出一定冗余,避免网络抖动影响SLA
多数情况下,数据湖的带宽需求不是固定值,而是随计算集群规模弹性变化,对象存储要能匹配这种弹性。
如何验证对象存储的带宽能力
不要只看厂商宣传的“每节点XX Gbps”,自己做压测最可靠。
常用工具包括:
s3bench:模拟S3读写吞吐warp:MinIO官方压测工具cosbench:适合大规模对象存储基准测试
压测时关注:
- 小对象并发读写的OPS
- 大对象顺序读写的MB/s
- 多客户端混合读写时的尾延迟
- 元数据操作如List、Head的响应时间
大数据场景对象存储价格多少钱?先拆清四个计费项
对象存储成本不只是每GB单价,数据湖规模一大,请求费和流量费可能比存储费还高。
存储容量费
按实际使用量计费,标准存储通常每GB每月几厘到几分钱,冷归档、深度归档可以低到每GB每月不到一分钱,但取回需要等待。
请求费用
PUT、GET、LIST、DELETE等都会计费,小文件数量多时,请求费会非常可观,比如物联网设备每5秒上传一条小记录,一个月产生的请求次数是百万级。
流量费用
公网下行流量通常收费较高,内网流量多数免费或成本极低,跨地域复制数据也会产生流量费用,北京地域对象存储向上海地域传输数据,会算跨地域流量。
数据取回与生命周期转换费
冷数据转回热层、归档取回都会产生额外费用,合理设置生命周期策略可以减少这部分支出。
北京地域等地域选择对成本和延迟的影响
计算集群在北京地域,对象存储也放在北京地域,内网访问通常免流量或流量单价较低,延迟也低,如果存储放在其他地域,每次读取都要跨地域,既慢又贵。
所以在做成本估算时,至少要把下面几项加在一起:
- 存储容量费
- 预估每月读写请求次数
- 内网/公网/跨地域流量费
- 生命周期转换和取回费用
- 可能的数据管理功能费,如对象版本控制、跨区域复制
可水平扩展的对象存储与带宽实操配置
第一步:选择S3兼容接口
数据湖计算引擎对S3协议支持最好,Spark、Flink、Trino、Hive都可以直接读写S3兼容对象存储,不需要额外插件。
第二步:规划桶和前缀
不要把整个数据湖放在一个桶里,也不要创建太多桶,建议按数据域、业务线分桶,桶内用日期、业务类型做前缀。
示例前缀结构:
s3://dl-raw/app_logs/2026/01/01/
s3://dl-raw/user_events/2026/01/01/
s3://dl-curated/sales/region=beijing/
第三步:配置生命周期策略
建桶后马上配置生命周期,避免冷数据长期占用标准存储,常见规则:
- 超过30天未访问,转低频存储
- 超过180天未访问,转归档存储
- 桶开启版本控制时,设置非当前版本过期时间
第四步:命令行初始化与并发调优
以S3兼容客户端为例,上传大目录时可以用并发参数压满带宽。
mc alias set datalake https://s3.example.com ACCESSKEY SECRETKEY
mc mb datalake/dl-raw
mc cp --recursive --concurrency 16
  /data/app_logs/2026/01/01
  datalake/dl-raw/app_logs/2026/01/01/
下载时同样可以调高并发:
mc cp --recursive --concurrency 32
  datalake/dl-curated/sales
  /tmp/sales_restore/
注意并发数不是越大越好,过高会触发服务端限流,反而降低总吞吐,建议从8、16、32逐步测试,观察客户端与服务端错误率。
第五步:压测与监控指标
上线前用压测工具确认带宽是否达标。
例如使用MinIO的warp工具:
warp get --host=s3.example.com --access-key=ACCESSKEY --secret-key=SECRETKEY
  --bucket=warp-test --duration=1m --obj.size=10MiB
生产环境持续关注这些指标:
- 对象存储每秒请求数
- 平均/尾部延迟
- 读写带宽利用率
- 限流错误比例
- 元数据服务响应时间
一旦发现带宽增长跟不上节点扩容,说明对象存储的水平扩展设计存在问题,需要重新评估架构。
收尾:把存储和带宽当作同一个资源池来管
数据湖扩容时,别再单独问“我需要多少TB”,应该问“我需要多大容量,以及多快的并行读写能力”,可水平扩展的对象存储用统一分布式架构同时回答这两个问题,它让扩容动作从更换设备,变成增加节点,带宽随节点长出来,容量也随节点长出来,数据湖才不会越用越慢。
Q&A:大容量数据湖可水平扩展的对象存储选型常见问题
大容量数据湖需要多高的带宽才能支撑Spark任务?
取决于同时运行的Spark任务数和单任务处理的数据量,可以先测出单个Executor的吞吐需求,再乘以并行Executor总数,得到聚合带宽下限,然后用对象存储压测工具验证实际可达吞吐,留出20%到30%的冗余即可,没有固定数值,一切以压测为准。
对象存储和HDFS对比,数据湖用哪个更省钱?
多数情况下对象存储总拥有成本更低,因为不需要为三副本准备额外服务器,冷数据可以自动分层,但如果数据量不大、计算密集且请求数极高,HDFS的固定成本可能更可控,核心还是按实际使用量算账,不要只看每GB单价。
大容量数据湖可水平扩展的对象存储有哪些主流选择?
主流云厂商提供的对象存储服务均支持水平扩展,例如AWS S3、简米云OSS、酷番云COS、华为云OBS,开源方案中MinIO部署简单,支持S3接口,常见于私有化数据湖,选型时要关注S3兼容性、扩展方式、运维工具链和地域覆盖,最后一个问题的答案以事实结尾:S3协议已经成为数据湖对象存储的事实标准接口。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/640087.html