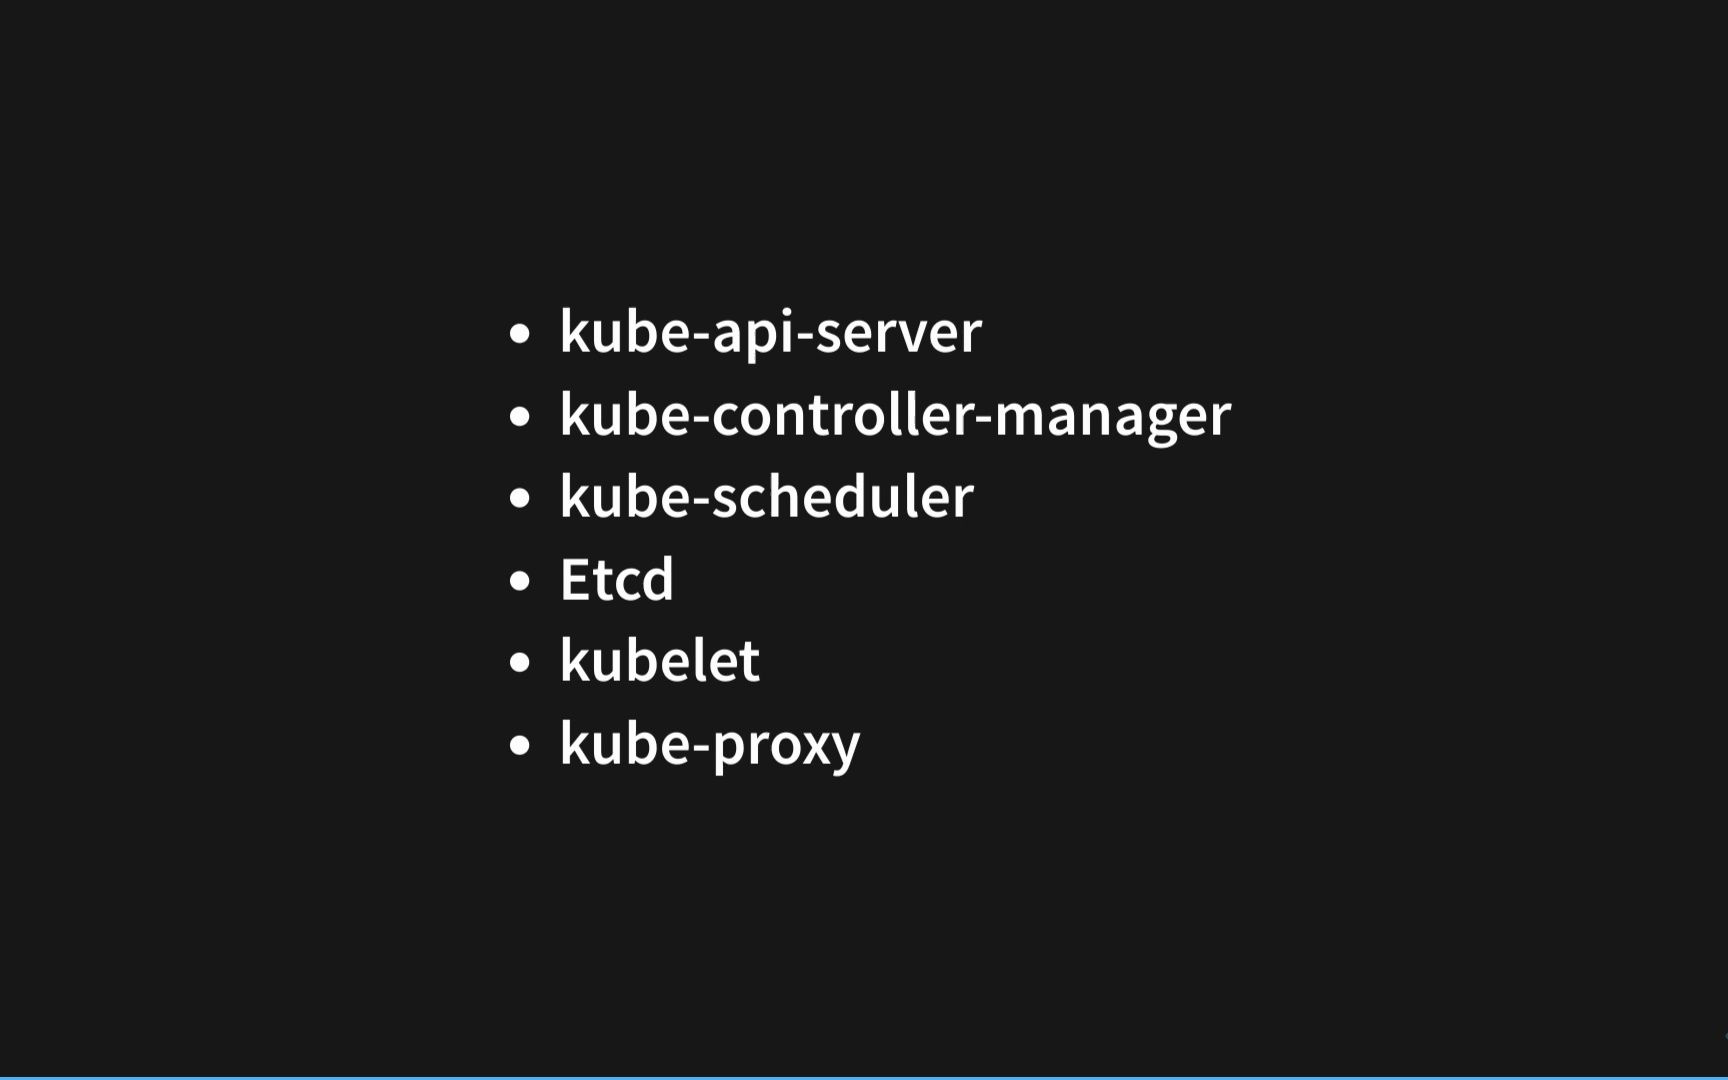
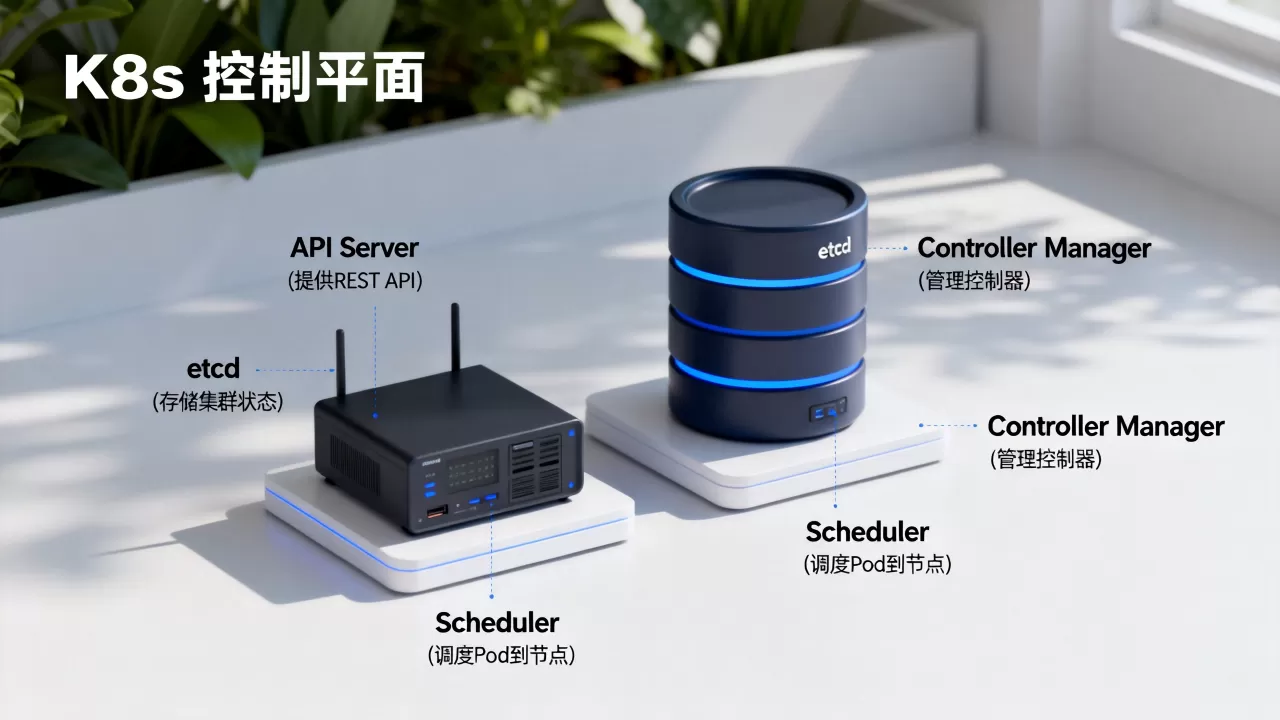
Kubernetes控制平面由kube-apiserver、etcd、kube-scheduler、kube-controller-manager四个核心组件共同构成,云环境下通常还包含cloud-controller-manager,它们负责集群的决策、调度、状态维护与对外接口,是整个集群名副其实的“大脑”。
Kubernetes控制平面组件有哪些?四驾马车各司其职
很多朋友第一次接触Kubernetes,先被一堆以kube-开头的组件绕晕了,别急,控制平面并不复杂,核心参与决策的只有四个组件,行业共识认为,理解了这四个组件,就理解了集群的大脑如何运转。
kube-apiserver:所有请求的唯一入口
kube-apiserver是控制平面的“门卫兼前台”,无论是kubectl命令、Pod的健康检查回调,还是worker节点上kubelet的注册和心跳上报,所有请求都必须经过它。
它的职责有三层:
- 身份认证与授权:校验请求者是谁(证书或Token),有没有权限做这个操作。
- 请求转发与校验:把合法的请求转发给etcd存储,同时校验配置的合法性,比如Pod的字段是否规范。
- 消息广播:当资源状态发生变化时,通知其他组件(如scheduler和controller-manager)做出响应。
没有它,整个集群就像断了线的木偶,kubectl get nodes都回不了话。据企业落地现状来看,判断控制平面是否健康,第一件事就是看apiserver的进程状态和日志。
etcd:整个集群的记忆中枢
etcd是控制平面里的“账本”,所有集群数据节点信息、Pod配置、ConfigMap、Secret、网络策略都以键值对形式存在这里,它不关心业务逻辑,只负责可靠地存数据。
值得注意的细节是,etcd不仅存配置,还存“状态”,控制器从etcd读期望状态,又从apiserver同步实际状态,两者一对比,就知道该做什么操作,所以etcd挂了,整个集群会进入只读或不可用状态,即使worker节点上的Pod还在跑,你也无法做任何变更。
kube-scheduler:Pod住进哪台节点的决策者
scheduler扮演“房产中介”的角色,但它只看房,不负责搬家,它监听apiserver里新建的Pod,然后用一系列规则筛选出最适合的节点,并打上调度决策的标记。
它的判断逻辑分两步:
- 过滤:剔除不满足条件的节点,比如端口冲突、资源不足、节点处于NotReady状态。
- 打分:在剩余节点里按资源余量、亲和性规则打分,分高的胜出。
日常排障中,
Pod一直Pending,八成是scheduler这里卡住了,要么资源不够,要么有污点容忍不匹配。
kube-controller-manager:让世界保持期望状态的管家
controller-manager是控制平面的“巡警队”,它里面跑着一堆小而专的控制器,各管一片。
- Node controller:负责监控节点健康,节点失联时标记状态。
- Replication controller:保证副本数不缩水,Pod挂了就补新的。
- Endpoint controller:维护Service和后端Pod的关联关系。
- ServiceAccount与Token controller:管理服务账号的凭证。
道理很简单:控制器盯期望状态,现状偏离了就通过apiserver下命令矫正,比如你声明了3个Nginx副本,有1个挂掉了,controller-manager立刻会补一个起来。
Kubernetes Master节点组件详解:角色与协作逻辑
上一段的描述主要聚焦单组件行为,接下来我们把这四兄弟放在一条真实请求链路里,看它们如何配合,这也是面试高频考察点,属于Kubernetes Master节点组件详解里绕不开的内容。
假设你执行一条命令:kubectl apply -f deployment.yaml
完整的协作流如下:
- kubectl把Deployment定义发给kube-apiserver。
- kube-apiserver校验身份和字段合法性,写入etcd。
- controller-manager里的Deployment控制器发现“期望副本数3”和“当前副本数0”不一致,调谐时创建3个Pod对象,同样经apiserver写入etcd。
- kube-scheduler监听到未调度的Pod,经过过滤和打分,选出3个不同的worker节点,并调用apiserver更新Pod的nodeName字段。
- kubelet(worker节点的代理)看到自己的节点上有新Pod分派过来,调用容器运行时(如containerd)真正把容器拉起。
注意,整个流程里没有哪个组件直接碰容器,所有通信都经apiserver中转,这意味着apiserver是整个控制平面的通信枢纽,同时也是最大的性能瓶颈,生产环境集群规划时,管理员通常会给apiserver预留充足的CPU和内存,并开启缓存来降低etcd读压力。
Kubernetes控制平面故障怎么排查?三条最实用的检查路径
后台经常有读者问,集群突然不能创建Pod了,或者kubectl命令卡住不动,该从哪看起?Kubernetes控制平面故障怎么排查,建议按下面顺序逐一排除。
先查apiserver,再查etcd
kubectl直接报连接超时,多半是apiserver掉点或证书过期,先在本机模拟请求:
kubectl get --raw=/healthz
如果返回ok,说明apiserver自身健康,接着查etcd状态:
ETCDCTL_API=3 etcdctl endpoint health --cacert=/etc/kubernetes/pki/etcd/ca.crt --cert=/etc/kubernetes/pki/etcd/server.crt --key=/etc/kubernetes/pki/etcd/server.key
etcd不健康时,最常见的现象是kubectl能连上但命令持续卡顿,因为apiserver等待etcd响应的超时时间很长。
scheduler不调度,先看资源再看污点
Pod卡在Pending,scheduler日志里通常有原因,看调度事件最直接:
kubectl describe pod <pod-name>
Events里写得很清楚,常见的两类原因是节点资源不足(CreateContainerConfigError前一步的FailedScheduling)或节点有污点而Pod没有对应容忍。
controller-manager不干活,看Deployment状态
副本数一直对不上,但scheduler没报错,就看controller-manager日志,用kubectl get deployment -A查看AGE列,如果新建的Deployment很长时间AGE没有增长,且kubectl get replicaset显示DESIRED为0,说明Deployment控制器没启动调谐循环,检查controller-manager进程的leader选举状态,确认只有一台master在真正工作。
高可用控制平面怎么搭?部署方式与避坑建议
控制平面是大脑,大脑挂了集群就瘫了,生产环境通常部署3个master节点,实现高可用。
为什么是3个而不是2个?这取决于etcd选主投票机制。多数场景下,3节点容忍1个节点故障,2节点没有容忍度,任何单点故障都会导致选举无法完成。
当前主流的部署方式有三种,各有取舍,下面用表格直观对比:
| 部署方式 | 难度 | 维护成本 | 适用场景 | 典型工具 |
|---|---|---|---|---|
| kubeadm部署 | 中 | 中 | 中小集群,公司内外网隔离环境较多 | kubeadm + keepalived + haproxy |
| 二进制部署 | 高 | 高 | 特殊定制环境,老牌运维团队偏持 | systemd + etcd集群 |
| 云厂商托管服务 | 低 | 几乎为零 | 公有云用户,按需付费,无需自维护 | 简米云ACK、华为云CCE,Amazon EKS |
自建方式中,apiserver需要前置一个负载均衡器(通常是haproxy或云负载均衡),三个master节点的kubelet、kube-scheduler、kube-controller-manager都会以
--leader-elect=true运行,通过选举机制保证同一时刻只有一个活跃实例。
一个常见误区是:自建集群时把ETCD和控制平面放在同一批机器上,这是可以的,但要对etcd做独立的数据盘和IOPS保障。etcd对磁盘延迟极其敏感,IO抖动会直接拖垮apiserver响应。
对于预算充足的公司,更多人会选云厂商的托管Kubernetes服务,原因很简单:省去自建master节点的运维成本和升级麻烦,也不用操心apiserver高可用问题,按节点资源计费,长期看比自建更稳定。
Q&A:关于Kubernetes控制平面,还有三个高频疑问
问题1:Kubernetes控制平面和worker节点可以混部吗?
技术允许,Kubernetes并不强制禁止混部,取消master节点上的污点即可,但生产环境不推荐,混部会带来两个风险:业务Pod资源暴增挤占系统组件资源,以及高负载下拖慢apiserver和etcd响应。绝大多数生产环境会把控制平面和业务节点彻底隔离。
问题2:etcd数据备份恢复难不难?
没有想象中复杂,使用etcdctl的snapshot命令即可:
ETCDCTL_API=3 etcdctl snapshot save backup.db --cacert=/etc/kubernetes/pki/etcd/ca.crt --cert=/etc/kubernetes/pki/etcd/server.crt --key=/etc/kubernetes/pki/etcd/server.key
恢复时先停掉所有apiserver,再用etcdctl snapshot restore恢复到新目录,重建集群即可。据CNCF相关调查,约相当比例的企业只在部署初期做过一次备份演练,之后没有定期验证恢复流程,建议运维团队每季度执行一次恢复演练,至少保证备份文件能顺利拉起集群。
问题3:Sandbox、Podman和Kubernetes控制平面是什么关系?
三者不在一个维度,Kubernetes控制平面是编排层,Sandbox和Podman属于容器运行层,Kubernetes使用Pod通过CRI(容器运行时接口)与containerd、CRI-O或Podman协作,控制平面不关心底层用哪个运行时,只要实现CRI标准即可接入。
围绕Kubernetes控制平面,核心组件就这四件套加一个可选的云控制器,掌握它们各自的职责、协作链路和典型排障路径,日常维护就不会感到无从下手。遇到集群问题,先判断是入口(apiserver)、存储(etcd)还是调度决策(scheduler / controller-manager)出问题,通常能快速缩小范围。熟练之后,再看那些复杂的Operator和CRD,本质仍是这四驾马车加上webhook的弹性协作。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/640371.html