容器资源争抢的根源在于只设了请求没设限制,或者两者差距过大,核心答案:给每个容器同时设置合理的requests(预留值)和limits(上限值),requests负责让调度器把Pod放在容量足够的节点上,limits负责在运行期间强制约束用量,两者缺一不可。
kubernetes 资源requests和limits如何设置才能避免争抢
容器圈流传着一句话:不设limits的Pod是好邻居,设了requests不设limits的Pod是定时炸弹,要理解这句话,得先弄明白CPU和内存的争抢到底发生在哪个层面。
CPU与内存:争抢发生在哪里
CPU争抢发生在内核的调度层,Linux内核用完全公平调度器(CFS)给每个进程分配CPU时间片,当节点上有多个容器都在忙时,内核按权重切分CPU,这个权重就是你在YAML里写的requests值。
内存争抢则发生在物理页分配层。内存没有”时间片”概念,谁申请谁占住,直到进程退出或被杀掉,当节点内存耗尽时,内核会启动OOM Killer,按评分挑一个进程干掉。
两个层面的表现完全不同:
- CPU争抢表现为延迟上升、吞吐下降,但一般不会让容器死掉
- 内存争抢表现为容器突然被杀,OOMKilled成为最常见死因
request决定调度,limit决定上限
requests是你要给这个容器的保底承诺,Kubernetes调度器看的是它,调度器会扫描所有Pending的Pod,算出每个节点的已分配requests总和,只有剩余量大于新Pod的request才放行。
limits是运行时强制的天花板,kubelet和容器运行时盯着它,CPU超过limit会被节流,内存超过limit直接触发OOM Kill。
现实中常见的配置误区:
- 只写requests不写limits:调度够宽松,但一个疯狂使用CPU的容器能挤占邻居的时间片
- 只写limits不写requests:调度器认为这个Pod占用为0,会把多个大Pod塞进同一节点,结果运行后一起爆
- requests等于limits:资源利用率和稳定性最好,但node上会留出大量无法调度其他Pod的”空账”
你真正需要做的是分场景定义策略,对于线上核心服务,requests贴近实际使用量,limits留出一定缓冲,对于离线任务,反过来,requests给低,limits给高。
k8s 容器资源限制配置参数与验证命令
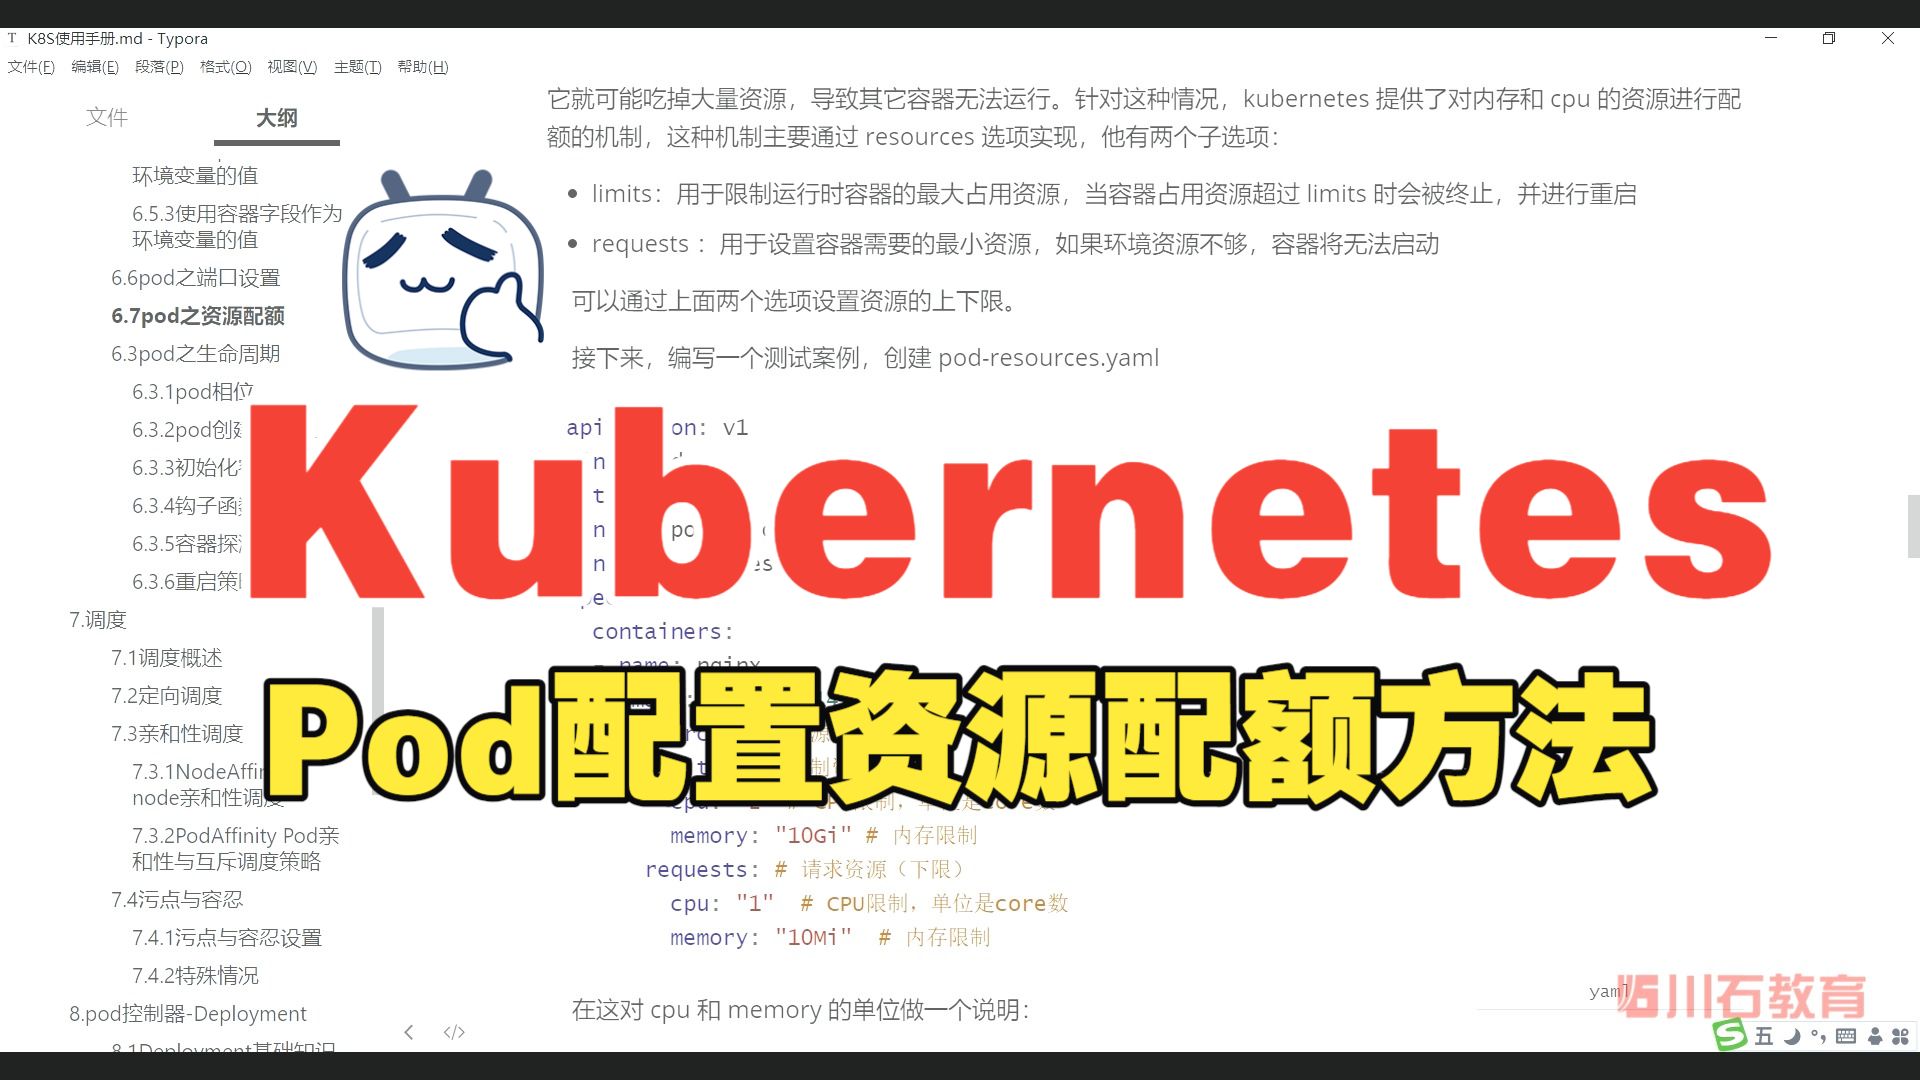
写参数本身很简单,在Deployment的resources字段里就能配置:
resources:
  requests:
    cpu: "1"        # 需要1个CPU核
    memory: "512Mi" # 需要512MB内存
  limits:
    cpu: "2"        # 最多用到2个CPU核
    memory: "1Gi"   # 最多用到1GB内存
查看当前资源现状和压力
动配置之前,先看节点现状。一个节点是否已经处于内存压力状态,直接决定新Pod能不能调度上去:
kubectl describe node <节点名>
输出里有一段Requests字段,直接列出当前节点上所有Pod的requests总量,对比节点的allocatable(可分配量),就能算出还剩多少空间,再看Conditions部分,MemoryPressure如果为True,说明这节点已经内存吃紧。
查看Pod实际使用量:
kubectl top pod --sort-by=memory
kubectl top node
这里的数字是实时采样值,不代表峰值,经验做法是连续观察一周,取P95或P99的值作为requests基准,峰值不超过limits的1.5倍。
推荐的配置起始值
行业共识认为,requests和limits的比例控制在1:1.2到1:2之间比较稳,比例太高,浪费严重;太低,负载突增时根本来不及扩容。
| 场景 | requests建议 | limits建议 | 备注 |
|---|---|---|---|
| 常规Web服务 | 历史峰值P95用量 | requests × 1.5 | 应对突发流量 |
| 定时任务/批处理 | 平均用量 | 峰值用量的上限 | 跑完就退出,不长期占资源 |
| Java/Node.js等等内存敏感应用 | 堆内存上限 + 约20%开销 | 比requests高一点 | 防OOM,但别给太宽 |
启动Java应用时,-Xmx参数和limits要联动,如果limits给2G但堆最大设了3G,容器会在堆没用完时就被内核杀掉,很多团队部署Java服务后发现Pod频繁重启,排查到最后就是这问题。
命名空间层面的兜底:LimitRange与ResourceQuota
光靠开发自觉不够,运维需要在命名空间层面加护栏
,比如某公司有开发环境、测试环境、生产环境三个namespace,需要让不同环境的Pod遵守不同配额规则,这样资源限制配置才能防止互相争抢。
LimitRange:给每个Pod定默认值
如果一个团队忘了写资源请求,LimitRange会自动帮你补上:
apiVersion: v1
kind: LimitRange
metadata:
  name: default-limit-range
spec:
  limits:
  - default:
      memory: 512Mi
      cpu: "1"
    defaultRequest:
      memory: 256Mi
      cpu: "0.5"
    max:
      memory: "2Gi"
      cpu: "4"
这样一来,哪怕开发者的YAML里什么都没配,Pod也会被自动加上默认值。最大最小值的限制保证了一个应用不能把节点资源全抢走。
ResourceQuota:控制总量
LimitRange管单Pod,ResourceQuota管整个namespace的累计量:
apiVersion: v1
kind: ResourceQuota
metadata:
  name: quota
spec:
  hard:
    requests.cpu: "20"
    requests.memory: 40Gi
    limits.cpu: "40"
    limits.memory: 80Gi
QoS等级:争抢极端时谁先受罚
当节点资源耗尽,kubelet开始驱逐Pod时,QoS等级决定驱逐顺序,QoS等级有三档:
- Guaranteed:每个容器都设置了requests和limits且两者相等,这类Pod最后被驱逐
- Burstable:requests小于limits,至少有一个容器设置了requests,大多数线上应用属于这一类
- BestEffort:完全没有设置requests和limits。驱逐时最先被干掉
很多团队会把核心数据库的requests和limits设成完全相同,目的就是拿到Guaranteed待遇,代价是节点上浪费的资源较多,调度器会优先把这类Pod分散到不同节点。
配置思路与常见误区
一个比较完整的配置流程应该是:
- 跑基线压测:用wrk、JMeter打流量,记录CPU和内存的水位线
- 设置requests:取峰值水位线的80%左右,留出波动空间
- 设置limits:为CPU的突发预留20%到30%增量,内存limits不要超过实际硬上限
- 观察HPA表现:如果内存超过80%触发扩容,说明requests设得太低,贴近业务真实用量
-

持续治理:每周看一次kubectl top输出,按滚动平均值调优
三个最常见的设置错误
内存limits不匹配JVM堆配置,Java进程的内存包含堆内、堆外、元空间、线程栈、直接缓冲区,只给堆设-Xmx,堆外依然可能撑爆limits,正确做法是让容器内存limits比-Xmx多出容器内存的20%左右。
给所有容器分配相同规格,有的容器处理消息,有的做计算,用量曲线完全不同,统一规格意味着部分Pod空转浪费,部分Pod长期接近limit。
忘记考虑daemonset和系统预留,每台节点上有kubelet、容器运行时、日志采集器,这些也要占资源。
k8s容器资源限制配置常见问题
问:为什么不设置requests只设置limits会更容易导致容器资源争抢?
调度器只看requests来放置Pod,如果requests为0,调度器认为这个Pod不占资源,会默认把所有节点都当成足够空闲,实际运行时Pod的用量可能远超预测,多个此类Pod凑在一起,节点负载瞬间超标。limits只能限制单个容器不能超过上限,但管不了节点上总共放了多少个容器。
问:Pod被驱逐是看requests还是看limits?
看节点实际压力,当节点内存使用总量超过可分配量时,kubelet先按QoS等级驱逐BestEffort,再驱逐Burstable,最后才动Guaranteed,判断谁先用完自己的配额时,Kubernetes比较的是requests与当前实际使用量的差值差距最大者优先被驱逐。
问:如何判断limits是否设置得过低?
看两个指标,一是CPU节流率,通过rate(container_cpu_usage_seconds_total[5m])和rate(container_cpu_cfs_throttled_seconds_total[5m])的比值,节流率超过10%说明CPU limits太紧,二是Pod的OOMKilled事件,持续出现kubectl describe pod里的OOMKilled状态,说明内存limits偏低,该考虑扩容或调参。
问:生产环境节点是否应该设置CPU的requests和limits完全一样?
多数情况下不建议,像Java服务、DPDK这类应用CPU曲线波动较大,设置的requests等于limits会频繁触发CPUShares分配不均,其他Pod需要等待CPU时间片。Golang或Rust这类编译型服务如果能稳定控制CPU使用率,可以做成Guaranteed。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/640632.html