Kubernetes调度器为Pod挑选节点的过程,本质上是一个先排除“不能用的”,再从“能用的”里面挑“最合适的”的两阶段筛选机制。它通过过滤(Predicates)和打分(Priorities)两个步骤,结合资源请求、亲和性规则、数据卷位置等约束条件,最终为每个Pod锁定一个最优的宿主机节点。
调度器挑选节点的完整两阶段流程
调度器在实际工作时不跟Pod直接对话,而是通过API Server获取集群里所有Node的信息,它干活的顺序可以拆解为两个明确的阶段。

第一阶段:过滤(Predicates)淘汰不符合条件的节点
调度的第一步是“排雷”,调度器会把集群里所有Node扫一遍,把那些不满足Pod硬性要求的节点直接划掉,这些硬性条件包括几个常见维度:
- 资源是否够用:Pod声明的CPU、内存请求值,加上该节点上已经分配出去的资源总和,不能超过节点的可分配容量。
- 端口是否冲突:如果Pod指定了hostPort,而这个端口已经被同节点上其他Pod占用,那这个节点要被淘汰。
- 磁盘和卷限制:Pod用到的持久化卷声明,必须能挂载到目标节点上,有些卷是区域性的,Node不在那个区域也直接被排除。
- 节点状态:节点处于NotReady或者被标记为不可调度(Cordon状态),直接跳过。
- 容忍度检查:如果Pod没有设置Tolerations,而节点上有Taints(污点),那这个节点不参与后续的打分阶段。
这个阶段没有任何人情味,只按Pod的规格要求硬性筛选,只有全部规则都满足的节点,才能进入下一轮。
第二阶段:打分(Priorities)给节点排名次
过滤完之后剩下来的节点,都是“能满足基本生存需求”的节点,可到底选哪个?这就需要给每个节点打分,得分最高的胜出,Kubernetes内置了多个评分策略,最终得分是各项策略按权重计算后的总和。
常用的打分策略有以下几种:
- LeastRequestedPriority:计算节点的资源空闲率,空闲资源比例越大的节点得分越高,这能保证集群负载相对均衡,避免资源都堆在一台机器上。
- BalancedResourceAllocation:查看CPU和内存的使用比例是否接近,如果一台机器CPU吃紧但内存空闲,得分会偏低。
- NodeAffinity:根据Pod的affinity规则匹配程度来加分,越匹配分越高。
- TaintToleration:能容忍更多污点的节点,分数会更高一些,这意味着即使Pod能通过阶段一的容忍检查,阶段二仍会把它推向更“宽松”的节点。
- InterPodAffinity:如果两个Pod需要部署在一起,那目标节点上已经运行了符合条件的相邻Pod,该节点会得到额外加分。
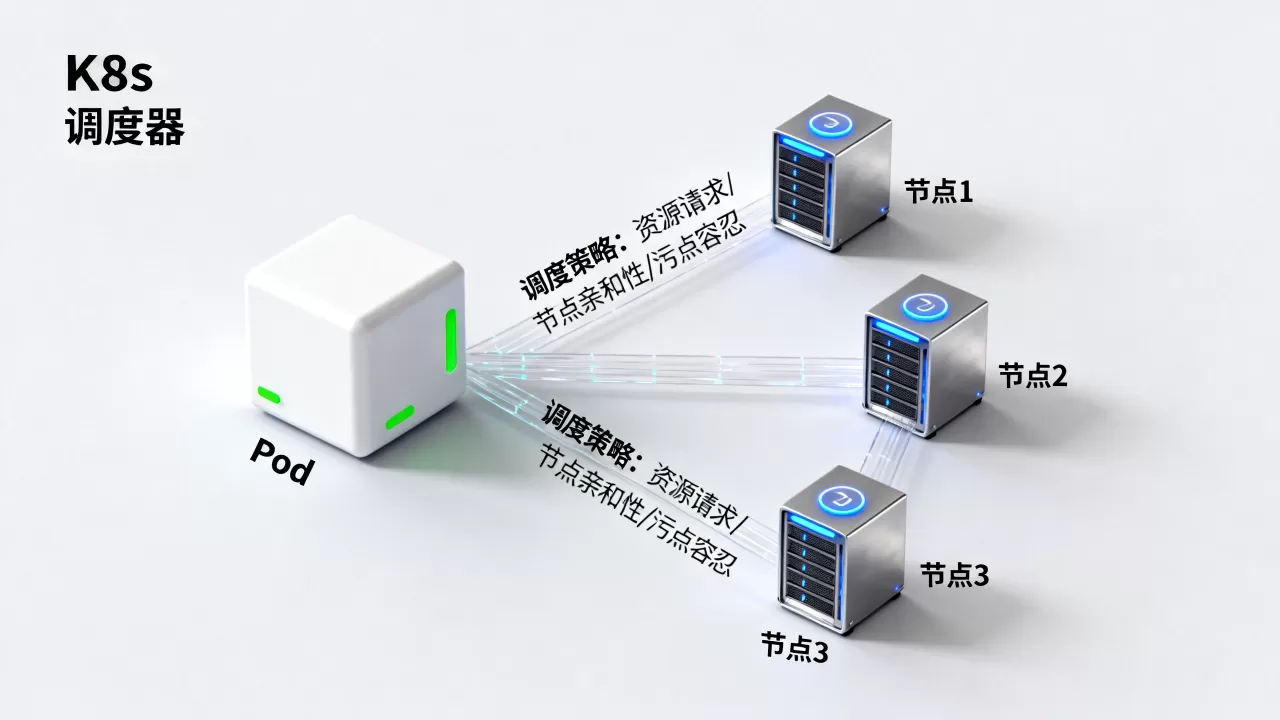
打分结果出来后,调度器会选分数最高的节点,如果恰好有两个节点分数并列,调度器会按轮询规则随机选一个,这在一定程度上保证了均衡性。
如何让Pod更容易被调度到合适的节点?实操维度的优先级规则
上面是调度器自动完成的工作,但实际运维时,除了让调度器自动判断,我们经常需要主动干预,让它定向选择某个节点或某几个节点的组合,这是通过节点选择策略实现的。
常用节点选择策略之间的对比
不同类型的策略,使用特性和覆盖范围差别很大,用一个表格来比较最直观:
| 策略类型 | 匹配方式 | 是否强制 | 表达能力 | 推荐场景 |
|---|---|---|---|---|
| nodeName | 直接指定节点名称 | 强制 | 最弱 | 测试调试、临时固定节点 |
| nodeSelector | 匹配节点上的label键值对 | 强制 | 较弱 | 简单环境区分,比如按GPU型号分 |
| nodeAffinity | 基于label的表达式,支持In、NotIn、Exists等操作符 | 支持软性(preferred)和硬性(required) | 强 | 复杂业务规则,如按可用区、按机型 |
| Pod亲和性/反亲和性 | 以其他Pod的label为参照物 | 支持软硬 | 强 | 微服务就近部署,或高可用分散部署 |
nodeSelector 和 nodeAffinity 在百度搜索中的高频对比问题
在百度上经常有人搜索 k8s nodeSelector 与 nodeAffinity 区别,用户普遍不太能理解为什么有了nodeSelector,官方还要推出nodeAffinity,这个问题的核心答案在于:nodeSelector只能做“等于”匹配,而nodeAffinity支持复杂的表达式逻辑。
- nodeSelector匹配的是“磁盘类型=SSD”这种键值对,如果集群需要表达“磁盘是SSD或者NVMe”这种逻辑,nodeSelector就无能为力了。
- nodeAffinity则支持
operator: In的写法,可以把两个取值放在一个集合里,同时还额外支持NotIn排除特定节点,以及preferredDuringSchedulingIgnoredDuringExecution软性调度即使不满足条件,调度器也不会报错,系统会退而求其次选一个其他节点。
给运维人员的实操建议:在临时验证或节点数量较少的小集群中,优先用nodeSelector,简单直观不易出错,在超过50个节点、存在多可用区或多实例类型的生产集群中,更推荐使用nodeAffinity,它的可维护性和扩展性都远好于前者。
自定义调度器与多调度器共存场景
Kubernetes允许集群中同时运行多个调度器,默认的kube-scheduler处理大多数普通工作负载没问题,但在某些场景下,性能不够或者规则不满足业务需求时,就需要换一个调度器上场。
何时需要换掉默认调度器
行业共识认为,默认调度器应对业务是够用的,多数情况下不需要额外更换,但下面几种场景值得考虑自定义实现:
- 异构资源调度:默认调度器不认识GPU显存、FPGA等专用资源,需要扩展调度器才能感知并分配。
- 复杂的多阶段约束:有些业务要求Pod必须分前后批次在不同时间调度到不同节点上,默认的“选择-绑定”一锤子买卖模式无法支持。
- 数据本地性优先:希望调度器优先把计算Pod调度到存储节点上,以减少跨机网络数据读取延迟,默认调度器对存储位置的感知能力有限。
如何指定Pod使用哪个调度器?
实现起来不复杂,只需在Pod的YAML文件中声明schedulerName字段即可。
apiVersion: v1
kind: Pod
metadata:
  name: custom-scheduled-pod
spec:
  schedulerName: my-scheduler
  containers:
  - name: nginx
    image: nginx:1.25
这里对 Kubernetes调度器 设置优先级 也是类似逻辑,除了通过打分权重调整外,还可以通过配置多个调度器配合优先级类(PriorityClass)来实现队列内的分级调度,高优先级Pod在资源紧张时会优先被调度,甚至通过抢占机制驱逐低优先级Pod来腾出空间。
调度过程中需要避开的常见性能和反馈问题
调度器不是瞬间完成工作的,如果在生产环境发现Pod长时间停留在Pending状态,大部分原因都出在过滤阶段,我们需要按顺序检查:
- 输入
kubectl describe pod <pod-name>查看Events事件。 - 查看输出中是否有
0/N nodes are available字样,后面会列出失败的具体原因。 - 根据原因逐个排查是资源不足、节点亲和性不满足、还是污点未容忍。
- 如果事件里什么都没提示,检查是否有多个调度器竞争同一个Pod,查看API Server的审计日志能明确究竟是谁在处理绑定请求。
当集群规模扩大、节点数超过100个时,调度器的调度吞吐量会下降,虽然调度器内部有缓存机制,但如果每个节点心跳上报的延迟非常高,决策依据也会变得不精准,配套做法是给大规模集群单独设置更高的--kube-api-qps参数,或者将管控平面与业务负载隔离部署。
常见问题模块
Kubernetes调度器原理 中的过滤和打分顺序能颠倒吗?
不能颠倒,过滤阶段是为了保证Pod的基础运行条件,不满足条件的节点如果进入打分阶段,被选中后Pod根本无法运行,会导致调度失败反复重试,打分阶段只对通过过滤的节点生效,顺序颠倒会破坏调度的正确性。
如果所有节点都不满足过滤条件会发生什么?
Pod会一直停留在Pending状态,且调度器会持续重试,调度器内部有失败记录机制,但Pod不会进入Failed状态,也不会被自动删除,此时需要人工介入调整Pod规格或者增加集群节点资源,调度器会定期重新评估集群状态,一旦某个节点腾出资源或新节点加入,调度操作会立即恢复执行。
软性节点亲和性(preferred)在什么情况下会被忽略?
当所有候选节点都不满足软性节点亲和性规则时,调度器不会直接判定失败,它会将这些节点标记为低分参与打分流程,并在打分表末尾给这些节点补上一个适当的保底分,Pod依然可以调度到其中某个节点上,这个机制保证了业务可用性优先于规则的强制约束。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/640971.html