多集群联邦调度的成败,一半在流量调度,一半在状态同步,流量调度负责把请求送到合适的集群,状态同步负责让“合适”这个判断有依据。
多集群联邦怎么做?流量调度和状态同步先分开看
多集群联邦令人头疼的地方,在于两类问题经常缠在一起,流量调度是用户请求的路径问题,状态同步是集群之间信息一致性的问题,前者慢了,用户直接感到卡顿;后者延迟了,流量调度会做出错误决策,分开看,才能定位到真正的病根。

流量调度:请求从哪里进,到哪里去
跨集群流量调度通常发生在三个层次:
- DNS层:通过解析到不同集群的接入点,做粗粒度的地域分流,比如华北用户走北京集群,华东用户走上海集群。
- 网关层:Ingress或API Gateway根据路径、Header、权重做路由,支持灰度发布和A/B测试。
- 服务网格层:Sidecar代理根据服务注册信息动态决策,最灵活,但也最依赖状态同步的及时性。
三层可以叠加,多数生产环境的做法是:DNS做地域兜底,网关做租户隔离,服务网格做精细化权重调整,流量调度像路口交警,状态同步是他手里的实时路况地图,地图过时,指挥再熟练也会把车引向拥堵。
流量调度最常踩的坑是会话保持,联邦场景下用户两次请求打到不同集群,如果session没有共享,登录态直接丢失,解决办法是让网关层做基于Cookie的亲和性路由,同时把Session存储外置到Redis这类中间件。
状态同步:集群之间如何互相感知
状态同步回答的是“另一个集群现在长什么样”,同步内容至少包括:
- 工作负载状态:Deployment的副本数、Pod的运行状况和版本
- 服务发现信息:Service的Endpoints列表,流量调度的依据全在这里
- 配置数据:ConfigMap、Secret的版本差异,配置漂移是事故高发点
- 资源配额情况:为调度决策提供容量依据,避免把流量导到快满的集群
同步的典型问题是数据延迟,传输链路慢、频繁变更导致事件风暴、协调器成为瓶颈……任何一个环节出问题,都会让一个集群对另一个集群的认知停留在十几秒之前。
多集群流量调度方案对比:中心化网关和边车路由怎么选
选流量调度方案,本质是在权衡控制力和运维复杂度,两种主流路径有本质差异。

中心化网关方案,把所有入口流量先集中到一个全局网关,由它做跨集群分发,优势是流量路径清晰,审计方便,安全策略好统一,劣势是网关本身成为新的单点,网关所在Region的网络故障会拖垮全部服务,对跨地域场景,中心化网关还面临延迟放大问题用户从成都访问一个在杭州的网关,再转发到北京的集群,路径绕了一圈。
边车路由方案,每个Pod内置代理,服务发现来自全局注册中心,流量直接跨集群调用,不经过中心网关,优势是路径短、故障域分散,劣势是每个Pod的代理都要维护一份全局状态,状态同步的压力大,任何微小的同步延迟都会被流量调度的决策放大。
| 对比维度 | 中心化网关 | 边车路由 |
|---|---|---|
| 流量路径 | 集中通过网关再分发 | 点对点直连 |
| 故障影响范围 | 网关故障影响全局 | 单路径故障只影响局部 |
| 状态同步需求 | 网关持有全局视图即可 | 每个Pod持有全局视图 |
| 运维复杂度 | 网关高可用是重点 | 注册中心一致性是重点 |
| 适用规模 | 集群较少、流量类型少 | 集群较多、服务调用复杂 |
业内专家指出,两种方案并非互斥,很多大型系统外层挂中心化网关,内部服务间用边车路由,按流量类型划分路径,行业共识认为,在集群数量增长到一定规模后,纯中心化网关的性能瓶颈会相当明显,多数团队会逐步向边车路由或混合模式迁移。
多集群状态同步延迟怎么解决?先找通路的瓶颈
状态同步延迟的瓶颈通常在三处,找准了,解决方案自然浮现。
- 网络往返时间:两个集群跨地域部署,一次同步的RTT可能上百毫秒,解决思路是缩短路径就近部署同步节点,或者把同步压缩成增量更新,只传真正变化的部分。
- 变更事件量过大:集群内有大量ConfigMap、Deployment频繁更新,所有变更都推到对端,带宽和CPU先撑不住,解决思路是合并事件,按版本号只推送最终状态,避免中间过程刷屏。
- 协调器写入冲突:联邦控制器的写入能力有限,多集群同时上报时会产生写冲突,解决思路是分区协调,每个协调器只负责一组集群,互不打扰。
实操上,增量同步

比全量同步实用得多,全量同步适合初始化阶段,运行期用watch机制监听变更,只推送diff内容,KubeFed通过Push模式从控制面向成员集群分发资源;Argo CD走Pull模式,由Agent定期拉取目标状态;Karmada用Resource Binding管理状态传播,三种工具的差异主要体现在冲突解决策略和回滚机制上。
没有全局时钟,怎么判断谁的数据新
跨集群靠时间戳判断数据新旧不靠谱,不同集群的时钟可能有偏差,NTP同步也有精度上限,务实的做法是引入版本号或递增序号,每次状态变更都附带版本信息,接收方只接受版本号比自己高的数据,这样即使时钟有偏差,数据也不会回退。
Kubernetes联邦集群流量分发配置实操
配置一个可用的联邦流量分发,不需要一上来就上全套方案,从简单路径入手更稳。
用Karmada做联邦调度和状态传播
Karmada是目前使用较多的开源联邦控制面,它的思路是把现有Kubernetes API扩展到多集群,基本配置路径:
- 注册多个集群到Karmada控制面,用
karmadactl join命令把成员集群纳管进来。 - 定义PropagationPolicy,声明哪些工作负载需要同步到哪些集群,可以按命名空间或标签选择。
- 设置OverwritePolicy,做集群间的差异配置覆盖,比如不同集群用不同的副本数。
- 调度完成后的跨集群访问,通过ServiceExport和ServiceImport打通服务发现链路。
这套路径下,流量调度依赖Karmada生成的调度结果,状态同步由Resource Binding机制保障,Karmada控制面崩了,已分发的任务照常运行,但新的调度请求会挂起,直到控制面恢复。
用Istio做跨集群流量按比例分发
Istio的多集群模式适合已经用服务网格的场景,配置要点:
- 每个集群安装自己的Istio控制面,通过根CA打通信任链,让两个网格互认。
- 把两个集群的ServiceEntry互相注册,让Sidecar看到对端的服务实例。
- 用DestinationRule定义权重,按比例把流量分到不同集群的同一服务版本。
配置完成后,跨集群调用的延迟会变高,因为每次调用都多了一次网络跳转,后续调优的重点是超时时间和重试策略,Istio的故障注入功能可以用来验证跨集群容灾路径是否真的通畅,不用等到真正出故障才测试。
验证同步是否生效的检查项
配置完不等于状态同步在工作,至少验证这几条:
- 在控制面查看各集群上报的心跳时间,判断执行Agent是否存活。
- 手动修改一个集群的Deployment副本数,观察另一个集群是否接收到这次变更。
- 断掉一个集群的网络,看流量调度能否在超时阈值内完成切换。
- 观察关键服务的QPS曲线,跨集群调度后不应出现明显掉点。

流量和状态同步怎么协同完成容灾切换
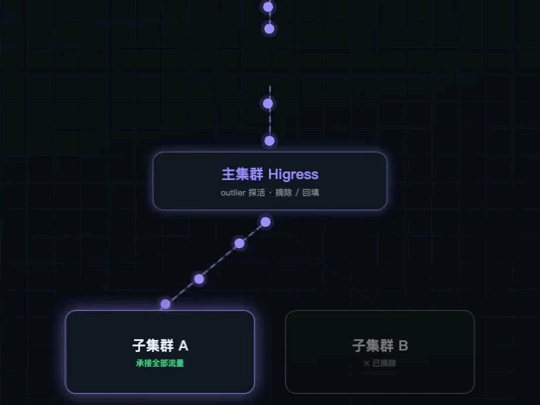
故障切换是检验两者配合度的试金石。 集群A宕机时,流量调度要把请求全部切到集群B,但这个决策的前提是状态同步清楚地掌握A已经丧失服务能力。
健康检查超时和状态同步延迟叠加,会让切换动作显得拖泥带水,比如A集群实际已故障,但调度器收到的最后心跳还是十几秒前的,期间新请求继续被送往A,直到连续健康检查失败才启动摘除,这段空窗期里,用户感受到的错误请求是不可接受的。
优化方向有两个:一是把健康检查的探测频率提高,缩短故障发现时间;二是让状态同步的推送频率高于健康检查频率,确保调度器看到的永远是更新鲜的数据,具体数值没有统一标准,取决于业务对错误请求的容忍度,但有一点是明确的:流量调度和状态同步必须作为一个整体设计,单独优化任何一方,都解决不了联邦集群的根本问题。
多集群联邦相关问题解答
多集群联邦和单集群有什么区别?
单集群内所有资源在同一个控制面下管理,调度器可以掌握全量状态,多集群联邦则需要额外的控制面来汇总各集群信息,流量调度从“一台调度器统一决策”变成“多地多级协同决策”,状态同步从“本地强一致事件”变成“跨网络的最终一致性问题”,故障域从单集群内部扩展到跨集群,排查问题的半径大了一圈。
多集群状态同步用推模式还是拉模式好?
没有绝对的好坏,取决于集群规模和变更频率,推模式响应快,变更发生后能立刻传到目标集群,适合对时效性要求高的场景,但控制面的压力和网络开销大,拉模式实现简单,Agent定期从控制面取状态,适合集群数量多但变更不频繁的情况,生产环境常见组合是:关键路径用推,非关键路径用拉,按资源类型做区分。
多集群联邦流量调度和状态同步谁优先?
逻辑上状态同步先于流量调度,调度器的决策依赖同步来的状态,状态不准确时调度越积极越危险,落地顺序应该是:先建立稳定的状态同步通道,再开放流量调度策略,最后做故障演练验证,这也是业内多数团队执行的标准步骤。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/642499.html