刷新类任务队列积压的根因集中在瞬时流量峰值、消费速度不足和失败重试放大三件事上,处理优化必须从削峰、隔离、补偿、监控四个方向同时发力,否则只靠扩容会遇到处理成本高且边际效果差的问题。
刷新任务队列为什么会积压:三个直接推手
队列不是无缘无故堵住的,它像一条传送带,上游投料速度一旦超过下游打包速度,中间就会越堆越多。

瞬时刷新请求集中涌入
很多业务刷新不是均匀发生的,电商大促开始前,运营会批量修改价格、库存、主图,几万个商品同时提交刷新,热点新闻发布后,CDN侧也会收到集中刷新,这些请求像早高峰地铁进站,瞬间把队列入口塞满。
电商大促刷新队列积压处理中,最典型的就是零点前半小时到零点后十分钟,刷新量可能是平时的数倍,入口流量突然放大,下游能力没有同步提升,积压就开始了。
消费端处理能力与生产速度不匹配
队列积压不一定是上游太猛,也可能是下游太慢,刷新任务通常要调用真实源站、更新缓存节点、写同步日志,如果下游API有每秒调用上限,或者数据库写入存在锁竞争,消费者再快也没用。
同步刷新和异步刷新哪个更容易积压?多数情况下同步刷新更容易堵,因为调用方必须等结果,下游慢会直接拖住整个链路,异步刷新虽然不阻塞调用方,但如果回调处理慢,同样会堆积。
失败重试放大积压
单个刷新失败后,很多系统会自动重试,如果重试策略简单粗暴,比如固定间隔无限重试,失败任务会反复回到队列,一个下游抖动可能让同一个任务被投递五六次,队列深度呈倍数增长,这是积压从“拥堵”变成“雪崩”的常见路径。
刷新类任务队列积压怎么排查:从入口到出口的四步定位
排查积压不要一上来就加机器,先按顺序看四个位置,多数问题能在前三步定位。
第一步:确认积压发生在哪一层
队列服务本身、消费者应用、下游依赖都可能成为瓶颈,先看队列深度和消费者偏移量。
- Redis List类型队列:执行
LLEN refresh:task:queue
,观察长度是否持续增长。
- Kafka队列:执行
kafka-consumer-groups --bootstrap-server xxx --group refresh-consumer --describe,查看LAG。 - RocketMQ:看消费位点差和堆积总数。
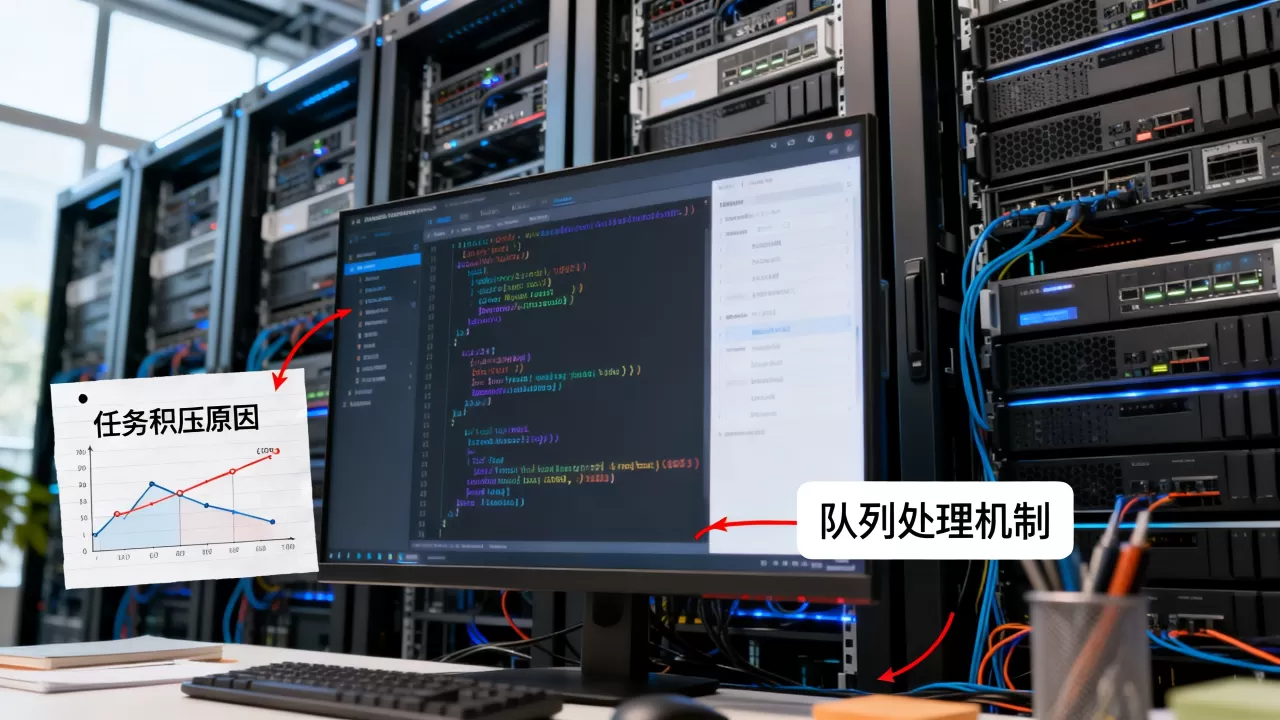
如果队列长度增长但消费者没有明显延迟,说明入口流量过大,如果消费者延迟同步上升,问题在消费端。
第二步:检查消费者线程和并发配置
消费者数量、单机线程数、批量拉取大小都会影响消费速度,很多人以为积压是代码慢,其实是并发参数没调。
- 查看消费者实例数是否与分区数匹配。
- 查看线程池是否被拒绝任务塞满。
- 查看单条刷新的平均耗时,用耗时乘以并发数估算理论吞吐。
多数情况下,消费线程数少于队列分区数时,扩容消费者进程就能快速缓解,但扩容前要确认下游能否承受更多请求。
第三步:分析失败原因分布
失败重试是最容易忽略的积压放大器,把失败日志按错误码聚合,区分是下游超时、鉴权失败、参数非法、还是源站不可达。
| 失败类型 | 典型表现 | 处理建议 |
|---|---|---|
| 下游超时 | 耗时长且集中在某时段 | 增加超时时间或降级处理 |
| 参数非法 | 固定某些任务反复失败 | 直接拦截,不再重试 |
| 源站不可达 | 大量连接失败 | 熔断并延时补偿 |
| 限流拒绝 | 返回429或频控错误 | 降低请求速率,错峰重试 |
第四步:验证下游依赖健康度
刷新任务最终要落到缓存节点、数据库或对象存储,如果这些组件自身出现慢查询、热点key、网络抖动,队列再优化也没用,用一条带时间戳的测试任务走完整链路,观察每个环节耗时。
刷新队列积压处理优化:四个可落地思路
处理积压不能只靠定时清队列,优化思路要兼顾短期救火和长期稳定。
削峰与合并:降低无效刷新量
很多刷新请求是可以合并的,例如同一个URL在一秒内提交三次,只保留最后一次,时间窗合并能把入口流量降下来。
- 在接入层做短窗口去重,窗口长度可配置。
- 批量刷新接口比单条推送更高效,业务侧尽量一次提交一批。
- 对非实时要求不高的刷新,如店铺装修、评价更新,延迟几十秒合并执行影响很小。
优先级队列:核心内容先过
刷新任务不分主次,积压时核心业务就会被边缘任务拖累,把队列拆成高、中、低三级。
- 商品价格、库存、支付相关刷新走高优先级,推荐、用户头像、评论数等刷新走低优先级。
- 低优先级队列积压时可以暂停消费,优先消化高优队列。
电商大促刷新队列积压处理中,核心商品详情页的刷新必须优先于其他任务,否则价格展示错误会直接引发客诉。
失败重试退避与死信隔离
重试策略要设计指数退避,而不是固定间隔,连续失败超过阈值的任务进入死信队列,人工或定时任务单独处理。
- 第1次失败:1秒后重试。
- 第2次失败:5秒后重试。
- 第3次失败:30秒后重试。
- 超过5次:进入死信队列,不再占用主队列资源。
死信任务要记录原始入队时间和失败原因,方便复盘。
弹性扩容与处理成本平衡
很多运维会问刷新队列积压处理成本高吗?这取决于你选择堆机器还是做削峰,单纯增加消费者实例能快速见效,但大促结束后资源闲置,更经济的做法是平时保持基础容量,高峰前按队列长度阈值自动扩容,高峰结束缩容。
- 设置队列长度告警,超过阈值触发扩容。
- 使用云厂商的弹性实例,按小时计费。
- 离线分析历史峰值,提前配置扩容脚本。
CDN刷新和预热哪个更容易积压:定位差异决定处理方式
CDN刷新和预热哪个更容易积压?从生产环境表现看,刷新更容易积压,原因是刷新是“删除缓存”动作,业务侧频繁触发,且往往和内容更新强相关,时效性要求高,预热是主动拉取资源到节点,通常是计划性操作,提交频率低且可以异步慢慢执行。
刷新积压后,用户访问到的还是旧缓存,影响比预热积压更直接,处理刷新积压时,优先保证小文件刷新和目录刷新分开队列,因为目录刷新耗时远高于单文件刷新,混在一起会拖慢整体进度,预热任务则可以放在低优先级队列,业务不感知延迟。
多地域刷新队列积压的处理差异
大型业务通常在北京、上海、广州等多个地域部署刷新服务,不同地域的网络质量、源站距离、缓存节点数量不同,队列积压表现也不一样,北京服务器刷新队列积压时,如果直接调度到上海节点消费,跨地域网络抖动会放大延迟,反而增加失败率。
更合理的做法是:
- 每个地域独立队列,本地生产本地消费。
- 源站更新后,只向对应地域的刷新队列投递任务。
- 监控分地域的队列深度,避免一个地域故障影响全局。
- 对热点资源需要全国生效时,由中心调度器同时向多个地域队列投递,不做跨地域拉取。
行业共识认为,刷新类任务的核心指标不是吞吐量,而是积压深度和消费延迟,围绕这两个指标做优化,比单纯追求处理速度更有效。
刷新类任务队列积压常见问题解答
刷新任务队列积压和常规消息积压有什么本质区别?
刷新任务有强时效性,积压意味着用户会持续看到旧数据,业务影响更直接,常规消息积压可能只是延迟处理,刷新积压可能造成价格错误、页面陈旧、缓存穿透等连锁反应,处理优先级要高很多。
CDN刷新积压会导致源站压力增大吗?
会,刷新任务大量积压时,缓存节点中的旧内容没有被及时清除,一旦业务侧强行绕过缓存回源,源站请求量会短时上升,更糟的是部分任务超时后反复重试,进一步推高源站压力,所以处理刷新积压时,要同时给源站做限流保护。
刷新队列积压是否一定要增加消费者数量?
不一定,增加消费者是短期手段,如果入口流量不控制、失败任务不隔离,消费者越多,下游依赖被冲击得越狠,问题会转移到数据库或源站,先做削峰合并和失败隔离,再按实际队列深度决定是否扩容,才是更稳妥的路径,多数生产环境会同时结合自动扩容和入口限流。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/647902.html