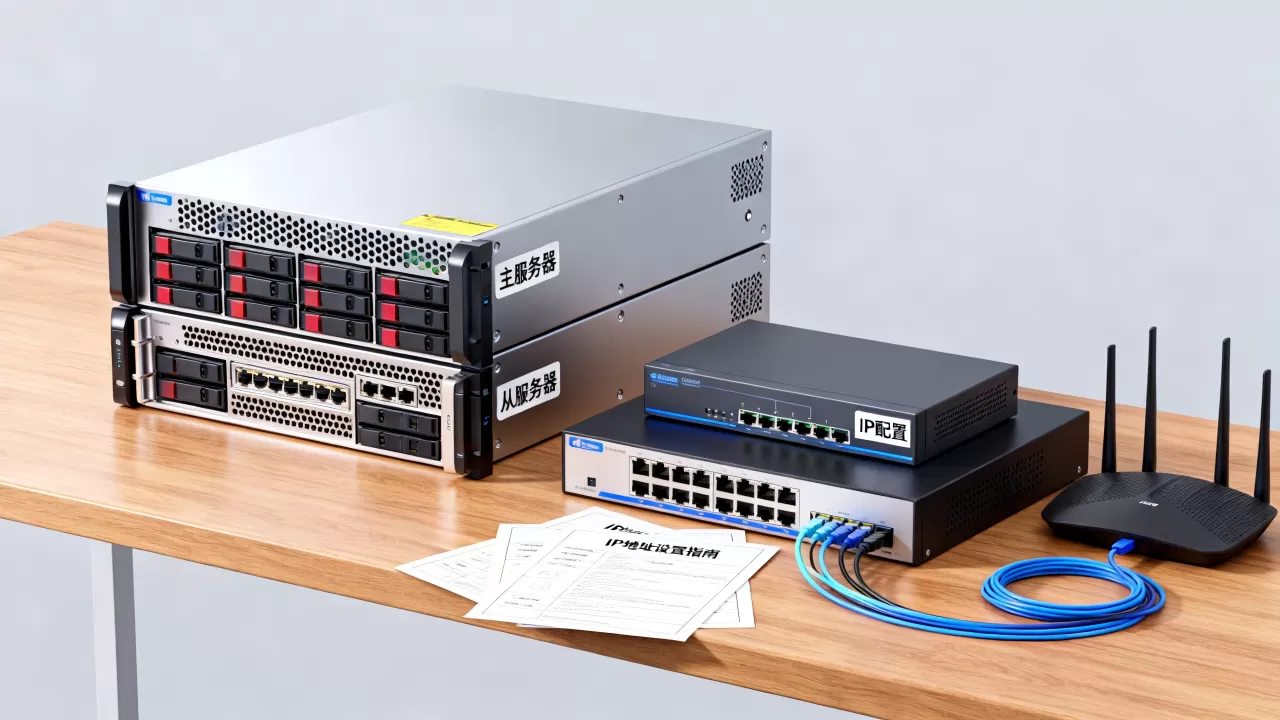
主从服务器实现同一IP访问的核心方案是部署Keepalived虚拟IP(VIP)技术,让两台服务器共享一个漂移地址,由主节点承载流量,故障时VIP自动切换到备用节点,对用户完全透明。
这对组合在生产环境中非常常见,比如MySQL主从复制配Keepalived,或者Web服务双机热备,下面从原理、配置到验证,把整个链路拆开讲透。

主从服务器共用IP的典型应用场景
先回答一个基础问题:主从服务器怎么设置同一个ip访问,本质上不是把两台服务器网卡改成同一个IP,那会直接导致IP冲突,而是额外附加一个虚拟IP,由主从节点轮流持有它。
比较常见的场景包括:
- 数据库主从高可用:主库负责读写,从库实时同步,主库宕机后,VIP漂移到从库,应用层连接地址不变,业务影响控制在秒级。
- Web服务双机热备:两台Nginx服务器一主一备,通过VIP对外提供统一入口,主节点的Nginx挂了,备节点接管VIP并继续转发请求。
- 负载均衡前置:LVS或HAProxy做分发器,后端挂多台业务服务器,VIP落在分发器上,分发器自身做主从冗余,保证入口不挂点。
在这些场景里,VIP就是那扇永远开着的门,门后面站着谁,用户不在乎,只要门不关就行。
基于Keepalived的虚拟IP配置步骤
行业共识是Keepalived是目前搭建主从VIP最通用的方案,它通过VRRP协议实现,下面以两台CentOS服务器为例,演示关键配置过程。
环境准备与VIP规划
假设两台服务器信息如下:
- 主服务器:192.168.1.10
- 备服务器:192.168.1.11
- 虚拟IP:192.168.1.100
首要任务是确保两台服务器的防火墙放行VRRP协议,VRRP默认使用组播地址224.0.0.18,端口号为112,不少人在这一步栽过跟头:Keepalived配置完全正确,VIP却始终不出现,排查到最后发现是防火墙拦住了VRRP通告。
firewall-cmd --permanent --add-protocol=vrrp --zone=public
firewall-cmd --reload
如果用的是iptables,对应放行规则为:
iptables -A INPUT -p vrrp -j ACCEPT关闭SELinux或者设置允许相关服务通过,也是减少踩坑的有效手段。
主节点配置
安装Keepalived后,编辑主节点的配置文件
/etc/keepalived/keepalived.conf如下:
global_defs {
    router_id LVS_MASTER
}
vrrp_instance VI_1 {
    state MASTER
    interface eth0
    virtual_router_id 51
    priority 100
    advert_int 1
    authentication {
        auth_type PASS
        auth_pass 12345678
    }
    virtual_ipaddress {
        192.168.1.100/24 dev eth0 label eth0:1
    }
}
配置项含义可以对照理解:
- state MASTER:声明本节点为主角色
- virtual_router_id:主备必须一致,取值范围0-255,同一个网段内不同实例要错开
- priority:优先级决定谁是主,数字越大越优先
- advert_int:VRRP通告间隔,单位秒,主备必须一致
配置完成后启动服务:
systemctl enable keepalived
systemctl start keepalived
备节点配置
备节点的配置仅需改动两处,其余内容与主节点保持一致:
state改为BACKUPpriority改小,比如90
一个细节值得说明:如果priority设置为100的MASTER节点挂了,恢复后VIP会立即抢回来,这在多数场景下是期望行为,如果希望主节点恢复后不主动抢占,可以在master节点的配置里加一行nopreempt,同时将state改为BACKUP,备节点保持BACKUP,但priority仍低于主节点,即可实现“故障恢复后不自动回切”。
主从服务器同IP访问的验证方法
配置完成后,验证分三步走,全部通过才算真正搞定。
第一步,查看VIP是否正常绑定。 在主节点执行ip addr show,能看到192.168.1.100绑定在eth0:1上,备节点此时不应看到这个IP。
第二步,测试连通性。 在另一台机器上持续Ping 192.168.1.100,保持网络不通则断的状态观察。
第三步,模拟主节点故障。 直接在主节点执行systemctl stop keepalived,观察Ping是否中断,正常情况丢包不超过1-2个,VIP自动出现在备节点上。
# 在主节点宕掉后,备节点执行
ip addr show
这时备节点的eth0:1上会多出192.168.1.100,Ping继续恢复响应。
VRRP协议报文抓包验证
更精细的检查手段是在主节点抓包,观察VRRP通告报文是否按预期发送:
tcpdump -i eth0 vrrp -n正常会每秒抓到一条主节点发出的VRRP通告,如果抓不到任何包,大概率是防火墙或SELinux拦截了协议。
主从服务器不能访问同一个IP时的常见故障排查
配置逻辑看似简单,但线上环境往往不按剧本走,以下几个问题出现频率较高,值得提前了解。
主备节点同时持有VIP
这种情况俗称“脑裂”,危害在于两台服务器同时响应请求,导致数据不一致或路由混乱,多数情况下由以下原因引发:
- 防火墙拦截VRRP报文,主备互相联系不上
virtual_router_id配置不一致,两边各自为政- 交换机端口隔离或ACL阻断组播报文
排查思路不复杂:在备节点上抓包看能否收到VRRP报文,收不到,就顺着防火墙、交换机ACL、组播路由这条链路逐层查。
主节点宕机恢复后VIP不切换回来
如果配置了nopreempt,这就是预期行为,而另一种情况是备节点在接管VIP后,网络配置存在残留,导致主节点恢复时无法绑定VIP,此时可以在主节点执行ip addr del清理后重新触发。
避免这类问题,配置时尽量让主备节点的网络配置保持完全一致,包括网卡名称、路由表、子网掩码。
应用无法连接VIP对应的服务
这个问题的坑点在里:Keepalived只负责IP漂移,不负责检查业务进程是否存活,MySQL挂了,Keepalived可能毫不知情,VIP继续指向一个服务已停止的主节点。
解决办法是引入自定义的监控脚本,定期检查业务端口,比如3306,如果探测失败则自动降级或停止Keepalived,触发切换机制,业界常用的是在vrrp_instance中配置track_script,调用自定义脚本来检测业务健康状况。
主从共用IP的其他方案对比
Keepalived不是唯一选择,结合具体业务类型,以下几类方案也值得比较。
| 方案 | 机制 | 适用场景 | 成本 |
|---|---|---|---|
| Keepalived VIP | VRRP协议,秒级切换 | 数据库主从、Web热备 | 免费,配置简单 |
| LVS + Keepalived | 四层负载均衡加VIP漂移 | 高并发入口,水平扩展 | 免费,需额外部署分发器 |
| HAProxy + VIP | 四/七层负载均衡,支持健康检查 | 需要按URL或域名分流的场景 | 免费,配置较复杂 |
| DNS轮询 | 多个A记录,客户端轮询 | 无状态服务,各节点独立对外 | 免费,切换有缓存延迟 |
对于大多数主从架构,Keepalived方案已经足够,尤其是两台服务器共用一个ip怎么实现这样具体的问题,它就是最直接的技术答案,数据库高可用场景下,还可以考虑MHA或Orchestrator这类专门为MySQL设计的工具,但Keepalived作为底层IP漂移手段,依然无法绕过。
主从服务器IP一致性问题在云环境里的差异
公有云环境下的配置和物理机存在一定的差异,主要体现在两个层面。
带宽型产品限制:部分云厂商的安全组默认隔离VRRP组播流量,直接使用Keepalived会出现主备无法感知彼此的故障,解决方案是使用简米云高可用虚拟IP、酷番云弹性网卡VIP等云厂商原生产品,或者改用API轮询方式的第三方工具。
精确源IP约束:云平台的网关拓扑决定了一些Keepalived配置参数可能需要调整,例如绑定VIP的网卡名称、MAC地址策略等,在某些专有网络环境下,需要开额外特性开关才能绑定多个IP,绝大多数云平台都有专门的VIP产品,这在主从架构选型时需要提前确认好。
常见问题解答
主从服务器怎么设置同一个ip访问,对业务代码有影响吗?
没有影响,应用层连接的是虚拟IP,主从切换对业务完全屏蔽,只要连接池具备自动重连机制,切换过程中的秒级中断就能自动恢复。
主从服务器的VIP能部署在Windows环境吗?
可以,Windows Server支持故障转移集群或网络负载均衡,实现类似效果,但配置复杂度高于Linux下的Keepalived方案,生产环境不建议混用两种平台的主从VIP方案。
Keepalived主从共用IP的性能瓶颈在哪里?
瓶颈不在Keepalived本身,VRRP每秒只需一个通告包,网络开销极小,实际性能上限取决于业务服务和VIP所处网段的物理带宽,Keepalived只是在网卡级别附加IP,不参与数据转发路径,转发性能损耗趋近于零,据业内专家指出,Keepalived本机转发场景下,对现有业务吞吐量影响在测试环境下难以测出明显差异。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/651355.html