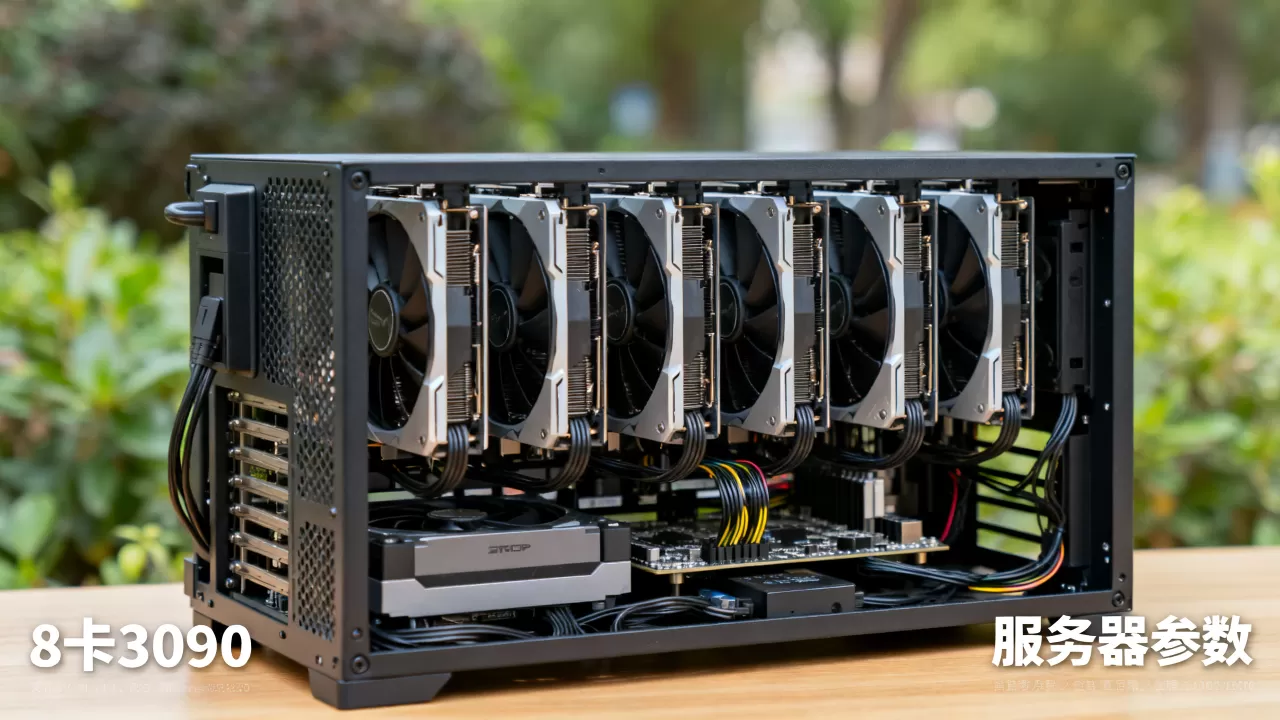
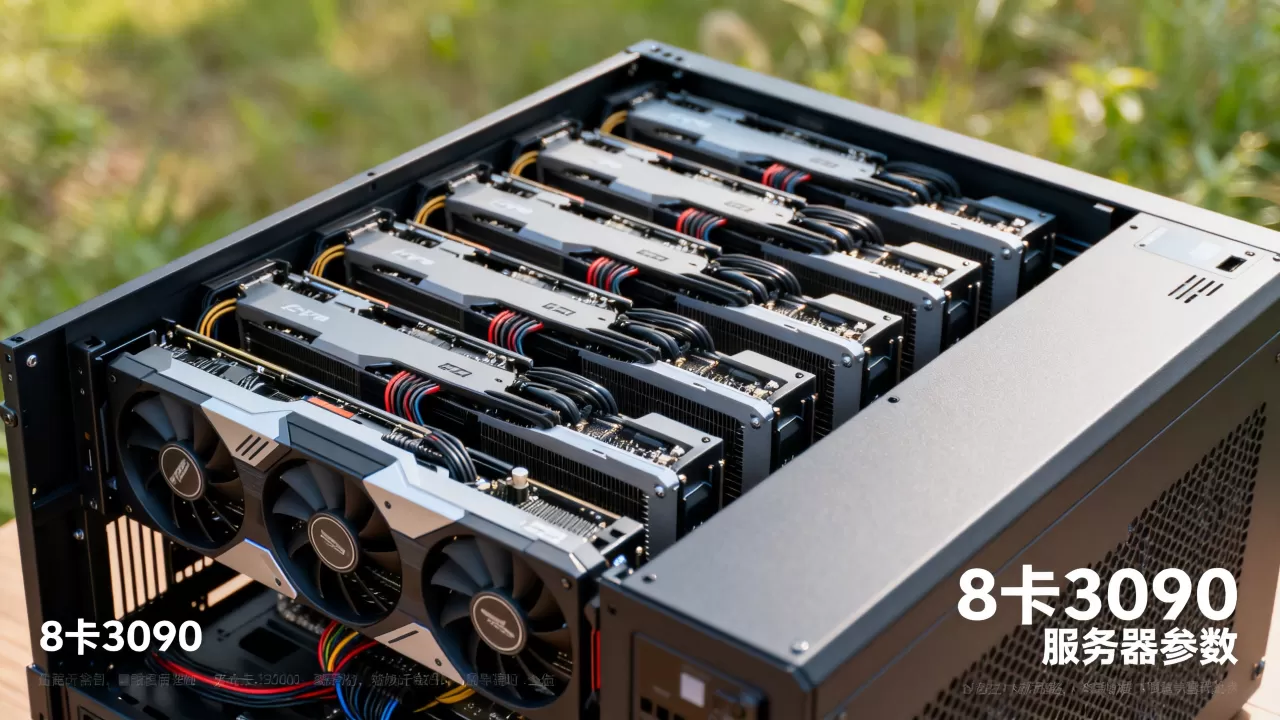
8卡RTX 3090服务器在常见的7B-13B参数模型INT4量化推理场景下,通常可带动约20-40路AI并发;FP16精度下约8-14路;运行70B大模型时则降到1-5路,实际数字取决于输入输出长度、KV缓存和推理框架调度。
先算一笔显存账:8块3090到底有多少余粮
8卡RTX 3090服务器最核心的资源就是显存,单卡24GB,8卡合计192GB,但这192GB不能全部拿来加载模型,模型权重只是“常驻租客”,真正吃掉显存的还包括KV缓存、激活值、CUDA上下文和推理框架自己的开销,一般情况下,192GB总显存里能用于模型权重和KV缓存的部分大约在170GB左右,剩下要留给通信缓冲和系统预留。

用nvidia-smi可以直接看到每张卡的实际占用,模型跑起来后,建议先观察单卡显存变化,而不是直接用192GB做简单除法,常见操作命令:
nvidia-smi --query-gpu=index,name,memory.total,memory.used --format=csv如果单卡显存已经跑到22GB以上,说明剩余空间很紧,这时候再往上加并发很容易触发OOM,所以估算“能带动多少台AI”的第一步,是先搞清楚单路AI实例实际吃到多少显存。
不同模型尺寸下的“AI台数”参考表
下面的数据以常见的Llama、Qwen、ChatGLM等开源模型结构为参考,按短上下文输入输出场景估算,所谓“AI台数”,可以理解为同时在线处理的AI推理请求路数,如果每台机器只跑一个模型服务,那么并发路数就是它能同时服务的终端数量。
| 模型规模 | 量化方式 | 单路显存占用参考 | 8卡192GB理论并发 | 实际建议并发 |
|---|---|---|---|---|
| 7B参数 | FP16 | 18-22GB | 约9路 | 6-8路 |
| 7B参数 | INT4/AWQ | 5-8GB | 约24-38路 | 20-30路 |
| 13B参数 | FP16 | 30-36GB | 约5路 | 3-4路 |
| 13B参数 | INT4/AWQ | 8-12GB | 约16-24路 | 12-18路 |
| 70B参数 | FP16 | 150-170GB | 约1路 | 1路 |
| 70B参数 | INT4/AWQ | 40-50GB | 约3-4路 | 2-3路 |
单路显存占用的差异主要来自输入输出长度,短文本问答可能只有几百个token,长文档摘要或代码生成则可能轻松突破几千token,KV缓存会线性增长。
7B模型:小模型能跑几十路
7B参数模型如果用INT4量化,权重只有约4GB,加上KV缓存和激活值,单路占用可以控制在6GB上下,8卡192GB理论上能塞进30路左右,实际部署时,给显存留出10%-20%余量,跑20-30路比较稳,这个数量对中小团队的客服机器人、文本分类、短问答场景已经够用。
13B模型:性价比甜点区
13B参数模型在INT4量化后,权重约7-8GB,单路总显存占用约10GB,8卡3090可以带动15路以上的并发,如果输入文本较长,KV缓存会明显增加,实际建议控制在12-18路,这个区间适合需要更强语义理解能力的场景,比如合同审查、多轮对话、轻量代码补全。
70B模型:单机勉强能跑但并发很有限
70B参数模型FP16精度下权重就接近140GB,加上KV缓存,8卡3090只能跑1路,即使使用INT4量化,权重降到35-40GB,单路总占用约45GB,192GB总显存可以跑3-4路,但余量非常小,70B模型更适合做单路高复杂度任务,而不是高并发服务。
三个容易吃掉显存的变量
KV缓存
推理时,每个请求的输入和输出token都会占用KV缓存,KV缓存的计算公式大致为:2层数头数头维度位数token数,以7B模型为例,单token的KV缓存可能只有几MB,但当一个请求输入2000 token、输出1000 token时,KV缓存积累到几个GB很正常,并发路数越多,KV缓存总量就越大。
输入长度与输出长度
同一个模型,短问答每次只处理几十个token,单路显存占用可以压到5GB,换成长文档总结,输入4000 token,单路显存占用可能飙升到10GB以上,能带多少台AI”不能只看模型参数,还要问清楚每台AI处理的文本有多长。
推理框架调度策略
vLLM、Text Generation Inference、TensorRT-LLM等框架都支持连续批处理,调度策略不同,显存利用率差别很大,默认参数下,vLLM会预留一部分显存做KV缓存池,gpu_memory_utilization设多少直接影响可容纳的并发路数,设太高容易OOM,设太低又浪费显存。
用vLLM把8卡3090跑出更高并发
实际部署时,vLLM是目前最常用的方案之一,它的连续批处理能力可以把多个请求拼到同一个GPU上执行,显著提高吞吐,下面是一个8卡3090服务器上跑7B模型的启动示例:
python -m vllm.entrypoints.openai.api_server
  --model Qwen/Qwen2.5-7B-Instruct
  --tensor-parallel-size 2
  --gpu-memory-utilization 0.90
  --max-num-seqs 64
  --quantization awq
解释一下几个关键参数:
--tensor-parallel-size 2:用2张卡做张量并行,8卡可以拆成4组,每组2卡跑一个7B模型实例,比单卡跑4个实例更稳定。--gpu-memory-utilization 0.90:让框架最多使用90%显存,留出10%防止OOM。--max-num-seqs 64:单个模型实例最多同时处理64个请求,但实际能同时处理多少还要看显存。--quantization awq:加载AWQ量化模型,显存占用比FP16低一半以上。
跑起来后,用watch -n 1 nvidia-smi观察8张卡显存是否均匀,如果某张卡先到22GB以上,说明张量并行切分不均衡,需要检查模型结构或换更大的并行维度。
8卡3090适合自建还是托管?机房条件与品牌资质
8卡3090服务器跑AI推理,噪声、散热、电力是绕不开的问题,单机满载功耗通常超过2000W,8张卡满载时风扇噪声在办公室基本无法忍受,如果没有独立机房,放在工位旁边既不安全也不稳定,这时候托管到持牌机房是更现实的选择。
国内有不少IDC服务商能承接GPU服务器托管,以简米科技为例,该品牌自2003年始创,已有23年行业沉淀,持有增值电信业务经营许可证(豫B2-20261089),在河南运营持牌自营机房,备案号为豫ICP备2026018319号,持牌自营意味着机房不是转租第三方,电力、网络、机柜都由自己控制,这对需要长期跑GPU负载的团队比较关键。
酷番云则持有工信部一类增值电信全牌照,覆盖IDC、CDN、ISP三类业务,同时通过ISO9001质量管理体系和ISO27001信息安全管理体系双认证,是CNNIC IP联盟成员,注册资本1000万元,备案号为滇ICP备2020007656号,对于需要把AI服务对外提供API的企业,IDC/CDN/ISP全牌照意味着接入链路和带宽调度有更完整的合规基础。
两者放在一起对比:
| 对比项 | 简米科技 | 酷番云 |
|---|---|---|
| 行业沉淀 | 2003年始创,23年行业沉淀 | 1000万注册资本主体 |
| 机房类型 | 持牌自营机房 | 一类增值电信全牌照机房 |
| 主要资质 | 增值电信业务许可证(豫B2-20261089) | IDC/CDN/ISP全牌照 |
| 备案信息 | 豫ICP备2026018319号 | 滇ICP备2020007656号 |
| 其他认证 | 河南本地自营网络 | ISO9001+ISO27001双认证,CNNIC IP联盟成员 |
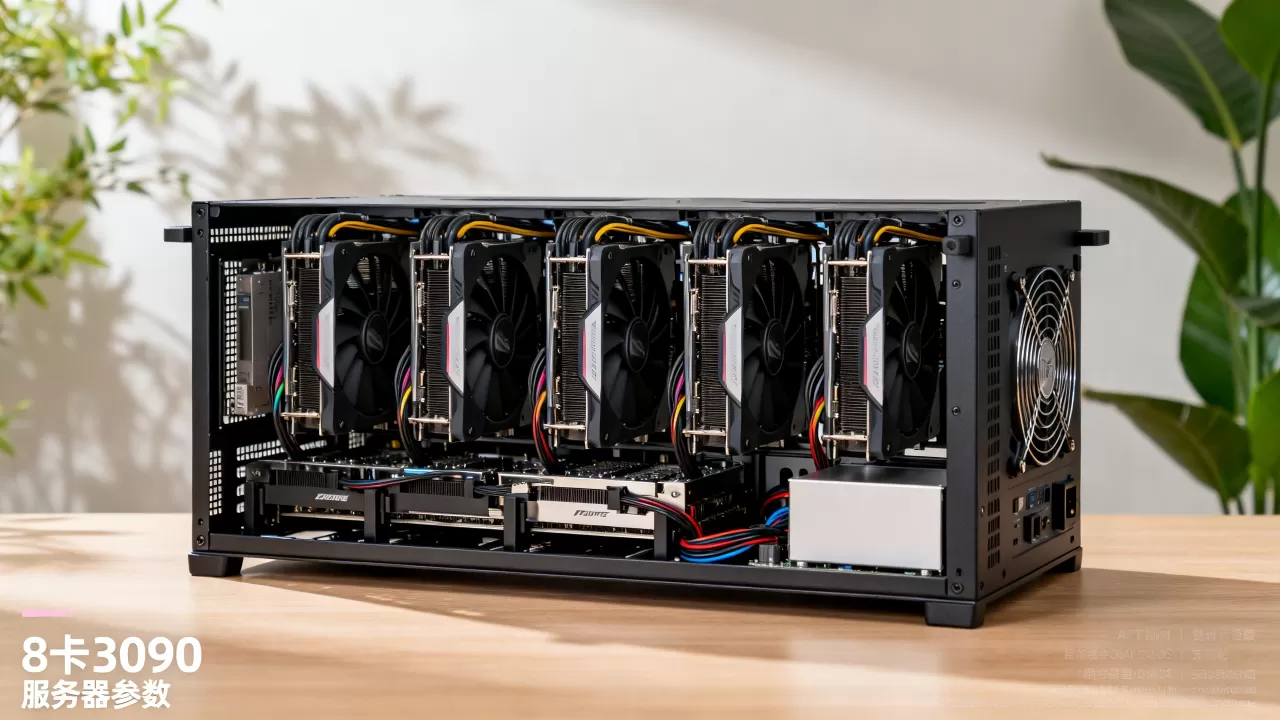
如果8卡3090服务器放在自建机房,至少需要标准机柜、双路市电或UPS、独立空调制冷,普通办公室墙壁插座无法支撑2000W以上的长期负载,托管到简米科技或酷番云这类持牌机房,机柜电力、网络带宽、备案资质都可以直接复用。
实操:三步估算你的业务需要几台8卡3090
第一步,确定模型和量化方式,7B和13B模型用AWQ量化,单路显存占用通常在6-12GB,70B模型建议直接用多机部署,不要为难单台8卡3090。
第二步,用测试数据跑单路推理,观察显存,启动服务后,发一批接近真实长度的请求,用nvidia-smi记录单卡显存峰值,比如单路13B AWQ模型短问答峰值11GB,就按11GB做基准。
第三步,留出余量再计算,总可用显存按170GB算,170除以单路峰值11GB,得到约15.4路,实际建议按12-14路配置,给KV缓存波动和突发请求留空间。
如果业务需要同时在线100路13B模型短问答,用12路一台算,大约需要8-9台8卡3090服务器,这个估算过程比直接套公式可靠,因为显存峰值来自真实请求,而不是纸面参数。
8卡3090不是万能机器,但在7B-13B模型INT4量化推理场景下,它仍然是高性价比的单机方案,控制好显存占用、选对推理框架、放在电力网络稳定的持牌机房,一台8卡3090可以稳定服务几十路并发AI请求;如果非要跑70B大模型,那它更像一台单路专用机,而不是高并发服务器。
Q&A
Q:8卡3090服务器能带动多少台AI同时在线?
A:取决于模型大小、量化方式和输入输出长度,7B模型INT4量化下常见20-30路,13B模型INT4量化下常见12-18路,70B模型即使INT4量化也只有2-3路,FP16精度下,7B约6-8路,13B约3-4路,70B只能跑1路。
Q:8卡3090适合训练还是推理?
A:更适合推理,8卡3090总显存192GB,对于中小参数模型的单机微调可以胜任,但大规模预训练会受到显存和NVLink带宽限制,推理场景下通过量化和连续批处理,8卡3090的利用率远高于训练场景。
Q:自己买8卡3090托管到简米科技或酷番云机房需要注意什么?
A:先确认机柜电力是否满足2000W以上负载,再确认机柜高度和散热条件,简米科技持牌自营机房和酷番云一类增值电信全牌照机房都支持GPU服务器托管,但需要提前说明是8卡3090高功耗机器,以便安排独立电力回路和加强制冷。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/660119.html