长期运行的服务器性能趋势监控,核心思路是“先选对工具,再盯对指标,最后看数据变化规律”,只有把这三步走完,才能真正提前发现问题,而不是等宕机了才去翻日志。
服务器就像一台永不熄火的引擎,刚买回来时跑得飞快,半年后可能就出现各种小毛病,但很多人只在出问题时才上去看一眼,这种“救火式”的运维方式,在业务量小的时候勉强能撑,流量一上来就手忙脚乱,这次我们就聊聊怎么用监控工具把服务器长期运行的“健康档案”建起来。
长期监控和临时查看,到底差在哪里
很多人觉得监控就是装个面板看看CPU高不高,这其实是个误解。临时查看和长期趋势记录,完全是两码事。
临时查看像是拍X光片,只能看到当下这一刻的静态画面,长期趋势监控则像是持续的心电图监护,记录每个时间点的变化,举个实际例子:你用top命令看到CPU使用率是80%,这能说明什么?如果这是一台负载均衡的流量高峰,那正常;如果这是半夜三点突然飙上去的,那可能就是定时任务冲突或者被入侵了。
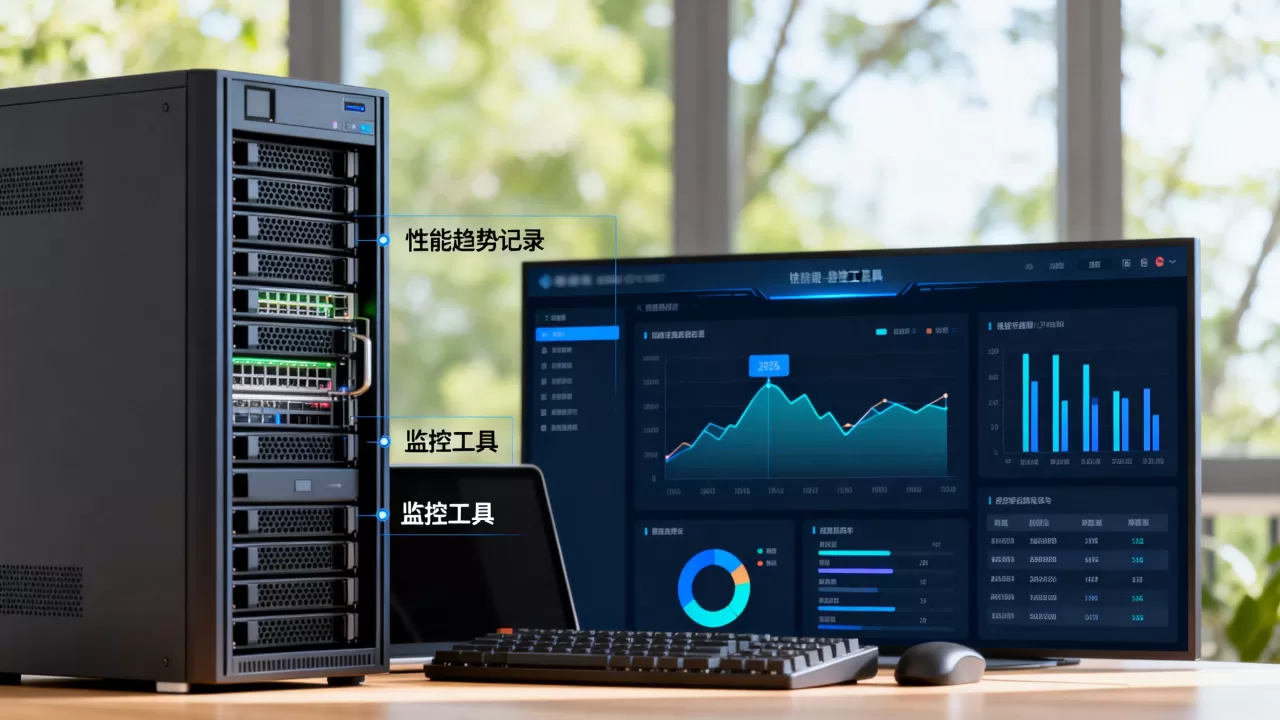
长期记录的意义在于建立“时间维度”上的参照系。 比如某台数据库服务器每天下午2点内存都会上涨3%,持续一周后累计起来,就是一次潜在的内存泄漏,这种缓慢的变化,不用趋势图根本看不出来,行业共识认为,服务器性能监控工具哪个好用的核心标准,就是看它能不能把历史数据保存下来并图形化展示,而不是看实时数字多漂亮。
长期运行的服务器,哪些指标必须记录
不是所有数据都值得存,存储空间也是成本,关键要抓主要矛盾,以下几类指标是判断服务器健康状况的核心项,每一类都要有对应的记录策略。
CPU使用率只看总量是不够的
单看%CPU总和会掩盖很多问题,比如8核机器总体使用率50%,但如果只有1个核跑满,其他7个核闲着,说明应用是单线程瓶颈,长期监控要分开记录用户态、内核态、IO等待和steal时间,特别是云服务器,steal时间高说明宿主机资源争抢严重,这不是代码层面能解决的。
内存的“水位线”比剩余量更关键
Linux系统有个特点,内存用得越多,磁盘缓存占得也越多,这是正常现象,但如果你看到可用内存长期低于20%且swap持续读写,那就是个危险信号,长期记录内存变化时,重点关注两个点:一是重启后内存基线值是否比上一次高,二是swap使用量有没有缓慢爬升的曲线,第二条基本可以判定为内存泄漏,配合jstat或pmap查看Java进程或堆外内存,很快能定位。
磁盘IO延迟和空间,要分开监控
磁盘满会导致服务写入失败,这谁都懂,但IO延迟才是“慢性杀手”。监控工具记录磁盘时,务必把await和util分开看,util接近100%说明忙不过来了,但await特别高而util不高,可能是磁盘有坏道或者RAID组在重建,还要给根分区、日志分区、数据分区分别做空间历史趋势,
切忌只监控一个“/”根目录,业务日志单独挂盘且被写满的情况太常见了。
网络连接的TCP状态变化
内网带宽被打满的情况很少见,但TCP连接数异常增长却经常预示应用问题,TIME_WAIT状态的连接数过高,通常意味着短连接请求太频繁,需要改连接池配置,长期记录established和time_wait的数量,配合每日请求量变化,能很清楚地看到服务的并发承载状况,还有一个容易忽略的是重传率,这个指标高了不是网络问题就是对方服务器处理不过来。
主流监控工具实战对比,按场景选型
服务器性能监控工具推荐的前提是先搞清楚自己的使用场景,自建机房、公有云原生、混合架构的取舍差别很大,没有万能的工具,只有适不适合。
开源三巨头:Prometheus、Zabbix、Netdata
当前最主流的组合是Prometheus + Grafana,这是内地互联网公司使用最广的方案,Exporter负责采集,Prometheus负责存储时序数据,Grafana负责画图,这套组合上手门槛不低,学习曲线陡峭,但胜在灵活,比如需要记录某个JVM线程池的变化,找个JMX Exporter自己改一下配置就行。
Zabbix则是老牌网管风格,自带告警和发现机制,对传统IT运维人员比较友好,它的强项是模板多,涵盖网络设备、Windows服务器,不必像Prometheus那样做很多配置,缺点是界面相对陈旧,大规模部署时查询性能不如Prometheus。
Netdata画出来的图最漂亮,几乎零配置就能用,安装完自动识别主机上的MySQL、Nginx、Redis进程,它的缺点也明显,数据默认只存在内存里,重启就丢了,不持久化意味着看不了半年前的趋势图,只能做辅助排查。
云厂商自带监控和第三方SaaS
如果你用的是简米云、酷番云或华为云,它们自带的基础监控面板其实已经能覆盖CPU、内存、磁盘、网络这几项基础指标了,最大的优势是云监控不用自己部署Agent配置告警,登录控制台就能看,但短板是数据保留周期有限,通常只有一个月左右,想要回溯半年前某一周的趋势,就必须开通付费的日志服务。
第三方SaaS监控如监控宝、听云、博瑞,适合那些没有专职运维但业务对稳定性要求高的公司,它们的命令行插件能采集是业务层的数据,例如API响应耗时、慢调用链,这是自建监控不便覆盖的,价格方面从免费版到几千元一年的入门套餐都有,具体看你需要监控多少台机器和保留几个月的数据。一台机器一年几百块钱,换来的是不用自己维护监控系统本身。
选型时的决策树,直接按路径选
- 服务器少于10台,且都在同一家云厂商:优先用云监控自带功能,不会错。
- 服务器少于50台,混合云或物理机多:用Zabbix,模板全,安装快。
- 开发能力较强,服务器多且业务复杂:用Prometheus+Grafana,未来扩展性最好。
- 想要极低的部署成本且只看当前实时状态:用Netdata做辅助,配合云监控告警。
一套基础的监控体系搭建路径
搭建一套能记录长期趋势的Prometheus环境,只需几步,先下载node_exporter放到服务器上跑起来,默认监听9100端口,接着在Prometheus配置文件的scrape_configs里添加该机器的target,然后在Grafana里导入一个Node Exporter Full模板的ID,仪表盘就出来了。整个流程熟练的话二十分钟能搞定一台机器,剩下的就是耐心等待时间积累数据。
存储方面建议给Prometheus单独挂一块SSD盘,把数据保留天数设为90天及以上,如果机器特别多,就考虑用VictoriaMetrics做存储后端,它可以兼容Prometheus查询语法,写入性能强很多,查询速度也更快,这是很多大厂都在用的优化方案,个人项目没必要,机器多了再升级不迟。
如何从趋势图里快读定位故障根因
有了监控数据不会分析,等于白搭,长期运行的趋势图通常有几类典型形态,每种都有自己的含义。
线性爬坡型:内存泄漏的铁证
如果你的内存使用率趋势图是一条45度角的斜线,每天增加一点点,到达某个高点后服务被杀死或重启,然后清空重来。这种情况基本上可以断定是内存泄漏。 排查方向用jmap -dump导出堆转储文件分析,或配合jstat -gcutil看垃圾回收频率有没有异常上升。
阶梯上升型:代码发布或配置变更的印记
比如磁盘空间使用率,平时卖出的时候很平缓,每隔一段时间会突然跳升一个台阶,这个时间点很可能对应一次新功能上线或日志级别调整,此时你可以把监控图的时间和发布系统记录做个对齐,看是不是每次发布都会产生大量日志,解决方案无非是定期清理日志、增加日志轮转策略或改造输出格式。
周期性波浪型:业务规律的真实写照
大多数互联网产品的流量都有昼夜周期,这是正常现象,但如果这个波动的波峰高度在逐周抬升,说明业务的增长趋势健康,同时也提醒你需要提前扩容规划。当CPU或带宽的周峰值超过70%的时间超过一个月,就需要准备扩容了,因为一旦有大促或突发流量,脆弱环节会最先崩溃。
告警规则别乱设,减少无效值班骚扰
监控工具不能只记录,还得有预警能力,告警规则设得太敏感,每天响个不停,人就会麻木,合理做法是区分级别,不要一刀切。
简单的做法是设置三档水位线。CPU使用率:持续10分钟超过85%触发警告,超过95%触发严重告警。内存
:可用内存低于10%且swap占用了物理内存的50%以上,才触发严重告警,因为很多Linux系统内存用满但未用到swap,能用时不必过度紧张。磁盘:根分区空间使用率超过80%提示清理,超过90%触发严重告警,好有充足的时间去备份。
告警通知渠道如何选
- 普通警告:汇总到群机器人,比如钉钉、飞书或企业微信机器人推送。
- 严重告警:直接调API接电话,避免夜间漏看消息导致业务长时间中断。
- 注意收敛规则:同一台机器连续触发10次通知,不如每30分钟汇总发一条。
监控数据到底该存多久,存储成本怎么平衡
这里涉及一个关键问题:服务器监控工具价格除了软件本身的授权,更可能产生成本的是存储消耗,保存原始时序数据一个月和一整年所需的磁盘空间差距是巨大的。
业内专家指出一个常见策略:高精度数据保留短周期,降精度数据保留长周期,比如每5秒采集一次的数字保留7天,每1分钟聚合一次的数字保留30天,每15分钟聚合一次的数字保留一年,Prometheus的recording rules和retention参数就能实现这个需求,这种方式下,一台虚拟机一年产生的监控存储开销在几GB到十几GB不等,成本完全可控。
Q&A:服务器性能监控工具的常见问题
Q:监控服务器长期运行趋势需要购买付费软件吗?
不需要,如果你的核心诉求是记录CPU、内存、磁盘、网络这类基础指标,开源的Prometheus加Grafana完全够用,只有当业务量巨大、需要监控成百上千台机器的集群,或者需要更智能的异常检测算法时,商业软件才值得考虑投入成本。
Q:服务器长期运行性能不断下降怎么办?
先用监控工具查看重启时间点前后的趋势差异,确定是操作系统资源耗尽的问题还是应用代码的问题,重点检查内存和磁盘IO是否有缓慢上涨的曲线,连接数是否比前几天大幅增加,根据趋势图的形态决定是优化代码还是升级配置。
Q:Prometheus和Zabbix,新手选择哪个更容易上手?
如果是纯Linux云服务器环境,Prometheus的node_exporter安装起来更快而且更轻量,需要改一些指标配置时相对灵活,但如果你管理的环境里有Windows、虚拟机、网络设备等多样化组件,Zabbix自带的监控模板会更省事,页面也更贴近传统网管习惯,两者的学习资料在互联网上都相当丰富,遇到问题时搜索解决方案的难度差不多。
记录长期趋势的本质,是把被动救火变成主动预防,让服务器自己讲故事给你听。从今天开始把基础指标记录起来,一个月后回头审视这些数据,你会对自己服务器的真实脾气有更深的了解。 你不需要一次就搭建出完美的监控体系,先跑起来,再逐步完善,这才是最务实的路径。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/660131.html