虚拟化服务器选型里,管理网络带宽是最容易被低估的环节,很多人把预算全砸在业务网口和计算资源上,等集群出现节点失联、迁移卡顿、存储超时的时候,才意识到管理口带宽不够用,已经晚了。
管理网络带宽在虚拟化环境里到底承担什么活
很多初次做虚拟化选型的朋友会把“管理网络”理解成只是用来登录Web界面、跑跑SSH的通道,带宽随便给个千兆口就够了,这个理解在单机场景下勉强成立。一旦进入集群模式,管理网络的负载性质就完全不同了它承载的不是人操作产生的低流量,而是虚拟化平台自身的控制平面和数据平面辅助流量。

戴尔和VMware的官方最佳实践文档里都反复强调过同一件事:管理网络必须独立规划,不能和业务流量混跑,原因很简单,管理网络上传的不只是你敲命令的那几KB数据,还有以下这些高负载流量:
- vCenter与ESXi主机之间的Agent通信:包括性能监控数据、告警信息、配置变更下发,节点多的时候每秒都有大量小包交互
- HA心跳信号:集群内各节点每秒钟互发心跳,带宽正常时开销不大,但网络拥塞时延迟飙升会直接触发误判
- vMotion在线迁移:虚拟机在主机间迁移时,内存页面的变化量全部走网络传输,一台16GB内存的虚拟机跑vMotion峰值能吃掉千兆网卡的八成吞吐
- FT容错的日志流量:如果开了Fault Tolerance,主备虚拟机之间每一笔内存写入都要同步,这个流量甚至比业务流量还大
- 存储相关的管理流量:vSAN的健康检查、存储I/O控制、快照整理等操作会产生突发性数据传输
你以为的管理网络是条小水管,实际它承担的是控制信号+数据同步+故障转移的三重角色。行业共识认为,管理网络带宽不足引起的虚拟化故障,相当一部分要等业务真正高峰时才暴露出来,前期很难感知。
虚拟化服务器管理网络带宽太小的真实后果
纸上谈兵没用,直接看场景,某企业做了三节点VMware集群,每台服务器配了两块千兆网卡,一块跑业务,一块配了管理网络和vMotion混用,表面上日常跑得挺顺,直到某个周末晚上运维人员做例行维护,要下线一台物理机进行固件升级。
操作很简单:把上面十几台虚拟机vMotion迁移到另外两台节点上去,迁移命令一发出,管理网口立刻被打满,千兆带宽在十几台虚拟机的内存复制面前根本扛不住,迁移速度从正常的每分钟约2GB掉到每几分钟几百MB,更要命的是,由于管理流量堵塞,HA心跳开始出现延迟,vCenter界面上另外两个节点开始报警“主机网络已隔离”。
最后的结果是:原本半小时能完成的维护操作拖了四个小时,期间vCenter频繁弹告警,业务侧虽然没中断但因为网络抢占导致存储延迟上升,半夜被业务方连环call,操作完复盘才发现,那块千兆管理网卡在工作时CPU占用率拉满,交换机端口长时间处于接近饱和状态。
还有个常见的坑是管理网络和业务网络混在一个物理网口上,靠VLAN区分,这种做法在逻辑上没问题,但物理层面两者共享同一块网卡芯片和同一根物理链路,一旦业务网段出现广播风暴或者被大流量攻击,管理网络直接跟着瘫痪,服务器宕机了你连上去排查的路都没有,只能跑机房接显示器。
所以选型时,管理网络带宽不是“够不够跑运维”的问题,而是“在故障和迁移场景下还能不能保证控制通道畅通”的问题,带宽规划不足,虚拟化平台就像一个手脚被绑住的指挥官,出事了想指挥调度,手却伸不出去。
虚拟化服务器选型时管理网络带宽怎么定
每家企业的规模不同,没法给一个万能的数字,但可以根据集群规模和业务性质来划分带宽档位,下表是一个经过多个实际项目验证的参考框架:
| 集群规模 | 管理网络建议配置 | 适用场景 |
|---|---|---|
| 2-3台单机虚拟化 | 双口千兆,独立管理口,业务口分离 | 小型办公虚拟化,测试环境,负载低 |
| 中小集群(4-8台) | 双口万兆,管理流量单独走万兆口,vMotion可另配专用口 | 生产环境,有HA和vMotion需求 |
| 大规模集群(10台以上) | 双口万兆起步,25G建议,管理网络与vMotion物理分离 | 虚拟化规模大,存储流量与迁移流量并发高 |
注意这个表格不是随便拍的,双口万兆的物理网卡现在价格已经很接地气,对于生产环境来说,多花不到一千块把钱花在管理口的升级上,远比加内存加CPU更值。
网卡选型方面直接看实践:
- 四口千兆网卡:适合低负载场景,4个口分别拆分为管理、业务、存储、备用,不要图省事全部做捆绑
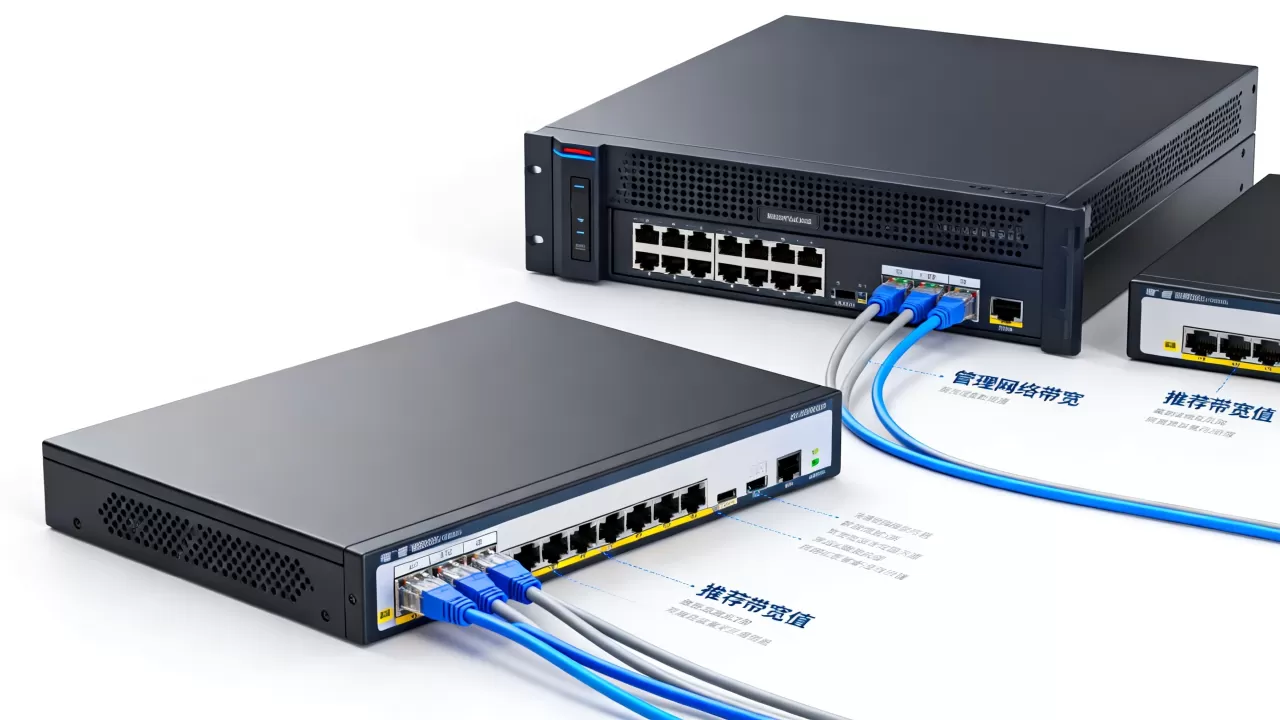
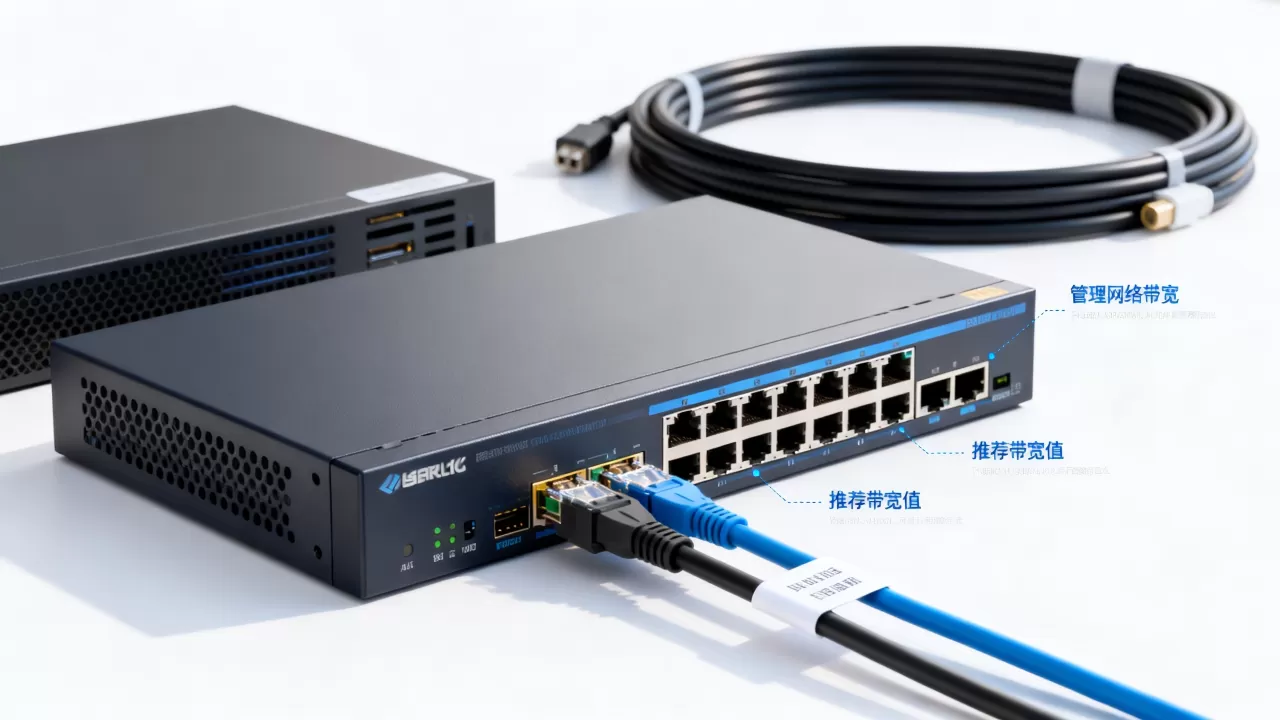
- 双口万兆网卡:生产环境最低配,一个口做管理+控制流量,一个口做业务流量入口
- 阵列卡加万兆口组合:推荐虚拟化服务器至少留出2个万兆口,一个走管理控制平面,一个走vMotion或存储网络
对于选型时的具体实操路径,可以参考下面的动作清单:
-

第一步:数清楚这台服务器上要承载什么角色,是计算节点还是存储节点还是综合节点
- 第二步:确认交换机上有没有足够多的万兆端口对接,很多项目卡在主机买了万兆口但接入层交换机全是千兆,结果物理链路自动降速
- 第三步:规划好VLAN和网口绑定策略,管理网络单独划一个VLAN,不要跟任何业务VLAN共用广播域
- 第四步:给vMotion配置专用物理口或至少独立的VLAN与带宽保障,不要让迁移流量跟管理流量抢同一个口
管理网络带宽规划里最容易忽略的配置细节
选型搞定硬件之后,真正拉开差距的是部署配置时的细节,以下每个点都是实际生产环境中踩过坑总结出来的。
虚拟机网卡的队列中断设置。 万兆网卡如果不开RSS(接收端缩放)或者多队列,单核CPU处理中断会成为瓶颈,配置方法是在ESXi的网卡属性里开启RSS,或者在Windows宿主机上调整网卡的高级属性,很多选型时明明买了万兆网卡,最终跑出来只有千兆效果,问题就出在这里。
管理网络的MTU设置。 默认MTU是1500字节,如果交换机支持Jumbo Frame,把管理网络的MTU调成9000能显著降低CPU开销和数据包数量,但注意必须所有链路设备(网卡、交换机、对端服务器)一起改,任何一环没改都会导致数据包被分片,反而更慢。
带外管理口和带内管理口的区分。 服务器上的iDRAC/IPMI口是带外管理口,真正虚拟机层面要用的管理网络是接入交换机的物理网口,两者目的不一样,不少厂商在选型时会把远程管理卡接口跟虚拟化管理网络混为一谈,认为“反正有个独立管理口了”,事实上iDRAC只管硬件远程控制,VMkernel端口的管理流量还得走你那块网卡,别指望靠它分流。
管理网络的VLAN和QoS配置。 在交换机上给管理网络VLAN配置QoS优先级,保证即使业务流量拥塞,管理控制帧也会优先转发,这个操作五分钟就能做完,但在突发故障场景里能保证你还能远程登录到服务器上去执行操作。虚拟化管理网络最忌讳“全放一起最后谁也别想跑”。
验证管理网卡带宽是否达标的方法,用vmkping就够了:
- 在ESXi里执行
vmkping -S vmkernel端口名 -s 8972 目标IP测试管理网络连通性和延迟 - 使用
esxcli network nic list查看所有网卡当前的协商速率,确认没有降级 - 大规模vMotion前用
esxtop按n键进入网络视图,观察实际吞吐量是否接近理论带宽
虚拟化服务器管理网络带宽够不够,可以用几个现象自查
先看症状再谈优化,以下现象如果你中了两条以上,管理带宽大概率是短板:
- vCenter里“主机心跳”偶尔显示红色告警,过几秒自动恢复
- 虚拟机vMotion迁移速度比预期慢,一两台Windows虚机迁移耗时超过二十分钟
- 大数据量的虚拟机备份任务执行期间,管理界面访问卡顿明显
- 存储多路径的路径切换延迟偏高,vSAN健康检查经常提示网络延迟异常
- 批量创建或克隆虚拟机时,vCenter操作任务排队时间异常长
虚拟化服务器怎么选,管理网络带宽这个问题一定要在需求阶段就问清楚。 很多项目招标书里写“千兆以太网接口不少于4个”,却没说清楚这4个口的用途分配,结果项目实施时为了满足管理、业务、存储、备份四种流量,只能物理端口复用,利益相关但常被忽视的现实是,千兆口在虚拟化环境里跑管理网络加vMotion,规模一大基本必出网络性能预警。
管理网络带宽规划的最终建议
虚拟化服务器选型时给管理网络预留的带宽要翻倍计算。 照着vMotion并发迁移两台虚拟机的流量去规划,至少各留50%的冗余量,服务器物理网卡选择上,优先考虑双口万兆起步,四口千兆作为补充而不作为主力,交换机选型时同样要确认上行链路带宽和端口缓存能否跟上,别让服务器的万兆口接在交换机千兆上联上。虚拟化平台的管理网络是所有创新的安全感来源,带宽给足了,后续做容灾做迁移做扩展才有底气,否则省下来的每一分钱都会在故障处理时加倍还回去。
关于虚拟化服务器管理网络带宽的常见疑问
虚拟化服务器用千兆口做管理网络是不是完全不行?
不是绝对不行,对于不超过三台主机的实验环境或非核心业务虚拟化,用独立千兆口承担管理网络完全够用,但考虑未来扩缩容和临时负载高峰,生产环境不建议把千兆口作为管理网络的最终形态,判断依据很简单:如果这台服务器将来要承载vMotion或存储控制流,就别用千兆口赌未来,硬件升级窗口错过之后,再想从千兆跳到万兆往往需要连带换交换机,成本高出好几倍。
管理网络带宽和业务网络带宽能共用一块万兆网卡吗?
物理上可以,逻辑上不建议,VMware的官方文档支持通过VLAN在同一个物理万兆口上区分管理流量和业务流量,但虚拟化平台的推荐部署模式是分离部署,原因在于管理流量需要低延迟保证,业务流量追求高吞吐,二者混跑时管理流量的延迟容易受到业务瞬时高峰的影响,调优时可以给管理网络设置高网络优先级,但物理隔离仍是最稳妥的解法。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/660831.html