不求大而全,只求刚刚好,一台4核16G的机器,如果业务实际只用到2核8G,剩下的资源就是沉默成本。把配置线划在业务真实负载曲线上,资源利用率才能从两三成往七八成走。
容器宿主机配置多少核合适?先看业务画像
很多团队在给容器宿主机定配置时,习惯拍脑袋选一台“看起来不会爆”的机器,8核32G起步,16核64G打底,预算充足就直接上物理机,结果呢?生产环境跑起来,CPU使用率曲线低平,内存占用长期徘徊在低位,浪费的不只是钱,还有机柜、电费和运维精力。
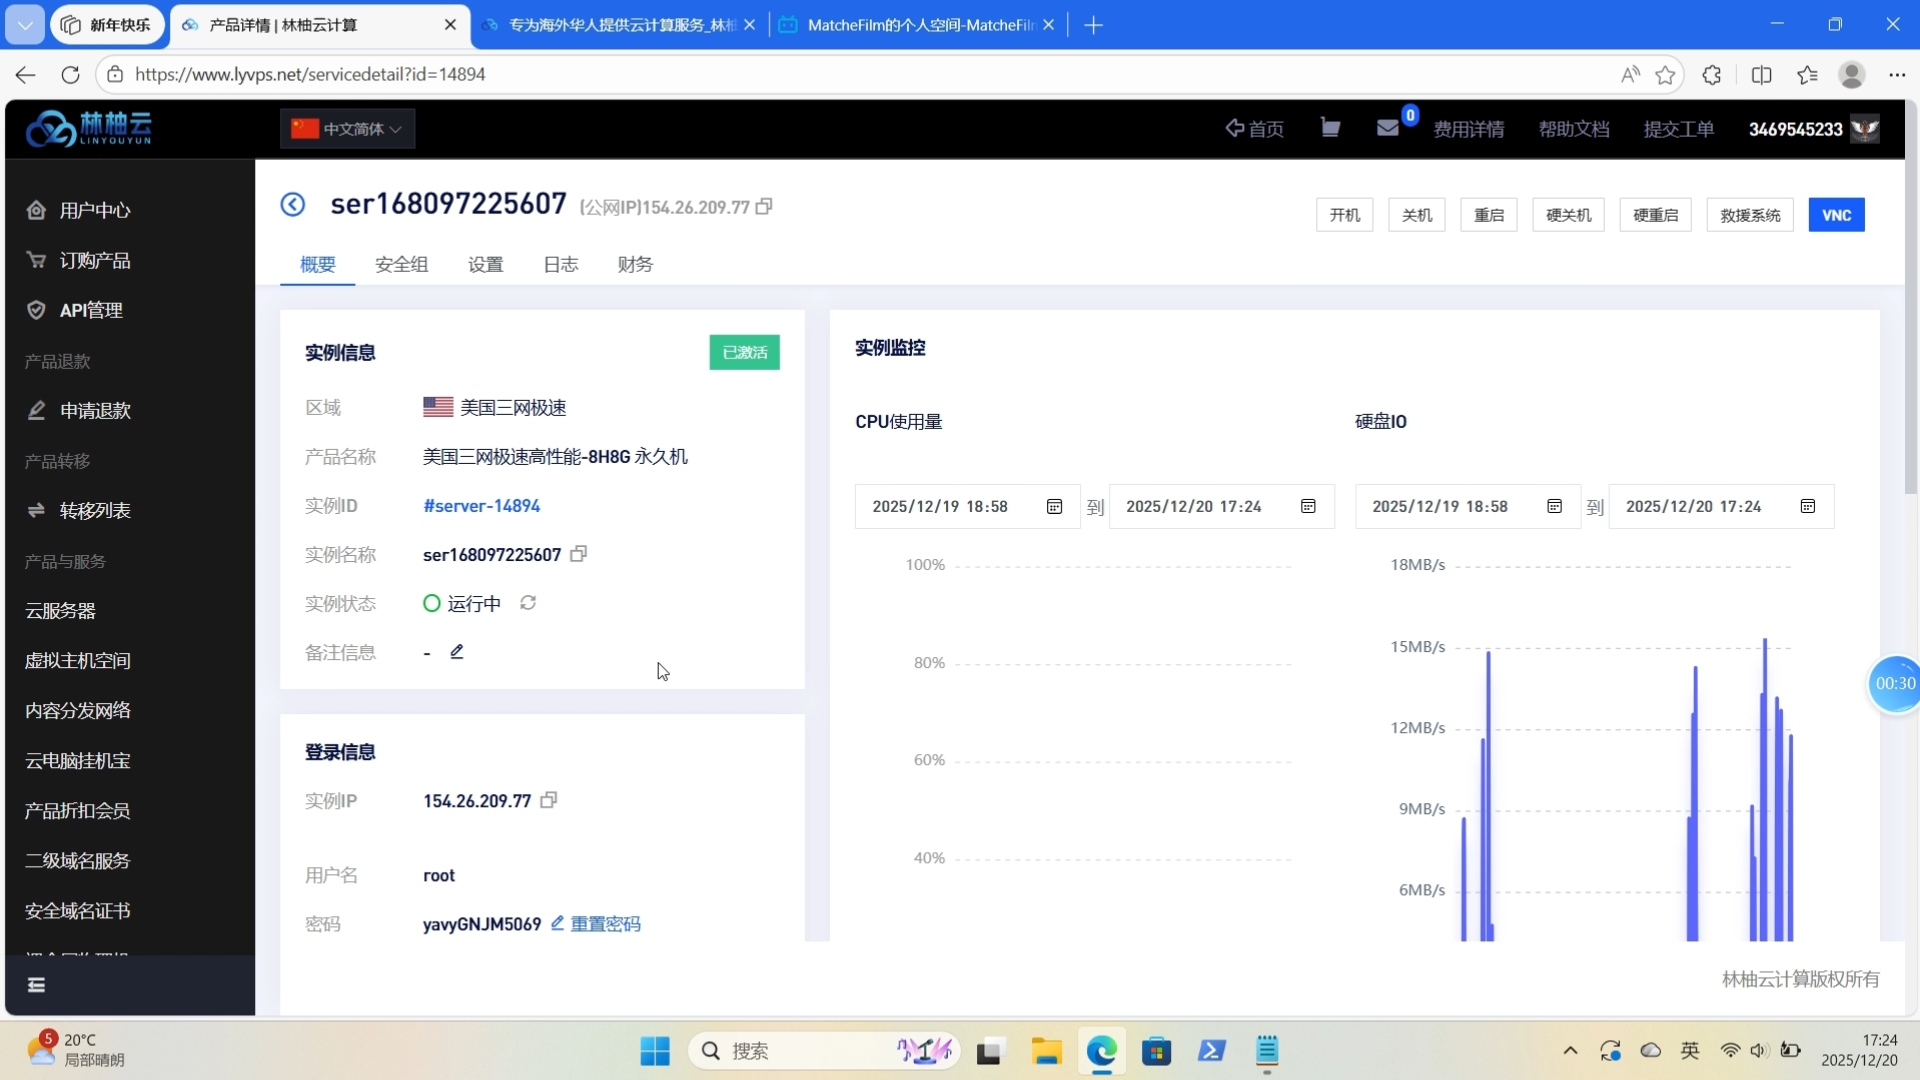
容器宿主机按需配置的第一原则,是让机器配置对齐业务画像,而不是对齐心理预期,业务画像怎么画?从四个维度观察:CPU时间片占用、内存驻留量、磁盘IO频率、网络吞吐峰值,其中CPU和内存是决定性指标,磁盘和网络多数场景下做辅助参考。
用监控数据而不是经验值定基线
具体操作路径:先让业务在测试环境或灰度环境跑两周,用Prometheus或云厂商自带的监控面板记录每小时的资源峰值,把数据拉出来后,去掉最高5%的毛刺点,剩下的P95值就是你的配置基线。
一个典型的微服务业务,网关节点峰值CPU 1.8核,内存2.1G,那宿主机选4核8G就足够,两个副本再加点缓冲,如果业务是数据分析型,内存峰值拉到12G,CPU反而只用了3核,那配置就该向内存倾斜,选4核16G而非8核16G,这也是容器宿主机按需配置的常见误区CPU和内存的比例不等于云厂商默认的1:4模板。
留出20%余量就够了
行业共识认为,容器宿主机按需配置时保留20%的资源余量是最佳实践,比如业务P95需要5核10G,宿主机选8核16G,多出来的3核6G用来应对突发流量和节点故障转移,余量留太大,和买了一台高配机器闲置没有区别;余量留太小,QPS稍微冲一下,容器就会因资源不足被驱逐。
这里有个反直觉的点:按需配置不等于精打细算到每一M内存,如果一台宿主机上跑了10个容器,整体资源使用率到了85%以上,调度器再往这台机器塞新容器时,可能会因为碎片化找不到合适的资源块,留20%余量不仅是给业务留缓冲,更是给调度器腾出排列组合的空间。
容器宿主机选型场景拆解:CPU密集还是内存密集
容器宿主机选型场景不同,配置策略截然不同,同样是跑Docker容器,一台跑Java微服务的机器和一台跑机器学习推理的机器,硬件需求曲线完全两条路。
高并发API网关
这类业务的特征是CPU消耗稳定且高频,内存占用相对平缓,每秒处理上千次请求,每次请求要做路由转发、鉴权校验、限流判断,CPU使用率会在白天保持在一个平台期,偶尔因为上游抖动出现毛刺。
配置建议:CPU核心数配比内存容量,按1:2到1:3走,比如4核8G或8核16G,都是常见选项,这类场景下,宿主机上容器密度可以高一些,因为每个容器吃的内存不多,CPU时间片反而是主要瓶颈。
你可以在生产环境跑一下docker stats命令,观察每个容器的CPU和内存占比,如果看到CPU列经常接近100%,内存列只有50%左右,那说明容器规格里CPU限制卡得太紧,内存配额有余量,反过来,宿主机选型时就可以适当调低内存容量,把预算花在更多核数上。
大数据分析或ETL任务
这类业务是内存大户,Spark作业的executor动辄申请几个G的堆内存,数据Shuffle阶段内存压力陡增,CPU虽然也有消耗,但往往在等待磁盘IO或网络传输的空隙里“歇着”。
配置建议:CPU与内存比例建议1:4甚至1:8,比如一台4核32G的宿主机会比8核16G更贴合业务需求,容器编排工具如Kubernetes在调度时,主要看内存的请求值(requests)和限制值(limits),内存不够会有ContainerOOMKilled的报错,CPU不足顶多性能下降。
在简米云之类的云平台上选择容器宿主机时,你不必只盯着通用型ecs实例。内存型实例(如r系列)在内存单价上更有优势,同样的花费能买到更大的内存容量,如果你用的自建机房,采购服务器时也可以单独要求加大内存插槽配置,不用纠结CPU核数顶格。
开发测试环境
开发测试环境是容器宿主机按需配置收益最大的场景,很多公司给测试环境用的机器配置和生产环境一样,但业务负载连生产的十分之一都不到,几十个测试容器跑在一台物理机上,CPU使用率常年低于10%。
测试环境的宿主机配置可以走两个方向:一是用高密度小规格,比如2核4G的宿主机塞5-6个测试容器;二是直接用超卖模式,给每个容器限制远低于实际物理资源的规格,让多个容器共享底层资源,这种情况下,你要避免的是选型时“为了保险”直接拿生产配置的缩小版那只是把小浪费变成大浪费。
按需配置和超卖有什么区别,怎么选
容器宿主机按需配置和容器超卖(oversubscription)这两个概念经常混在一起,它们是两种不同的资源管理策略,按需配置解决的是“机器应该买多大”的问题,超卖解决的是“一台机器上能塞多少个容器”的问题。
按需配置的思路是:宿主机资源等于业务实际消耗加上安全余量,每一分硬件资源都有明确归属。
超卖的思路是:宿主机资源远小于所有容器规格之和,赌的是所有容器不会在同一时刻打到峰值。
| 对比维度 | 按需配置 | 超卖 |
|---|---|---|
| 资源利用率 | 50%-70% | 80%-90%以上 |
| 运行风险 | 低,容器资源充足 | 高,峰值易触发CPU节流 |
| 适用业务 | 生产环境核心链路 | 开发测试、短期任务 |
| 成本模型 | 硬件成本中等 | 硬件成本较低,运维成本高 |
在Kubernetes里,超卖是通过调整requests和limits的比值来实现的,比如给容器设requests=0.5核,limits=1核,这台容器最多能用1核CPU,但调度时只按0.5核算,当所有容器的requests加起来超过宿主机实际CPU核数,就是超卖状态。
实战中的建议:生产环境不做超卖,按需配置到位;开发测试环境可以超卖到1.5倍到2倍,有一个真实案例值得参考:某创业团队给生产环境买了10台16核64G的宿主机,跑了十几个微服务容器,后来发现CPU使用率平均只有22%,于是把容器规格缩小一半,腾出5台机器做测试环境,每个月云账单直降30%,这就是容器宿主机按需配置带来的直接收益。
容器宿主机配置成本怎么压下来
容器宿主机按需配置最终要回答的问题是:花了多少钱,换来多少真实算力,单纯从单位价格来看,大规格机器的性价比通常优于小规格,问题在于大规格机器很难被填满。
云服务商的报价表就有意思了,一台8核32G的宿主机月费在五六百元左右(以某主流云厂商入门级标准型为例),两台4核16G加起来的费用反而更高,道理不复杂:物理机总成本跟部件规格不成线性关系,按需配置的“按需”,在成本层面不是买最便宜的配置,而是在你需要的资源总量里,用最小的机器台数去装下它们。
用业务周期优化配置
一个常见的按需配置优化路径是看业务的周期波动,办公类应用白天活跃、晚间闲置;电商类应用工作日和周末差异明显;ToB类SaaS常常月初审计时资源消耗陡增,如果容器集群用的是云上托管节点池,你完全可以根据周期性规律做定时扩缩容白天8台机器,晚间缩到2台,凌晨再缩到1台。
在自建机房的场景下,物理服务器的采购没法做到按月伸缩,这时候按需配置的思路转变为混合部署:把生产业务和离线任务混部在同一批宿主机上,白天生产业务消耗CPU,晚上离线任务利用空闲的算力跑批处理,这种混部模式,等于在物理机层面完成了一次“按需配置”。
容器规格统一化带来的隐性收益
容器宿主机按需配置的另一层含义,是让宿主机规格逐级收敛,如果集群里有2核4G、4核8G、8核16G、16核32G四种宿主机构成的混部节点池,调度器就永远在应付复杂的亲和性和拓扑约束。
把节点池划分成两档就够了:普通计算型和大内存型,每一档内部的宿主机配置保持一致,容器规格也尽量统一成两三种模板,这样Kubernetes调度时无需反复计算节点上剩余资源是否够用,部署效率明显提升,运维侧也可以把监控告警阈值统一设定,不用为每台机器单独配置。
据工信部近年发布的数据,国内企业上云后普遍存在云资源闲置率较高的问题,相当一部分企业的容器宿主机CPU平均使用率不足三成,这个数字提醒我们:配置带来的浪费常被误认为是规模扩张的必要成本,实际上按需配置每年能为企业省下相当数额的IT开支。
Q: 容器宿主机按需配置会影响业务高峰期稳定性吗?
A: 只要配置基线来自业务P95指标而非平均值,并保留20%余量,就不会影响,关键在于持续监控,如果某周高峰期出现过CPU软限制拦截,就说明余量不够,需上调宿主机规格或拆分容器到多台机器。
Q: 使用容器宿主机按需配置后,原先空闲的服务器怎么处理?
A: 优先将空闲宿主机转入开发测试环境,配合容器超卖提高利用率,其次可以作为临时任务或CI构建的专属节点,这类任务对性能隔离没有高要求,适合消化剩余算力。
Q: 容器宿主机按需配置和垂直扩容是冲突的吗?
A: 不冲突,按需配置解决的是初始采购和日常运行的成本问题,垂直扩容解决的是业务增长后的弹性扩展问题,先按需配置跑起来,监控数据反馈资源接近瓶颈时,再加配或换更高规格宿主机,两者是同一策略链条上的前后环节。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/660970.html