把物理和逻辑依赖关系做分层切分,让单点故障最多只影响一个故障域,而不是整片集群。
多活架构下服务器故障域隔离怎么做:先理解故障域的“三层切割”
故障域隔离不是把服务器分散摆开就行,它需要按物理、逻辑、应用三个层次切分,很多人以为跨机柜部署就是隔离了,实际上如果电源、交换机、存储依赖没有切干净,故障照样会沿着依赖链扩散。

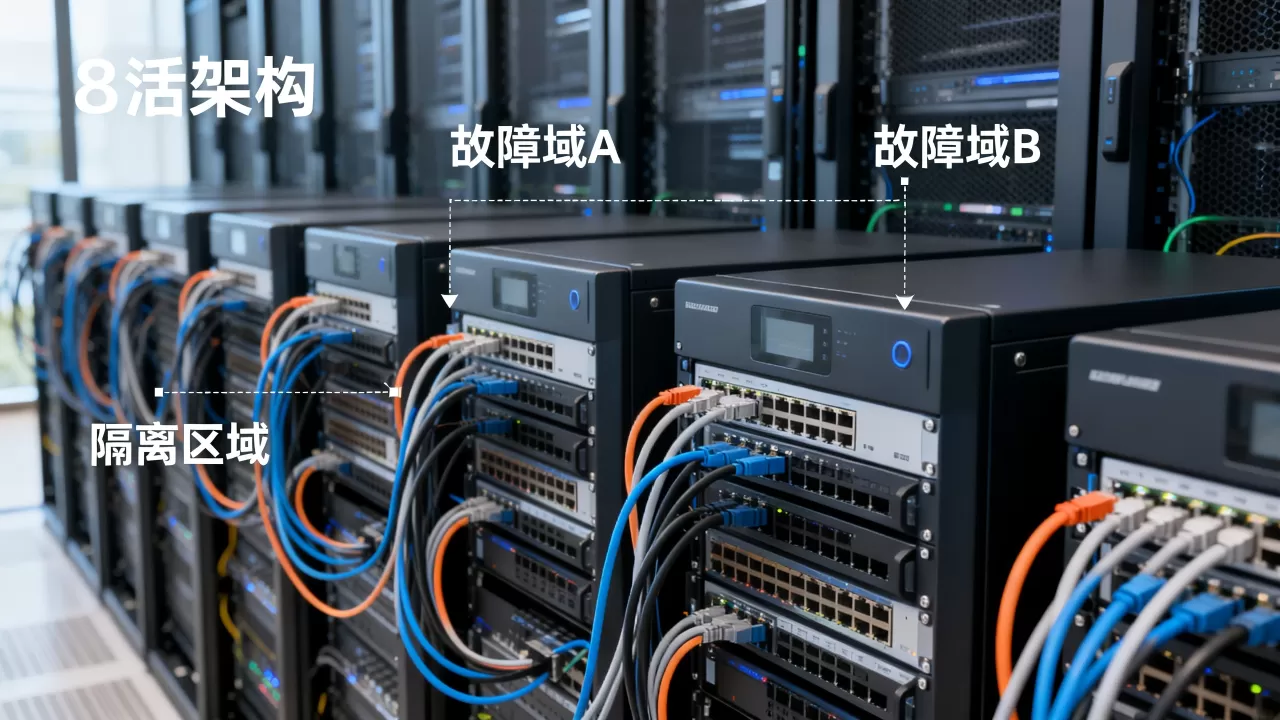
物理故障域:机柜、列间、机房级
物理故障域指一台机器挂了之后,同一故障域内还有多少机器会跟着受影响,常见切分粒度有三个:
- 机柜级:同一机柜内共享电源插排和顶部交换机,隔离策略是把同一服务的副本分布到不同机柜。
- 列间级:数据中心的一列机柜通常共享列头柜供电,如果列头柜故障,整列都会断电,隔离策略要求副本不能集中在同一列。
- 房间级:空调失效、消防误喷、漏水等场景影响整个房间,多活架构下至少跨房间部署,条件允许跨机房。
逻辑故障域:交换机、电源、存储依赖
逻辑故障域往往比物理故障更隐蔽,服务器A和服务器B虽然在不同机柜,但如果接在同一个接入交换机上,交换机重启会同时中断两台服务器,同理,双电源模块如果接到同一路市电,一路掉电仍可能同时关机。
业内专家指出,多活架构设计中最容易被忽略的不是服务器本身,而是上游依赖的共享设备,隔离必须沿着依赖链做拓扑梳理。
故障域隔离和可用区隔离的区别是什么
这是运维架构里经常被混在一起的两个概念,简单说,故障域隔离是“把爆炸半径控制在更小单元”,可用区隔离是“把整体冗余分散到不同物理位置”,区别主要体现在三方面:
| 维度 | 故障域隔离 | 可用区隔离 |
|---|---|---|
| 目标 | 降低单点事故影响面 | 提升区域级容灾能力 |
| 粒度 | 机柜、列、房间、机架 | 可用区、地域 |
| 实现方式 | 反亲和调度、依赖拓扑梳理 | 跨AZ同步复制、流量调度 |
| 故障类型 | 硬件、电源、交换机、局部网络 | 火灾、断电、光缆中断、自然灾害 |
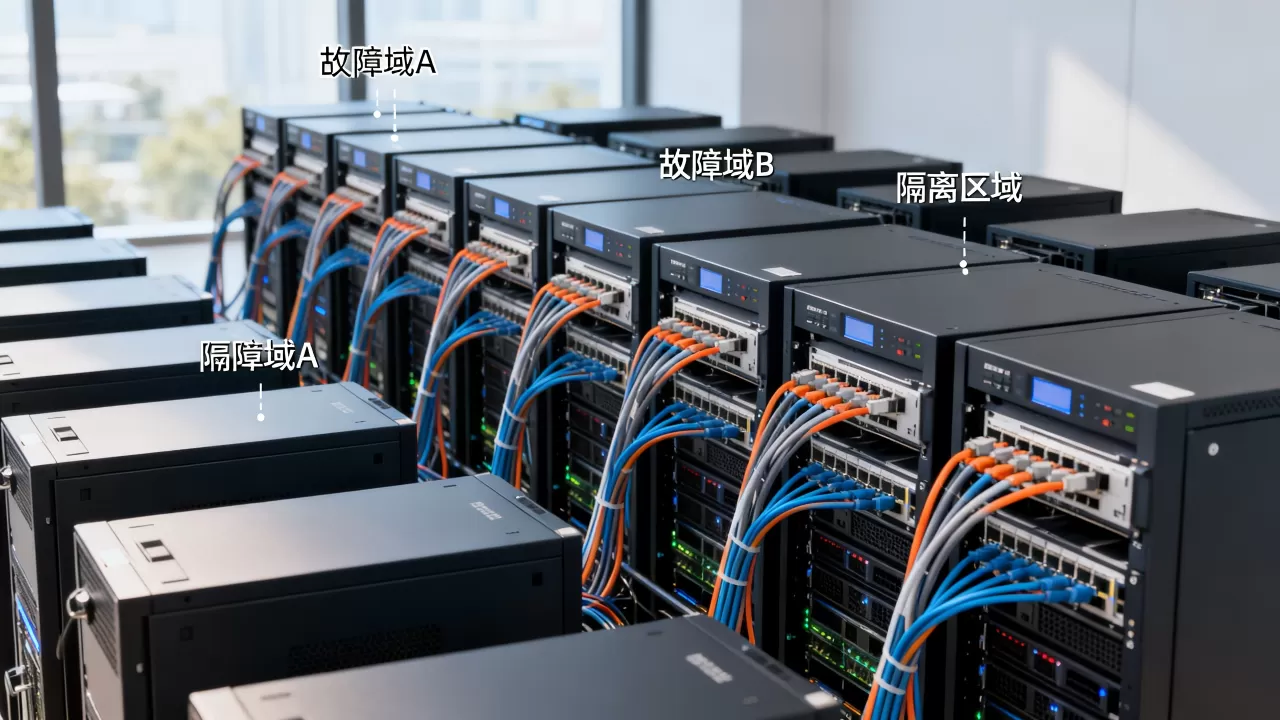
可用区隔离是故障域隔离的放大版,一个可用区内部依然要做机柜级和列级故障域切分,否则可用区内部局部故障会打穿整个可用区,失去跨区冗余的意义。
机房机柜级故障域隔离方案:从规划到落地的具体路径
服务器故障域隔离配置清单与价格成本参考
很多人问服务器故障域隔离配置要不要额外花钱,答案是:基础配置不花大钱,但要做到自动化验证和无状态依赖改造需要投入人力,下面是一份典型的配置清单,成本跨度主要看环境规模和要不要上自动化平台。
- 物理分散规划:副本分布策略文档,成本几乎为零。
- 交换机与电源拓扑图:需要人工梳理,小型机房大概几个工作日。
- 反亲和调度规则:Kubernetes用
topologySpreadConstraints,OpenStack用affinity策略,不产生硬件费用。 - 故障注入测试环境:可以用ChaosBlade或Chaos Mesh,开源免费。
- 监控告警聚合:Prometheus按机柜和列打标签,二次开发成本看团队能力。
价格层面,纯软件方案多数开源,主要成本在改造老服务和测试验证,如果是托管机房,跨机柜和跨列部署通常不额外收费;但如果要跨房间或跨楼栋,线路和机位价格会明显上升,具体以服务商报价为准。
地域实践:北京多活机房故障域隔离设计要点
北京地区的多活机房受限于土地和电力资源,很多老机房建筑结构复杂,列头柜位置不统一,做故障域隔离时,有几个地方要额外注意:
- 先摸清每列机柜的电源来源,部分老机房存在“一列两个供电回路但回路来自同一母线”的情况。
- 核心交换机分布不均匀,有些机柜密集区域共用一组汇聚交换机,跨机柜部署时容易踩坑。
- 北京部分园区有多个楼栋但地下光缆路径可能重叠,跨楼栋看似隔离了,实际光缆走同一个管井,施工挖断时两个楼栋同时中断。
所以在北京做多活机房故障域隔离,不能只看机柜号,要拿到供电链路和物理路由的图纸,做一次依赖拓扑审计。
实操步骤:如何配置一套可验证的故障域隔离策略
下面是一条可落地的操作路径,按顺序执行即可。
- 梳理服务拓扑:列出核心服务的实例数、部署位置、依赖的上游交换机、电源回路、存储集群。
- 定义故障域标签:给每台服务器打上机柜号、列号、房间号、交换机编号、电源回路编号五个标签。
- 设置反亲和规则:
- Kubernetes集群可用如下策略约束Pod不被调度到同一机柜或同一列。
topologySpreadConstraints:
- maxSkew: 1
topologyKey: rack
whenUnsatisfiable: DoNotSchedule - 物理机和虚拟机场景用CMDB接口校验,避免同服务的两个实例落在同一列。
- Kubernetes集群可用如下策略约束Pod不被调度到同一机柜或同一列。
- 配置监控聚合:在Prometheus告警规则里加入
rack和column维度,当同一故障域内多个实例同时告警时单独升级。 - 故障注入验证:用ChaosBlade对某机柜的交换机做断网实验,观察流量是否只影响该机柜内的实例副本,其他副本能否接管。
- 定期审计:每季度扫描一次依赖拓扑,检查是否有新增服务绕过反亲和规则。
这套步骤里最容易卡住的是第3步的物理机场景,很多公司没有CMDB,或者CMDB里机柜信息长期不更新,建议先花时间补齐机柜和电源标签,否则后面所有策略都是空中楼阁。
多活架构服务器故障域隔离配置的常见误区
- 只做物理隔离不做依赖隔离:同一服务的副本分布在两个机柜,但两个机柜的交换机上联同一台汇聚交换机,汇聚交换机故障一样全部中断。
- 故障域分得太细:过度追求每一台服务器都独立故障域,会增加网络复杂度和管理成本,实际收益很低。
- 把可用区隔离当故障域隔离:跨可用区部署只能防区域级故障,不能替代机柜内和列内的细粒度隔离。
- 没有验证:配置规则写完之后不测试,真正断电时才发现反亲和规则因为标签错误没生效。
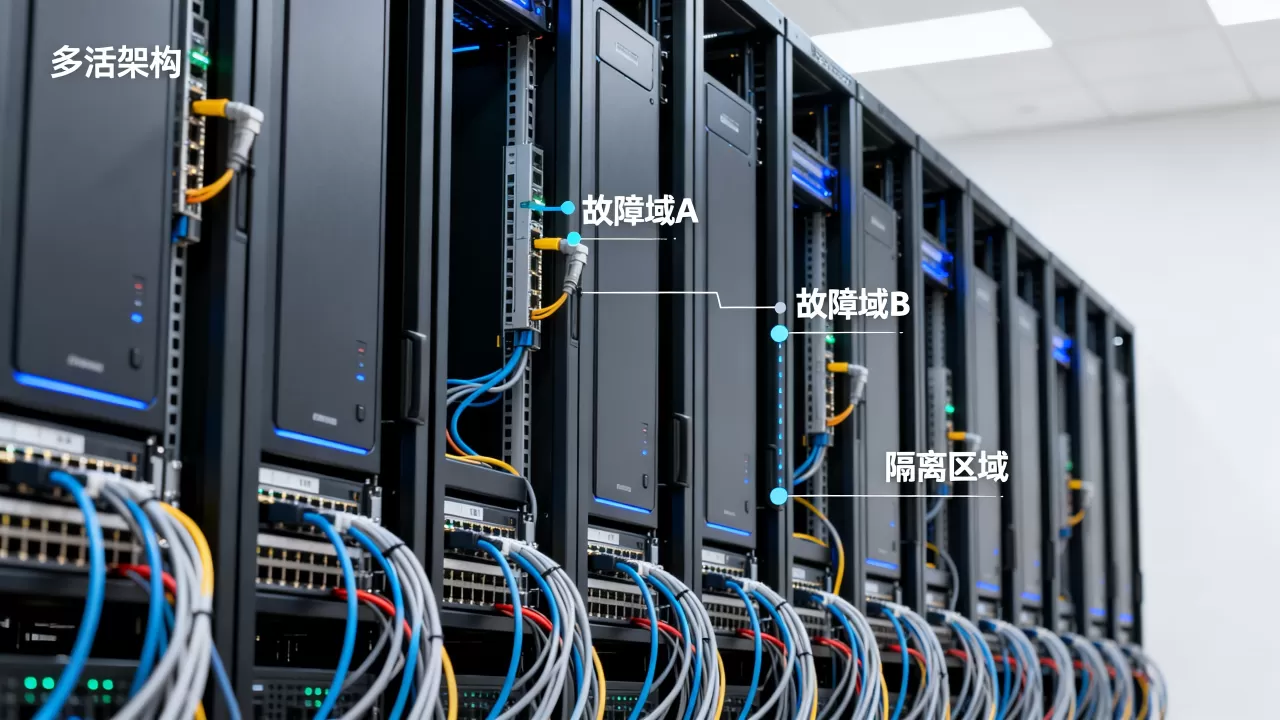
行业共识认为,一个成熟的多活架构至少要做到机柜级故障隔离,核心交易链路建议做到列级隔离。
多活架构的稳定性不是靠多买服务器堆出来的,而是靠把每一层故障半径设计清楚,先做好机柜级隔离,再往列级、房间级推进,用标签、反亲和规则和故障注入验证闭环,才能让“多活”真正活起来。
Q&A
多活架构下服务器故障域隔离的核心指标有哪些?
核心指标主要看三个:最大故障影响实例数、故障恢复时间、故障域覆盖完整度,最大故障影响实例数指任意单一物理或逻辑设备故障时,最多有多少个服务实例同时不可用,故障恢复时间指从故障发生到流量重新收敛到健康副本的时间,故障域覆盖完整度指服务拓扑中被打上故障域标签并纳入反亲和策略的实例比例,实际操作中,多数团队先用最大故障影响实例数做红线,比如核心服务不得超过两个。
故障域隔离测试怎么做才有效?
有效测试必须用真实故障注入,不能用模拟数据,具体做法是选择非高峰期,对目标机柜的上联交换机执行端口shutdown或重启,观察告警和流量切换,也可以拔掉整列机柜的电源回路进行断电演练,测试过程中记录流量切换时间、告警聚合是否按故障域维度触发、是否有未预期服务受影响,测试后复盘标签是否准确、反亲和规则是否按预期工作。
多活架构服务器故障域隔离和同城双活有什么区别?
同城双活主要解决机房级容灾,两个机房之间用同步复制保持数据一致,服务器故障域隔离解决的是机房内部的局部故障,比如单台服务器、单个机柜、单列电源故障,一个同城双活架构如果没有做故障域隔离,任意一个机柜故障都可能触发跨机房切换,带来不必要的流量颠簸和数据同步压力,反过来,只做故障域隔离不做同城双活,也无法应对整个机房断电或火灾,两者是互补关系,不是替代关系,故障域隔离把机房内爆炸半径压小,同城双活把机房级风险用地理冗余兜住。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/661379.html