日志集中存储与检索系统的建设,核心路径是先明确日志类型与留存周期,再选型存储引擎,最后通过统一的采集管道和查询界面落地。这套系统的本质,是把分散在各服务器、容器、网络设备里的运行数据,汇聚到一个能快速写入、能按需查询的地方,建设之前,最怕的不是技术选型难,而是需求没理清就上马,结果存储扩容比业务还勤快。
日志集中存储方案怎么选:先算清你的写入量和查询习惯
很多团队聊日志系统,上来就谈ELK还是Loki,这其实是把顺序搞反了,选型的前置条件是搞清楚两个数字:每天产生多少日志,以及用户习惯查多久之前的数据,这两个数字直接决定存储引擎的选型方向。
写入量决定存储引擎,查询习惯决定索引策略
行业共识认为,日志系统的选型不存在银弹,只有适不适合当前阶段,据工信部近年发布的信息化发展报告显示,国内企业IT系统日均日志量增长明显,多数中型企业的日志平台日增数据量在几十GB到几TB之间,这个量级下,不同引擎的表现差异很大。
- 如果日增日志在 100GB以内,传统Elasticsearch三节点就能扛住,硬件成本低,查询语法灵活,适合绝大多数中小团队。
- 如果日增日志超过 1TB,就得考虑ClickHouse或Loki,ClickHouse的压缩比高,查询速度快,但实时性略差;Loki主打轻量标签索引,适合以Pod或服务为维度的k8s环境。
- 如果日志需要长期留存超过一年,建议做冷热分层,热数据用SSD,冷数据用对象存储加索引文件。
日志集中管理平台怎么选:三个必须问自己的问题
选平台不是看谁的功能列表长,而是看谁能解决你真实的问题,做技术选型时,先问自己三个问题,比看十篇对比文章都有用。
- 数据从哪来? 是纯业务日志,还是包含操作系统日志、安全日志、网络设备日志?采集端支不支持Syslog、Filebeat、Fluentd、Promtail这些常见协议,直接决定接入成本。
- 谁在用这个系统? 开发排查问题要看堆栈关键字,运维要看CPU和内存趋势,安全要看登录和敏感操作记录,这三种角色的查询习惯完全不同,查询界面的友好度要分开评估。
- 出了问题谁负责? 这套系统本身也是基础设施,它挂了的时候,日志还能不能查到?这里要关注系统的降级策略,比如存储集群故障时,采集端的本地缓冲能扛多久。
日志集中存储系统搭建的四个关键步骤
选型定了之后,搭建过程其实是有固定套路的,按照下面四个步骤走,能少踩很多坑。
第一步:统一采集入口,解决协议碎片化
最让运维头疼的不是日志量大,而是采集方式五花八门,Java应用打印到文件,Nginx输出到access log,Docker容器打到stdout,数据库审计日志走Syslog,统一采集入口的解法是引入消息队列,比如Kafka。
业务流程是:所有采集端(Filebeat、Fluentd、Logstash)把数据发到Kafka,再由消费端写入存储引擎。 这样做有三个好处:一是削峰填谷,业务高峰期日志突发时,Kafka能缓冲压力;二是解耦,存储引擎升级或故障时,采集端不受影响;三是多路复用,同一份日志既能进存储,也能进实时告警链路。
采集端配置的实操注意点
- Filebeat的
multiline配置要提前设置,Java异常堆栈是多行日志,不合并的话查一条异常要翻好几页。 - 容器环境优先使用DaemonSet方式部署采集端,每个节点一个Pod,避免Sidecar模式占用过多资源。
- 时间字段统一为ISO8601格式,时区统一为UTC,否则跨机器查询时时间排序会错乱。
第二步:规划索引生命周期,别让存储无限膨胀
日志系统的存储成本,大半都耗在热数据上,多数情况下,一个成熟的系统会配置索引生命周期管理策略,让数据按时间自动流转。
以Elasticsearch为例,推荐的配置策略是:
| 时间范围 | 存储介质 | 副本数 | 查询性能 |
|---|---|---|---|
| 近7天 | SSD热节点 | 1副本 | 秒级响应 |
| 7-30天 | 机械硬盘温节点 | 1副本 | 秒级到分钟级 |
| 30天以上 | 冷存储或对象存储 | 0副本 | 需要恢复索引 |
这个策略的核心逻辑是:越新的数据越值钱,查询频率也越高。 超过一个季度的日志,绝大多数团队的使用率极低,没必要占着高性能存储,倒排索引的段合并周期也要按时间窗口调整,热索引段合并频繁一点,冷索引段基本不合并。
第三步:检索语法和权限控制,要站在使用者的角度设计
日志平台上的查询界面,是给开发、运维、安全三个角色用的,不同角色的关注点不一样,检索语法要兼顾易用性和表达能力。
- 对于开发人员,最常用的是关键字搜索加时间范围过滤,比如
trace_id: 20260323104532 AND ERROR,这个语法要支持。 - 对于运维人员,需要支持基于字段的聚合分析,比如按IP统计请求量排名,按错误码看P99延迟趋势。
- 对于安全人员,需要关注登录日志中某个账号在短时间内的多次失败尝试,这类场景需要支持多条件组合查询和简单的统计函数。
权限控制方面,建议按业务线划分索引权限,开发只能查自己服务的日志,运维可以查全量,但删除和修改权限必须严格隔离。日志数据往往包含用户手机号、订单信息等敏感字段,存储加密和访问审计是刚需。
第四步:检索性能调优,让慢查询无处遁形
日志平台用着卡,多半不是硬件不行,而是查询逻辑有问题,排查慢查询时,首先要看是不是全量扫描如果查询语句没有带时间范围,引擎就得扫全量索引,再好的硬件也扛不住。
性能优化的常用手段有几种。
- 对高频查询字段建立索引,比如
trace_id、user_id,建立索引后查询速度能提升一个量级。 - 对日志信息中不需要参与查询的字段,开启
ignore_above限制长度,避免大字段打爆内存。 - 定期清理有问题的查询模式,比如某个开发天天用通配符开头查询,这类查询直接拒绝掉,引导用精确匹配替代。
日志系统建设成本怎么控制:从硬件到人力的全视角
聊成本绕不开两个维度:机器成本和维护成本,机器成本好算,无非是存储和计算资源的折算,维护成本才是隐性大头,一个日志平台能不能玩得转,取决于团队是否有人真正理解存储引擎的调优逻辑。
低成本起步的推荐组合
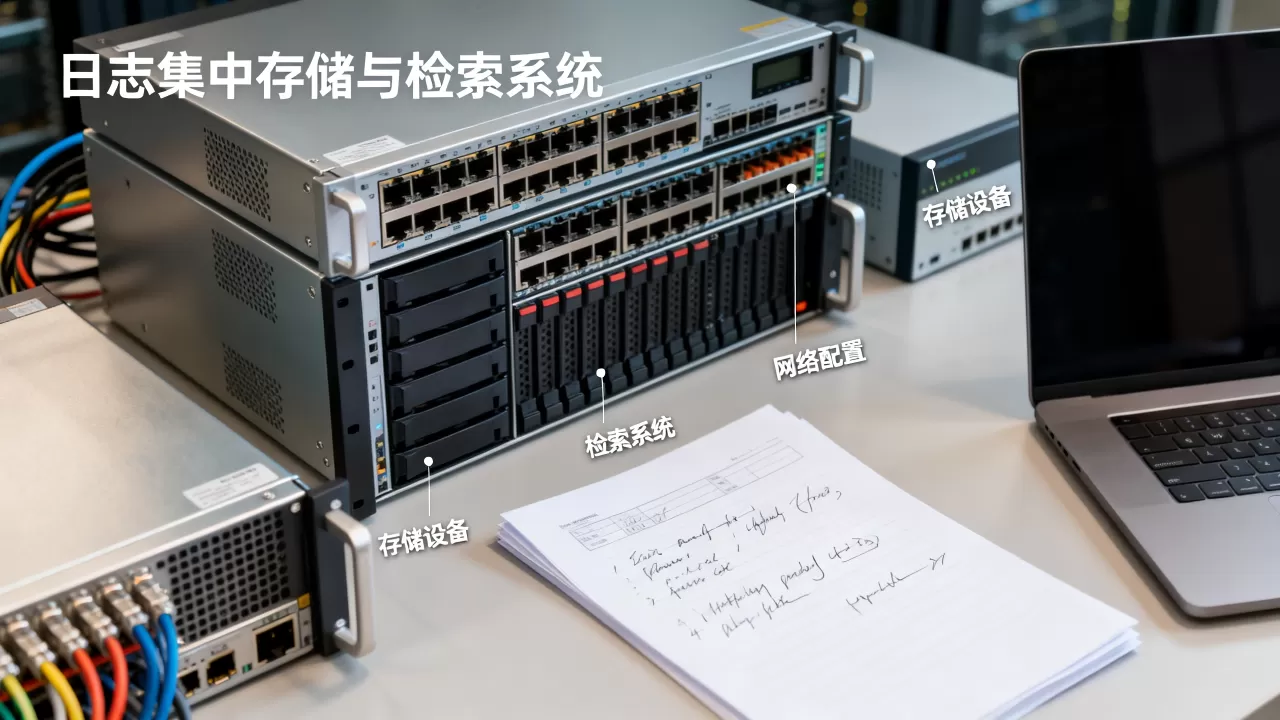
对于日写入量在100GB以内的团队,起步阶段不需要上三台高配机器,一个可行的方案是两台16核64G的服务器,跑Elasticsearch三节点(其中一个节点共用),再加一台4核8G的机器跑Kafka和采集端,这套组合的硬件成本控制在十万级别,能稳定支撑两三年。
云端托管和自建怎么选
- 如果团队没有专职ES运维经验,选云厂商的托管日志服务更划算,按量付费,不用操心集群扩容和版本升级,但要注意公网流量费用和索引存储单价,日志量大的时候,账单可能会吓你一跳。
- 如果团队有一定运维能力,且日志量长期稳定,自建反而更省钱,一台好点的物理机跑ES裸金属,性能比云主机同配置高出不少,唯一要搞定的是磁盘故障的保修响应时间。
日志存储与检索系统的常见问题详解
日志集中管理系统查询慢怎么办
先确认查询是否带了时间范围,再检查是否触发了全表扫描的语法,多数情况下,查询慢是因为日志字段没有做索引映射,或者使用了大字段的模糊匹配,建议先用_cat接口查看分片分布,确认数据是否倾斜,再做具体优化,如果是跨月查询,建议按天拆索引,用通配符匹配多索引查询。
日志存储天数一般保留多久
这个问题没有标准答案,取决于业务合规要求和排障场景,金融行业偏向保留半年以上,互联网公司普遍保留30天到90天,安全审计日志建议至少保留半年,超期数据可以归档到便宜的冷存储,需要时再恢复索引,所谓的热数据、温数据、冷数据之分,核心逻辑还是用钱换查询效率,若预算收紧,优先缩短热数据的天数,而不是砍掉冷归档备份。
日志采集端消耗业务机器的性能怎么办
采集端对CPU和内存的影响,往往被低估,Filebeat默认的吞吐配置偏高,在业务高峰时会抢占应用进程的资源,调整方向是限制采集端的CPU使用上限,合理设置批量写入的缓冲区大小,同时将采集端的日志级别调低,另外一个容易忽略的点是采集端自身的日志输出,别让它把日志写到与业务相同的磁盘分区上,否则容易触发磁盘IO瓶颈,系统建设完成后,日常巡检要重点关注采集端是否出现日志积压,这通常意味着消费端吞吐不足,此时需要横向扩容存储节点或优化写入批大小,而不是盲目调大采集端的并发数。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/635044.html