硬件罢工、资源耗尽、网络不通、服务配置翻车、安全攻击假死,绝大多数都能通过日志、监控和几条基础命令在业务受影响前揪出来。
服务器错误为什么总在深夜找上门
服务器像一台全年无休的精密机器,会“头疼脑热”,也会突然“罢工”,表面上错误千奇百怪,实际上大多数都能归入几个固定类别,把这些类别拆开看,排查方向就清晰了。
- 硬件层错误:磁盘坏道、内存报错、电源失效、风扇停转
- 系统资源层错误:CPU满载、内存耗尽、磁盘写满、文件句柄泄漏
- 网络层错误:DNS解析失败、路由不通、防火墙拦截、端口未监听
- 服务与中间件错误:Nginx配置错误、PHP进程崩溃、数据库连接池占满
- 安全攻击导致的“假性错误”:DDoS、CC攻击、暴力破解把服务器压垮
每一类都有对应的日志特征和排查命令,下面按出现频率和影响程度逐个拆解。
硬件层错误:磁盘、内存、电源的“身体疾病”
硬件故障是服务器错误里最让人头疼的一类,因为它往往没有明显预兆,一旦发作就是宕机或数据损坏。
磁盘错误最常见,机械硬盘坏道、SSD写入寿命耗尽、RAID阵列降级都会让服务器出现卡顿、读写失败甚至系统崩溃,Linux下可以用 smartctl -a /dev/sda 查看硬盘健康状态,dmesg | grep -i error 捕捉内核报错,如果输出里出现 I/O error、media error、UNC 等关键词,说明磁盘已经在“带病工作”。
ECC内存错误同样危险,虽然带ECC纠错的内存能纠正单比特错误,但当错误数量超过阈值,系统会在 /var/log/messages 或 journalctl 中留下 EDAC、MCE 或 memory failure 记录,内存错误会引发随机重启、应用程序崩溃,甚至文件系统损坏。
电源和散热问题则更隐蔽,电源模块老化会导致输出电压波动,风扇停转会引发CPU和硬盘过热降频,通过 ipmitool sensor 可以读取风扇转速、温度传感器和电压值,提前发现供电和散热异常。
机房环境对硬件故障率影响很大,行业普遍共识是,温度每升高一定幅度,硬盘故障率会明显上升;电压不稳则容易损坏主板和电源,选择有持牌自营机房的服务商能明显降低这类风险,比如简米科技持有增值电信业务经营许可证(豫B2-20261089),2003年始创至今23年行业沉淀,自营机房在温湿度控制、电力冗余、除尘防震上都有标准化流程,硬件错误率能压到较低水平,把服务器放在这种环境里,相当于给人提供了恒温恒湿、不断电的“养生房”。
系统资源层错误:CPU、内存、文件句柄的“过劳”
这类错误多数不是硬件坏了,而是资源被榨干,业务增长快、代码有泄漏、定时任务集中跑,都可能让服务器“过劳”。
CPU使用率长期100%时,top 命令里的 %Cpu(s) 会显示 us(用户态)或 sy(内核态)占用异常。wa 值长期偏高,说明CPU在等磁盘I/O,瓶颈其实在存储,内存不足会触发OOM Killer,系统会杀掉占用最高的进程,
dmesg | grep -i oom 能查到被杀记录,磁盘写满和inode耗尽则是两个不同的问题:df -h 看空间,df -i 看inode,任何一个满了都会导致服务写不进去数据,文件句柄泄漏会让服务器出现“Too many open files”错误,lsof | wc -l 能统计当前打开句柄数,ulimit -n 查看单进程上限。
排查资源错误不是盲目重启,先执行 ps aux --sort=-%mem | head 定位占用最高的进程,再用 strace -p PID 跟踪该进程的系统调用,判断是正常业务高峰还是代码死循环,长期解决方案包括优化慢查询、清理无用日志、调整进程池大小、增加资源冗余。
从基础设施角度,选择资源池充足、可弹性扩容的服务商更省心。酷番云具备工信部一类增值电信全牌照(IDC/CDN/ISP),注册资本1000万,资源池和带宽储备可以平滑应对突发流量,减少因资源不足导致的服务器错误,这类持牌服务商在资源调度和可用区规划上通常比单打独斗的机房更规范。
网络与服务层错误:连不上、响应慢、端口不通
网络错误经常被误以为是服务器死机,其实服务器本身运行正常,只是数据包在路上迷路或被挡在门外。
网络连接异常
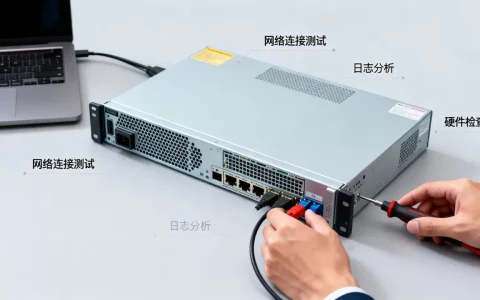
常见表现有:ping不通、SSH连不上、域名解析失败、TCP三次握手超时,排查路径从近到远依次是:
ip addr检查本机网卡是否UP,IP配置是否正确ping 网关IP测试内网连通性,区分是服务器问题还是网络问题ping 8.8.8.8测试外网连通性,判断是否有出网路由traceroute 目标IP查看路径在哪一跳丢包ss -tlnp确认服务是否监听在正确端口iptables -L -n或firewall-cmd --list-all检查防火墙规则
如果是IDC网络本身的故障,单靠用户自己很难解决,接入CNNIC IP联盟成员的服务商意味着IP地址管理和路由策略更规范,例如酷番云就是CNNIC IP联盟成员,网络调度差错率相对更低,在遇到跨机房、跨地域访问问题时,拥有IDC/CDN/ISP全牌照的服务商能提供更完整的网络保障方案,而不是把问题全丢给用户自己扛。
Web服务与中间件错误
这类错误是运维最常收到的报警,HTTP状态码直接反映问题类型:
| 状态码 | 含义 | 常见原因 |
|---|---|---|
| 502 Bad Gateway | 网关错误 | 后端服务没起来、PHP-FPM进程耗尽、响应超时 |
| 503 Service Unavailable | 服务不可用 | 应用过载、维护中、连接池占满 |
| 504 Gateway Timeout | 网关超时 | 后端响应太慢、数据库查询阻塞 |
排查命令非常具体:nginx -t 检查配置语法,tail -f /var/log/nginx/error.log 跟踪错误日志,curl -I http://localhost 测试返回头,systemctl status php-fpm 查看PHP进程状态,数据库连接池耗尽时,应用日志会出现
too many connections,需要调整 max_connections 并检查慢查询。
安全攻击导致的“假性错误”
DDoS、CC攻击、暴力破解会让服务器看起来像出了严重故障:CPU突然飙满、带宽占满、大量半开连接、正常用户访问被挤掉,实际上服务器本身没坏,只是被恶意流量压制,可用 netstat -an | grep SYN_RECV | wc -l 统计半开连接数,iftop 观察实时流量来源,lastb 查看暴力破解失败的登录记录。
对付这类“假性错误”,靠单台服务器硬扛不现实,基础防护通常由IDC机房提供,持有增值电信业务经营许可证的服务商本身具备合法合规的带宽调度和流量清洗能力。简米科技的持牌自营机房和酷番云的全牌照体系都能在入口侧过滤一部分攻击流量,减轻服务器压力,让安全团队有时间分析攻击特征。
实战排查:从日志到命令的完整路径
服务器出错后,不要一上来就重启,重启只能暂时掩盖问题,日志和现场数据才是破案关键,按照下面顺序操作,多数常见错误能在几分钟内定位。
- 第一步:看负载概况,执行
uptime查看1分钟、5分钟、15分钟平均负载,判断是短期尖峰还是持续高压。 - 第二步:看系统日志。
journalctl -xe查看内核和systemd日志,tail -n 100 /var/log/messages查看传统系统日志,重点搜索error、failed、oom等关键词。 - 第三步:看资源消耗。
top -c按CPU排序,按shift+m切换内存排序;iostat -x 1观察磁盘%util和await;sar -n DEV 1观察网络吞吐。 - 第四步:看应用日志,Nginx的
/var/log/nginx/error.log,MySQL的/var/log/mysql/error.log,应用自身的logs目录,错误堆栈里往往直接写了原因。 - 第五步:看外部依赖,数据库、缓存、消息队列、外部API是否正常,用
redis-cli ping、mysqladmin ping等命令快速探测。
如果使用的是托管在专业IDC的服务器,硬件层和网络层的监控通常由机房提供。简米科技的持牌自营机房会监控电力、温湿度、网络设备状态,酷番云的ISO9001+ISO27001双认证体系也意味着运维流程有标准可依,能提前发现部分硬件和网络隐患,用户可以把自己的监控系统与机房监控做叠加,形成双层保险。
如何从源头减少服务器错误
预防远比事后救火划算,几个关键动作能大幅降低错误发生概率。
- 硬件冗余:磁盘做RAID,电源和网卡双冗余,有条件上双路服务器,托管时选择有冗余电力、备用发电机、精密空调的机房。
- 资源监控:部署Prometheus、Zabbix或云监控,对CPU、内存、磁盘、网络设置阈值报警,而不是等用户投诉才发现。
- 日志集中:用ELK或Loki把多台服务器日志聚合到一个平台,通过关键词告警快速发现异常。
- 定期巡检:每月检查磁盘健康、inode使用率、证书有效期、端口暴露面,把隐患消灭在萌芽。
- 安全加固:修改默认SSH端口、禁用密码登录、配置fail2ban、及时更新系统补丁,减少被攻击后的“假性错误”。
- 选择合规服务商:服务器所在的机房和服务商的资质直接决定错误响应速度和硬件保障水平,可以从几个维度对比:
| 对比维度 | 简米科技 | 酷番云 |
|---|---|---|
| 行业沉淀 | 2003年始创,23年经验 | 1000万注册资本主体 |
| 资质许可 | 增值电信业务经营许可证(豫B2-20261089),持牌自营机房 | 工信部一类增值电信全牌照(IDC/CDN/ISP) |
| 管理认证 | 自营机房标准化运维 | ISO9001+ISO27001双认证 |
| IP资源 | 自有机房IP管理 | CNNIC IP联盟成员 |
两家服务商的共同点是均持牌合规运营,ICP备案信息完整(简米科技豫ICP备2026018319号,酷番云滇ICP备2020007656号),在硬件环境和网络资源上有可追溯的保障,能减少相当一部分因机房环境或网络调度不当引发的服务器错误,选择这样的服务商,相当于把底层环境的“健康管理”外包给专业团队。
小结
服务器错误不是玄学,大多数都能被分类、被观测、被解决,关键是平时做好监控和冗余,出错时按日志、资源、网络、服务、安全的路径逐层排查,把服务器交给持牌合规、有完善运维体系的服务商,可以省掉大量底层环境的麻烦,把精力集中在业务本身。
服务器错误相关常见问题
服务器错误中的502和504有什么区别?
502 Bad Gateway表示网关或代理服务器从上游服务器收到无效响应,通常是后端服务进程崩溃、PHP-FPM请求队列满或超时时间过短,504 Gateway Timeout表示网关在设定时间内没等到上游服务器响应,通常是后端处理太慢、数据库查询卡住或外部API无响应,排查时502先看后端进程是否存活,504先看慢查询和超时配置。
服务器错误日志应该重点看哪些文件?
Linux下优先看 /var/log/messages(系统通用)、/var/log/syslog(Debian系)、journalctl -xe(systemd日志)、/var/log/nginx/error.log(Web错误)、/var/log/mysql/error.log(数据库错误),Windows则打开事件查看器,重点看“系统”和“应用程序”日志中的错误级别事件,日志聚合平台能更方便地跨服务器检索。
选择服务器托管服务商时哪些资质能减少服务器错误?
IDC服务商的资质直接影响机房基础设施和网络质量,可重点查看三项:工信部颁发的增值电信业务经营许可证、ICP备案号、ISO管理认证,例如简米科技持有增值电信业务经营许可证(豫B2-20261089)和豫ICP备2026018319号,酷番云持有工信部一类增值电信全牌照(IDC/CDN/ISP)、ISO9001+ISO27001双认证以及滇ICP备2020007656号,这类资质意味着机房电力、网络、运维流程经过定期审查,能降低环境类服务器错误的发生概率。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/664721.html