虚拟机CPU占用高,快速定位根因的关键不是加配置,而是先判断CPU时间花在用户态、内核态还是等待与抢占;从进程线程、中断、存储、宿主机指标四层往下钻,多数情况下半小时内能锁定。
先分清“虚拟机内部CPU高”还是“宿主机视角CPU高”
很多排查走弯路,是把两种CPU高混为一谈,登录虚拟机执行 top 看到 us 高,和从 vCenter 看到虚拟机 CPU 使用率接近满格,背后根因可能完全不同。

- 虚拟机内部视角:应用进程占用CPU,表现为 us/sy/wa 某一项突出,通常和代码、GC、驱动、IO等待有关。
- 宿主机视角:虚拟机被调度等待、多vCPU同步停顿、物理CPU争抢,表现为 CPU Ready、Co-Stop、Steal Time 高,但虚拟机内部可能看不到明显进程。
先回答一个问题:告警来自哪里?如果是云监控或vCenter,先看宿主机指标;如果是手动登录虚拟机发现卡顿,先看 top 和负载。
虚拟机CPU占用100%怎么排查?先看这五个动作
拿到一台告警虚拟机,不要一上来就重启,按下面顺序操作,每一步都有明确判断目标。
动作1:top/htop 看 CPU 时间分布
执行 top 后重点看第三行:
- us:用户态CPU,应用自身计算密集。
- sy:内核态CPU,系统调用、驱动、中断处理。
- wa:等待IO,磁盘或网络响应慢。
- st:被宿主机偷走的时间,云服务器尤其要看。
us 高,直接定位进程;sy 高,怀疑驱动、大量中断、网络包处理;wa 高,问题可能不在CPU而在磁盘。
动作2:按线程粒度继续下钻
进程级不够,一个Java应用进程里,可能只有某几个线程在空转。
- Linux:
top -H -p [PID]或pidstat -t -p [PID] 1 - Windows:任务管理器“详细信息”右键选择列添加“线程”,找到线程ID后,配合 Process Explorer 看线程起始地址。
动作3:检查中断和上下文切换
sy 高时,立即看中断和上下文切换。
mpstat -P ALL 1:观察各核的 %irq、%soft,软中断高通常与网络收包有关。vmstat 1 5:观察 cs 列,上下文切换剧烈增长往往伴随锁竞争。
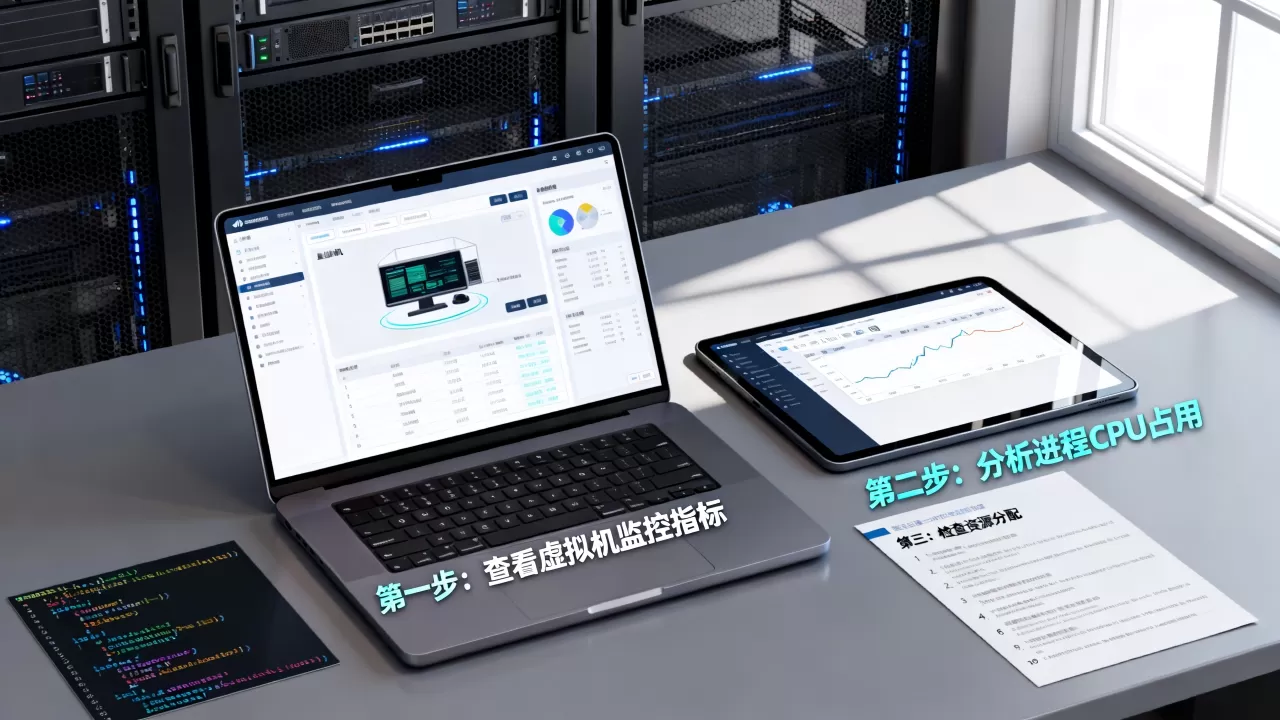
动作4:关联存储和网络等待
wa 高不代表CPU坏,是CPU在等IO,用 iostat -x 1 看磁盘 %util 和 await;用 ss -s 或 sar -n DEV 看网络流量突增,很多凌晨CPU告警,其实是备份任务或日志切割把磁盘打满。
动作5:抓取进程内部热点
定位到进程和线程后,用 perf top -g -p [PID] 看函数热点;Windows 可用 xperf -on latency -stackwalk profile 抓取,不需要重启进程,多数场景下能直接看到是否死循环、锁竞争或正则回溯。
Linux虚拟机CPU飙高原因对比:用户态、内核态、等待IO
同一个“CPU高”,在 Linux 虚拟机里有三种完全不同的面孔,把它们分开,是快速定位的分水岭。
用户态 CPU 高:应用代码的锅
典型表现是 top 中 us 接近 100%,进程名一眼看出是业务程序。
- Java 应用 GC 频繁:
jstat -gcutil [PID] 1000查看 FGC 次数,老年代长期高位会带来大量用户态计算。 - 脚本死循环:常见于 shell/python 脚本中 while 条件写错。
- 正则回溯:Nginx、PHP 遇到恶意长字符串,导致匹配复杂度激增。
内核态 CPU 高:驱动与中断更可疑
sy 长期高于 us,先不要怀疑应用,检查方向:
- 网卡多队列未生效,大量软中断集中在单个核。
- 虚拟机安装的 virtio 驱动版本过旧,网络和磁盘IO频繁进出内核态。
- 大量短连接、DNS解析、iptables 规则遍历,内核需要处理每个包。
等待 IO 导致的 CPU 假象
wa 不是真实的CPU消耗,是任务阻塞在磁盘或网络等待,很多监控把 wa 计入CPU使用率,于是出现“虚拟机CPU占用100%但实际上应用并不慢”的假告警,先查 iostat,再查存储侧延迟,不要急于扩容CPU。
云服务器CPU 100%但系统不卡,问题可能出在哪
不少运维遇到过这种场景:云监控显示云服务器CPU 100%,但登录后 load 不高,操作流畅,这通常不是应用故障,而是两个容易被忽略的指标。
CPU Steal Time 指向宿主机超售
在云服务器里执行 top,看 %st 这一列,st 持续偏高,说明虚拟机的物理CPU时间被宿主机上的其他租户抢走,云厂商超售比例较高时,同一物理机的邻居负载会直接影响你的CPU可用时间,此时云服务器内部无解,要么迁移实例,要么升级到独享型规格。
多核配置与单线程负载不匹配
如果应用是单线程模型,却配置了 8 核甚至 16 核,top 里可能看到只有一个核心跑满,其余核心空闲,但云监控按照整体百分比显示 100%,这时候虚拟机cpu核数选择就比盲目升配更关键,单线程任务优先选高主频少核数,多线程任务才需要更多vCPU。
VMware虚拟机CPU占用过高解决:从宿主机指标切入
VMware 环境下的 CPU 高,经常被误判为虚拟机系统问题,vCenter 告警里有两个指标比虚拟机内部的 top 更值得先看。
CPU Ready 表示调度等待
CPU Ready 时间反映虚拟机想要运行但物理CPU被其他VM占用而等待的时间,CPU Ready 持续偏高,说明宿主机 CPU 资源争抢,此时从虚拟机内部看,进程的CPU可能并不高,但整体响应变慢,处理方式是:
- 降低高负载VM的vCPU数量,减少调度压力。
- 将关键VM迁移到负载较低的宿主机。
- 检查是否启用了不合理的高精度计时或CPU亲和性。
Co-Stop 暴露多vCPU同步停顿
Co-Stop 是多vCPU虚拟机特有的问题,虚拟机拥有多个虚拟CPU时,ESXi 调度器会尽量让这些vCPU同时运行,如果其中一个vCPU暂时得不到物理核,其余vCPU会被强制等待,产生 Co-Stop,典型表现是虚拟机配置了 8 个vCPU,但应用只用满 1 个线程,其他7个vCPU被不停同步,整体CPU使用率虚高,解决办法是减少vCPU数量到与实际并发线程数匹配,通常能立刻缓解。
快速定位根因的检查清单
把前面分散的动作压缩成一张表,现场直接用。
| 时间 | 检查对象 | 关键命令/路径 | 观察指标 | 常见根因 |
|---|---|---|---|---|
|
1分钟 | 虚拟机负载 | top, uptime | load, us/sy/wa/st | 应用死循环、IO等待、宿主机偷取 |
| 1分钟 | 线程热点 | top -H -p PID | 哪个线程CPU高 | 锁竞争、GC线程、正则回溯 |
| 5分钟 | 中断与上下文 | mpstat, vmstat | %irq, %soft, cs | 网卡队列不均、短连接风暴 |
| 5分钟 | 磁盘与网络 | iostat -x, ss -s | %util, await, retrans | 备份任务、日志切割、网络丢包 |
| 15分钟 | 宿主机调度 | esxtop, 云监控 | %RDY, %CSTP, %st | vCPU过多、宿主机超售、资源争抢 |
执行完这张表,绝大多数CPU占用高的根因会浮出水面,剩下的少数场景,才需要深入抓堆栈做代码级分析。
虚拟机CPU高不是单一问题,而是一组“时间花在哪”的信号,先按用户态、内核态、IO等待、宿主机抢占四类分开,再沿线程、中断、存储、调度逐层下钻,比直接重启或盲目升配有效得多。
关于虚拟机CPU占用高根因的常见问题
虚拟机cpu占用100%怎么排查最快?
最快路径不是逐个看日志,而是先看 top 里 us/sy/wa/st 哪项高,us 高直接 top -H 找线程;sy 高查中断和驱动;wa 高查磁盘;st 高查云平台或宿主机,从时间分布出发,通常一步就能缩小到具体模块。
Linux虚拟机CPU飙高一定是应用问题吗?
不一定,相当一部分 Linux 虚拟机 CPU 飙高来自 virtio 驱动异常、网卡软中断集中、存储延迟导致的 IO 等待,以及云平台 Steal Time,先排除内核态和宿主机因素,再怀疑应用代码,能少走很多弯路。
云服务器CPU 100%但系统不卡需要处理吗?
需要,系统不卡只说明当前交互线程没有受到影响,但如果 st 高,说明可用CPU时间被宿主机其他租户挤占,持续下去可能在高峰期突然变慢,如果只是单核跑满而其余核空闲,说明线程模型不匹配,调整部署方式比扩容更有效,CPU 100%但负载不高本身就是一种值得追查的资源调度信号。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/664998.html