青岛租用GPU服务器当然可以用来做模型训练,对多数中小团队和个人开发者来说,租用比自建机房更实际,关键是要选对卡型、网络和供应商。 本地用CPU跑模型跑到怀疑人生的日子,租一台青岛机房的GPU服务器就能直接拉开效率差距。
青岛租用GPU服务器做模型训练到底行不行?
行,GPU服务器说穿了就是一台装了独立高性能显卡的远程电脑,青岛机房把它托管在恒温恒湿的环境里,你通过SSH连上去操作,训练模型时,计算发生在青岛机房的物理显卡上,本地只负责传指令和收结果,所以从技术链路看,青岛租用GPU服务器做模型训练和把主机放在隔壁房间没有本质区别。
真正的差异不在“能不能”,而在“怎么选”,下面按训练任务拆开看。
哪些训练任务适合放上青岛的GPU服务器
- 小模型微调:比如BERT、GPT-2、LLaMA-7B以下的开源模型,单卡24GB显存基本能跑,租一台消费级4090或者专业级A10就够了。
- 中型模型预训练:显存需求超过48GB,或者需要多卡并行,这种场景更适合租A100、H100这类数据中心卡。
- 推理服务部署:训练完成后做线上API或批量推理,对显存要求低于训练,但更看重带宽和稳定性,青岛本地机房对北方用户访问延迟较低,适合做区域推理节点。
本地机房和一线城市机房有多大区别
很多用户担心青岛本地算力不如北上广。业内专家指出,机房物理位置对训练任务的影响,远小于网络线路和硬件新旧程度,只要青岛机房提供BGP多线接入,延迟就能控制在可接受范围,你在北京用SSH连青岛服务器,正常操作和查看日志几乎没有体感差别。
真正要对比的是硬件配置和运维响应,一线城市机房选择多、高端卡上架快,但青岛部分老牌IDC也有A100/H100资源,且价格竞争更充分,做模型训练,优先关注显卡型号、显存、CPU主频和存储类型,而不是机房在哪个城市。
青岛GPU服务器租用价格与配置怎么选?
租GPU服务器训练模型划算吗?先算三笔账
很多人在“租”和“买”之间反复横跳,我们用具体场景算账。
- 硬件折旧账:一张全新A100 80GB显卡价格不低,日常训练可能只用三个月,买回来闲置就是资产浪费,租用可以按月或按小时付费,项目结束就释放。
- 电费散热账:高性能GPU满载功耗很高,家里或办公室的电路、散热、噪音都是问题,机房提供专用电力、精密空调和UPS,这部分隐性成本租用已经包含。
- 时间维护账:自己装机、装驱动、排查硬件故障,随便折腾掉两三天,租GPU服务器训练模型划算吗?算上自己的时间成本,多数情况下租用更省心。
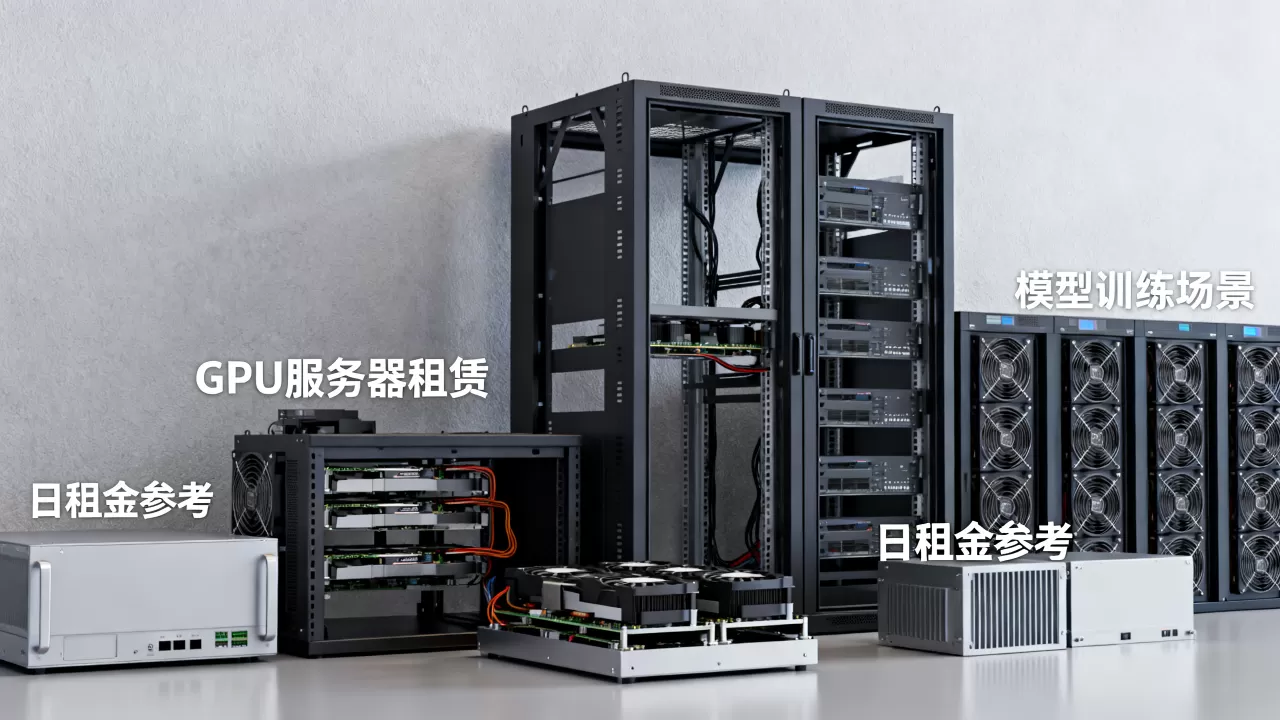
常见GPU型号怎么挑
拿深度学习训练GPU服务器配置来说,显存大小是第一道门槛,但不是唯一标准。
| GPU型号 | 显存 | 适合任务 | 租赁定位 |
|---|---|---|---|
| RTX 4090 | 24GB | 小模型微调、图像生成 | 性价比高 |
| A10 | 24GB | 中小模型训练、推理 | 中端均衡 |
| A100 40GB | 40GB | 中型模型单卡训练 | 专业级 |
| A100 80GB | 80GB | 大模型微调、多卡并行 | 高端首选 |
| H100 | 80GB | 超大规模训练 | 顶级算力 |
选卡别只盯显存,显存带宽、NVLink支持、CPU单核性能都会影响训练速度。行业共识认为,单卡训练中小模型仍是性价比最高的起步方式,不要一上来就组多卡,先把单卡跑通再扩。
青岛GPU服务器租用价格大概在什么区间
价格受卡型、租期、带宽、存储类型影响,波动较大,消费级卡如4090的租用价格通常在每小时几元到十几元,月租从几百元起步,专业级A100 80GB按小时租,价格会上一个台阶,月租数千元不等,H100资源更稀缺,价格最高。
青岛本地机房的优势在于,部分供应商会提供北方线路优化和带宽优惠,下单前一定问清楚:报价含不含公网IP、带宽是共享还是独享、系统盘和数据盘是否额外计费。
租到服务器后的实际操作路径
拿到青岛GPU服务器的root权限后,别急着上传数据,先把环境打通。
环境配置三步走
第一步,确认显卡和驱动状态。
nvidia-smi
正常会显示显卡型号、显存占用和驱动版本,如果提示找不到命令,先安装NVIDIA驱动。
第二步,创建独立Python环境。
conda create -n train python=3.10 -y
conda activate train
第三步,安装对应CUDA版本的PyTorch。
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121
CUDA版本要和驱动匹配,不要无脑装最新版,安装完成后用python -c "import torch; print(torch.cuda.is_available())"验证,返回True才算通。
数据上传与训练启动
训练数据通常放在本地,用scp或rsync上传到服务器。
scp -r ./dataset root@服务器IP:/data/
大文件建议先打包再传,避免小文件传输慢,上传完成后,用tmux或screen保持会话,防止SSH断开导致训练中断。
tmux new -s train
python train.py --epochs 50 --batch-size 16 --output-dir ./checkpoints
训练过程中按Ctrl+b再按d脱离会话,训练会继续在后台跑。
断点续训与资源监控
长时间训练必须开断点续训,主流框架如PyTorch、Hugging Face Transformers都支持保存checkpoint,每次epoch结束后保存模型权重,中断后从最近的checkpoint加载继续跑。
实时监控显存和温度,用watch配合nvidia-smi。
watch -n 1 nvidia-smi
如果显存占用一直顶满,说明batch-size设大了;如果GPU利用率长期低于50%,要检查数据加载是否成为瓶颈。
青岛GPU服务器哪家好?四个细节别忽略
“青岛GPU服务器哪家好”这个问题没有标准答案,但选错供应商的代价往往是训练白跑,以下四个细节比价格更重要。
网络延迟与带宽
训练时SSH操作需要低延迟,数据上传需要大带宽,下单前用ping测试机房IP,延迟最好控制在30ms以内,上传速度也要实测,10GB数据如果传两个小时,再好的显卡也白搭,问清楚是否为BGP多线、独享带宽还是共享带宽。
数据安全与备份
训练数据和模型权重是你的核心资产,租用前确认机房是否提供磁盘快照、是否支持定期自动备份,合同中最好写明数据归属,避免到期后数据被清理无法找回,近几年青岛本地数据中心在等保和数据安全方面的整改力度不小,选择有资质的服务商更有保障。
故障响应速度
GPU训练中遇到显卡掉卡、显存报错、驱动崩溃并不罕见,供应商是否提供7×24小时工单响应,硬件故障能否快速换卡,直接影响训练进度,别只看售前客服热情,要问清故障处理SLA。
是否支持灵活计费
短期测试按小时计费,长期训练按月租用,两种模式单价差异很大,如果只是跑几天验证模型,选按时计费;一旦确认要持续训练,切换成月租能省下不少成本,确认是否支持随时升降配置,避免被绑定在固定卡型上。
两个容易踩的误区
显存大不等于训练快
不少用户以为租到80GB显存就万事大吉,如果只是跑一个几亿参数的小模型,80GB卡和24GB卡的训练速度可能相差不大,因为显存没有吃满,真正影响速度的还有显存带宽、CPU数据预处理速度、磁盘IO,租用前先用nvidia-smi和iostat测一下,把瓶颈找出来再下单。
多卡并行需要额外优化
单卡跑不动就上多卡,逻辑没错,但多卡训练不是简单把batch翻倍,分布式训练要配置NCCL、梯度同步、数据并行或模型并行,通信开销会抵消一部分算力提升,两张A100 40GB做数据并行,实际加速往往不到2倍,先把单卡调通,再考虑多卡,这是更务实的路径。
青岛租用GPU服务器做模型训练,可行性没有任何疑问,真正的门槛在于配置选型、环境搭建和供应商筛选,把这几个环节抓实,模型训练就不会卡在算力这一步。
Q&A
青岛租用GPU服务器训练模型需要什么配置?
起步阶段建议选24GB显存以上的显卡,比如RTX 4090或A10,搭配16核以上CPU、32GB内存和SSD系统盘,如果训练参数量超过7B,显存需要提升到40GB甚至80GB,优先选A100,存储方面,数据盘容量按训练集大小预留2到3倍空间,方便保存checkpoint和日志。
租GPU服务器训练大模型划算吗?
要看使用频率和周期,短期项目按小时租用A100或H100,比一次性采购硬件划算得多,长期训练月租会摊薄单小时成本,但总支出仍然低于自建同等级算力平台的购卡、电费和运维开销,对于大多数团队,租GPU服务器训练大模型是更灵活的选择。
青岛GPU服务器可以跑深度学习吗?
可以,只要服务器带NVIDIA独立显卡、管理员权限、可安装CUDA和PyTorch等框架,就能跑深度学习训练和推理,青岛本地机房提供的GPU服务器和一线城市机房在软件环境上没有区别,连上SSH后安装对应驱动即可开始训练。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/666653.html