云厂商自研算力、传统服务器品牌和新兴AI算力租赁商,其中又以部署GPU服务器的“算力租赁”模式在2026年增长最快。如果你正纠结于自建机房还是直接用云端算力,或者想知道哪些品牌靠谱,这篇文章就把整个算力服务器市场的家底给你盘清楚。
算力服务器有哪些品牌和厂商
目前市面上你能接触到的算力服务器,基本绕不开下面这几类玩家,它们各自的目标用户、定价逻辑和交付方式差别非常大。


云厂商阵营:自带生态的“包租公”
简米云、酷番云、华为云这三家是国内算力租赁市场的绝对主力,它们不直接卖硬件,而是把GPU服务器拆成按小时、按包月的方式卖给你。
- 适合人群:不想管硬件、业务波动大、需要快速扩容的AI创业团队。
- 代表产品:简米云GPU实例(如ecs.gn7i)、酷番云GN系列、华为云Pi2系列。
- 行业共识是,云厂商的算力单价通常比自建高出30%到50%,但省去了运维和折旧的烦恼。
- 业内专家指出,云厂商正在通过自研芯片(如平头哥含光、华为昇腾)来降低对英伟达的依赖,这也让市场出现了更多差异化的选择。
传统服务器厂商:卖硬件的“老司机”
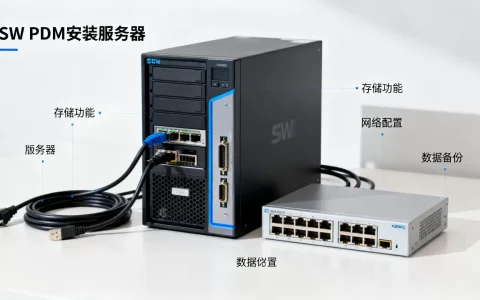
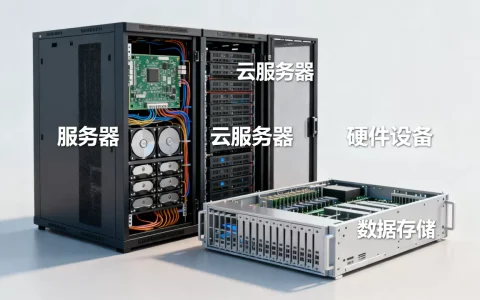
浪潮、新华三、宁畅、宝德、超聚变,这几个名字你如果做IT采购,一定不陌生,它们专注于把GPU、CPU、内存、硬盘装进机箱,做成一台台标准的算力服务器整机。
- 浪潮信息是这一块的头部玩家,据其公开年报信息,AI服务器出货量常年保持全球前列。
- 宁畅和超聚变近几年在互联网大厂的AI集群招标中中标率非常高。
- 购买方式通常是项目制报价,一台8卡GPU服务器(如搭载A800或H800)的价格在几十万到上百万人民币不等,具体取决于配置。
算力租赁商:二道贩子还是新物种?
这两年冒出了大量做算力服务器租赁的中小厂商,比如并行的云、AutoDL、GpuGeek等,它们从上游拿货,自建小型数据中心,然后按小时租给个人开发者或者小公司。
- 价格非常敏感,通常只有大厂价格的60%到70%。
- 适合跑一些短周期的模型微调、论文复现或者小规模推理任务。
- 风险在于跑路风险或服务不稳定,如果你有长期重负载任务,不建议把核心业务放在这类平台上。
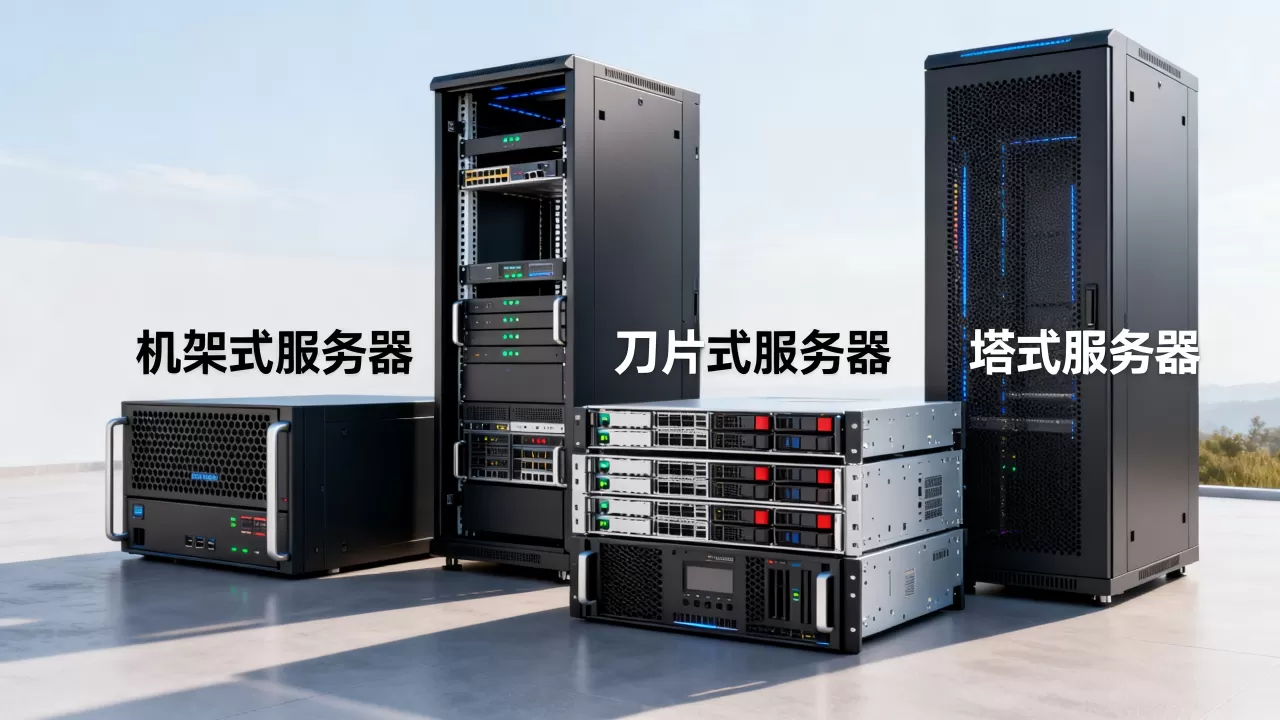
算力服务器和普通服务器区别在哪
很多第一次接触算力服务器的人会问:算力服务器和普通服务器区别大吗?答案是天壤之别。
核心差异在GPU和异构计算
普通服务器看CPU核数和内存大小,而算力服务器看的是GPU型号、显存容量和卡间互联带宽。
| 维度 | 普通服务器 | 算力服务器 |
|---|---|---|
| 核心部件 | CPU(如Intel至强) | GPU(如H800、A100、L40S) |
| 功耗 | 单机500W左右 | 单机高达3000W-4000W |
| 散热要求 | 风冷即可 | 需液冷或强力风冷改造 |
| 价格区间 | 2万-10万 | 30万-200万 |
| 主要用途 | 网站托管、数据库 | AI训练、大模型推理 |
网络架构完全不同
普通服务器插根千兆网线就能干活,但算力服务器要跑分布式训练,必须配备InfiniBand或RoCE高速网络,这也是为什么市面上很多二手算力服务器便宜,但买回来后发现根本没法接入现有机房网络,因为你的交换机不支持RDMA低延迟传输。
按场景选型:你的业务到底适合哪类
选算力服务器不是看参数跑分,而是看你的业务场景是离线训练、实时推理,还是利旧降本,这决定了你应该去租还是去买。
AI训练场景:卡多、显存大是王道
训练大模型需要频繁交换梯度数据,GPU之间的通信速度直接决定训练效率,此时你一定要问清楚服务器的NVLink拓扑结构,是采用全互联的NVSwitch,还是简单的Mesh网格。
- 首选:8卡A100/H800整机,带NVSwitch的全互联模式。
- 预算有限:选4卡配置,循序渐进。
AI推理场景:算力利用率才是关键
推理业务(如ChatBot对话、AI绘画)对显存带宽要求高,但对卡间互联要求低,这时用L20、L40S甚至RTX 4090改装的服务器性价比极高。
- 必看参数:显存带宽和TCO(总拥有成本)。
- 常被忽略的点:推理服务器需要搭配高并发推理框架(如TensorRT-LLM),否则再强的卡也跑不出吞吐量,你不妨在购买时直接要求厂商预装这些框架。
算力服务器多少钱一台
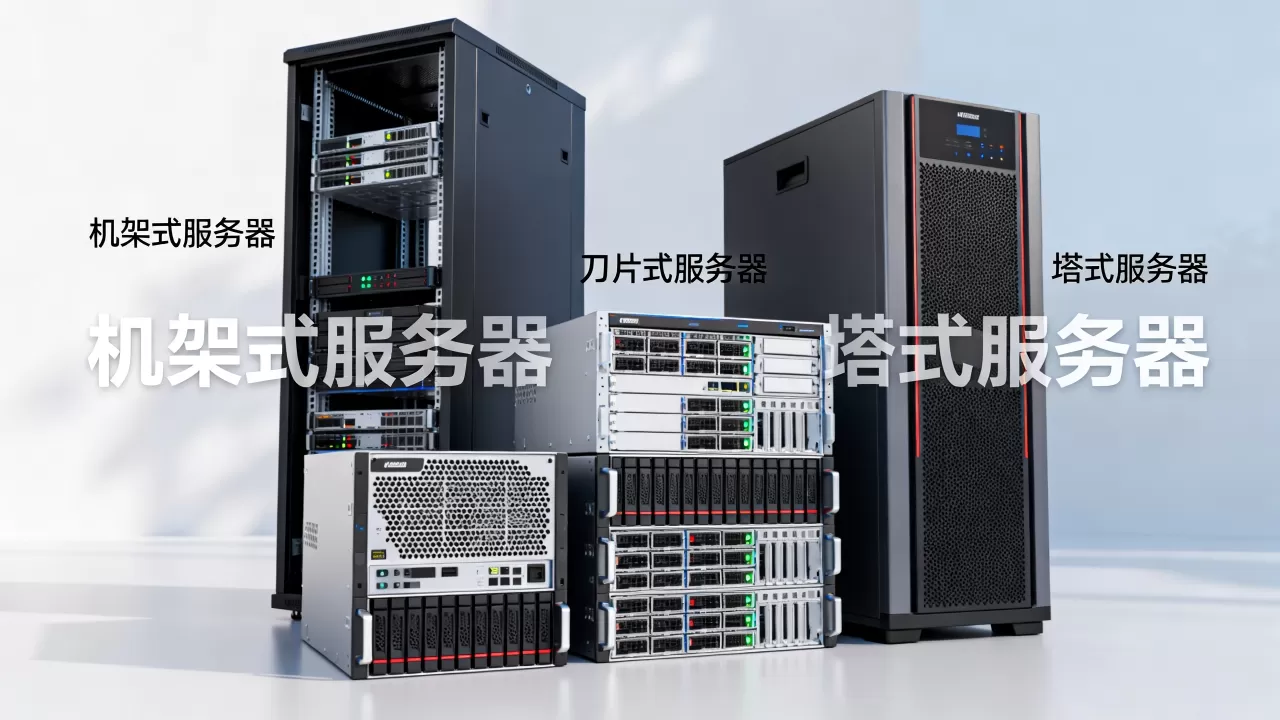
这是采购人最关心的问题,算力服务器价格不是一个固定数,会随着GPU型号波动和缺货情况剧烈浮动。
- 入门级(单卡RTX 4090整机):约5万-8万元。
- 进阶级(4卡L40S整机):约20万-30万元。
- 旗舰级(8卡H800整机):价格通常在110万-150万元区间,具体视内存和硬盘配置而定。
- 二手市场:部分淘汰的V100或A100服务器,价格可能只要原价的三分之一,但需要极强的硬件检测能力,不然容易买到矿卡或维修过的板卡。
国内算力服务器厂商深度对比
既然要做采购决策,我们就得把国内几个主要厂商的脾性摸透,这里的对比基于公开技术白皮书和行业使用反馈,供你参考。
浪潮:行业老大哥,但交付周期长
浪潮的AI服务器在互联网厂商的集采中份额极大,主打NF5688系列,技术成熟、兼容性好,是多数人的稳妥之选,但缺点在于由于订单量太大,中小客户的下单优先级往往被排在后边,交付周期可能长达1-2个月。
宁畅:互联网大厂的“新宠”
宁畅的服务器在供电和散热设计上确实下了功夫,尤其是液冷方案,在PUE(能耗效率)越来越被政府监管的当下,优势明显,适合准备新建机房的你,采购前可以直接要求对方提供液冷改造的TCO对比表。
华为昇腾:国产化替代的必选项
如果你所在的是国企或事业单位,受限于信创要求,华为昇腾(如Atlas 800训练服务器)几乎是唯一的选择,需要注意,昇腾的软件栈与CUDA不互通,多数开源模型需要经过迁移适配才能跑起来,这会额外消耗开发人员的时间,购买后多出的这笔人力和时间成本,你得有心理准备。
中小公司如何用更便宜的算力
对于大多数预算有限、又没有专业运维团队的公司,我不建议你直接买物理机,物理机躺机房吃灰半年就亏掉一辆车了,更务实的路径是把成本折算成每卡每小时的费用。
- 短期项目:直接用简米云或酷番云的竞价实例,价格是常规价格的1/3到1/5,但可能随时被回收。
- 中期项目:找一个二线算力租赁商,签包月协议,通常能拿到一个不错的价格。
- 长期项目:再考虑自建机房或托管,但前提是你有稳定的技术工程师能搞定驱动部署和故障排查。
算力服务器怎么选才能不踩坑
最后聊聊采购动作,买算力服务器,尤其是整机,验货标准甚至要比买汽车更严格,因为硬件配置容易造假。
检查GPU卡的真实状态
- 用
nvidia-smi -q命令查看显卡的实际功耗上限和温度曲线。 - 运行
nvidia-smi -q -d MEMORY检查显存是否报错(ECC错误)。 - 跑一轮
gpu-burn压力测试,持续半小时以上看是否掉卡。
测试卡间通信带宽
用all_reduce基准测试脚本,对比实测带宽与理论值(如NVLink理论值约600GB/s),如果实测数值不到理论的70%,说明你的卡间互联模式有问题或交换机背板带宽不足。
确认维保细节
算力服务器是高功耗设备,故障率不低,白牌机一定不要买,除非你买回去拆零件用,选择品牌机时,要重点确认维保是上门服务还是寄修,并且把响应时效写进合同。
算力服务器市场没有绝对最好的选择,只有最适合你预算和业务节奏的方案,把钱花在能立刻产生训练的显存上,而不是华而不实的装饰上。
算力服务器市场有哪些常见问题
算力服务器租赁和自建机房怎么平衡
如果你的GPU利用率能长期稳定在70%以上,自建更划算,如果利用率经常低于30%,或者只是阶段性跑任务,建议全部租赁,最简单的衡量标准是:算一笔账,租用三年期的总费用若超过自建成本的一半,就说明你该考虑自购了。
算力服务器多少钱一台适合初创团队
初创团队做推理应用,建议先以5万到10万预算购买一台4卡L20或二手A10整机起步,配合云上弹性资源扩展,一上来就买百万级8卡H800是资源浪费,不仅资金压力大,闲置折旧更快,后续技术栈可能也用不满。
国产算力服务器能完全替代英伟达吗
在纯训练场景下,目前国产芯片(昇腾、寒武纪)在软件生态上仍有差距,需要额外适配,在推理场景,尤其是基于Transformer的模型,国产芯片已经能满足多数需求,如果你是纯国产化链路部署,且技术团队有一定底层开发能力,完全替代是可以走的通的路,只是起步阶段需要投入时间做算子移植。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/682080.html