服务器双CPU坏了一个,核心结论是:系统仍可开机运行,但会失去一半算力并伴随内存带宽减半、PCIe通道缩减,不建议长期带病运行,应尽快定位故障CPU并安排更换。
先别急着下单,怎么确认是CPU真的坏了
双路服务器报错,很多人第一反应是CPU烧了,但实际情况里,内存接触不良、主板CPU座弯针、电源供电波动都会模拟出“CPU故障”的假象,直接买新CPU回来换上,结果问题依旧,这种事在运维圈太常见了。
看BMC/IPMI日志里的关键事件
所有服务器都有带外管理系统,开机后按Ctrl或Del进BMC界面,或者直接登录IPMI管理口,重点看这几类事件:
- CPU Internal Error(CPU内部错误):这属于最严重的硬件级报错,基本可以判定CPU本身出问题
- Machine Check Exception(MCE,机器检查异常):Linux系统下会记录在
/var/log/mcelog,Windows下看事件查看器“WHEA-Logger”来源的报错 - Thermal Trip(温度触顶):如果事件记录里频繁出现温度过高触发降频或关机,那更像散热问题而非CPU损坏
如果日志里有明确指向某个CPU Socket的报错,Processor 1 IERR”,那基本锁定位置了。
用排除法做二次确认
这一步很土但很有效,尤其在CPU故障和主板故障边界模糊的时候:
- 关机断电,把报错的那颗CPU拆下来,只保留一颗CPU和对应通道的内存
- 开机看能否正常进入系统
- 再关机,把另一颗CPU装回刚才的位置,拆下原来正常的CPU
- 再次开机测试
如果第一颗CPU能点亮机器、第二颗CPU点不亮或者报错依旧,那结论就清晰了:后装的这颗是坏的,如果两颗都能单点点亮,那问题可能出在主板插槽或共用组件上。
观察系统识别状态
进入操作系统后,Windows打开任务管理器-性能,Linux执行lscpu或cat /proc/cpuinfo,看CPU总数是不是只剩下一半,同时用dmidecode -t processor查看每颗CPU的“Status”字段,如果显示“Unpopulated”或者直接缺了一颗,说明系统物理层面已经没识别到那个CPU。
双CPU服务器坏一个,系统在经历什么
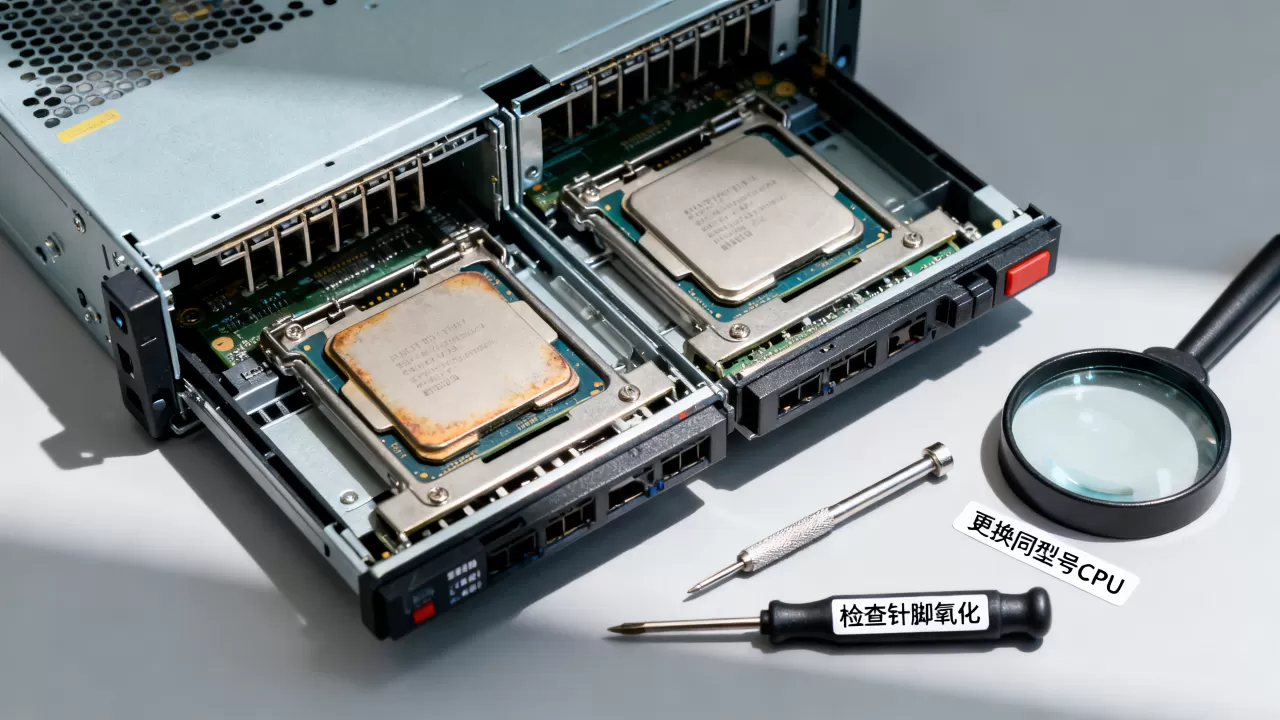
坏一个CPU不代表整机罢工,但你的服务器正处于“半残”状态,这不是简单少一颗CPU的问题,整机架构的很多资源都是和CPU绑定的。
内存带宽直接砍半
双路服务器的内存插槽通常按CPU分属两组,每个CPU管理一半内存通道,坏了一颗CPU,等于这一半内存全部不可用,即使你插了满配内存,系统也只能用另一半。
行业共识认为,内存带宽减半对数据库查询、虚拟化集群这类内存敏感型业务的冲击,甚至比CPU算力减半更明显,因为内存带宽决定数据吞吐的上限。
PCIe通道和外围设备受影响
NVMe硬盘、GPU加速卡、万兆网卡这些设备,插在哪个CPU的PCIe通道上,就由哪个CPU管理,如果坏的是管理这些设备的CPU,对应的硬件就会从系统里消失,有时候你发现服务器网卡突然没了、阵列卡认不到盘,排查到最后其实是CPU挂了。
性能降级是必然的
别指望系统能“智能分配”所有负载到剩下的那颗CPU上,很多双路服务器在单CPU模式下,内存访问延迟会显著增加,因为原本NUMA(非统一内存访问)架构下本地内存访问的优化机制已经失效,跑分数字会很难看,有时候性能损失远超50%。
换新CPU还是直接换整机,算一笔账
很多人在纠结“一个CPU坏了,服务器还能用吗”这个问题时,真正想问的是:修值得吗?
先确定你的CPU型号和平台价值
找到故障服务器的型号和CPU型号,去查一下这个CPU当前的二手行情,这里给你一个粗略判断标准:
- 如果CPU是10代酷睿之前的至强E5 V4、V3系列,单颗二手价格在几百元区间,且整机服役时间超过5年,更换CPU的价值需要打个问号
- 如果CPU是至强金牌/银牌二代、三代系列,单颗替换成本较高,而整机仍然在主流性能区间,更换CPU是划算的
- 如果服务器本身就是老旧平台,比如DDR3时代的产品,换CPU不如考虑整机升级,性能提升幅度会很大
服务器CPU更换价格大概多少
这里不给你报价明细,因为价格波动太大,但可以给你一个参考坐标:一颗主流的至强银牌4314,2026年市场拆机价通常在2000-4000元区间
,二手至强金牌6248R这类则更贵一些,加上人工费,整个维修成本可能在CPU价格基础上浮动几百到上千元。
对比一下“修”和“换”的账
| 对比项 | 更换故障CPU | 整机升级 |
|---|---|---|
| 初始成本 | 较低(单颗CPU+人工) | 较高(新平台整机) |
| 停机时间 | 1-2小时(含测试) | 数小时到数天(迁移数据) |
| 性能提升 | 无(恢复原有水平) | 明显(跨代升级) |
| 后续风险 | 旧平台其他部件老化 | 全新质保 |
| 适用场景 | 业务不能长时间中断、平台配置够用 | 业务可计划性迁移、有扩容需求 |
如果业务系统对算力要求已经逼近这台服务器双CPU状态下的上限,与其花几千块换一颗旧CPU让服务器继续跑在性能边缘,不如把预算用在整机迭代上,反过来,如果业务负载很轻,双路纯属冗余或者高配低用,那换一颗CPU把状态恢复完整,是最务实的路。
更换CPU和内存插槽位置的操作清单
确定要换之后,实操步骤很关键,换CPU不像换内存那样傻瓜式,装歪一颗CPU导致主板烧毁的案例每年都有。
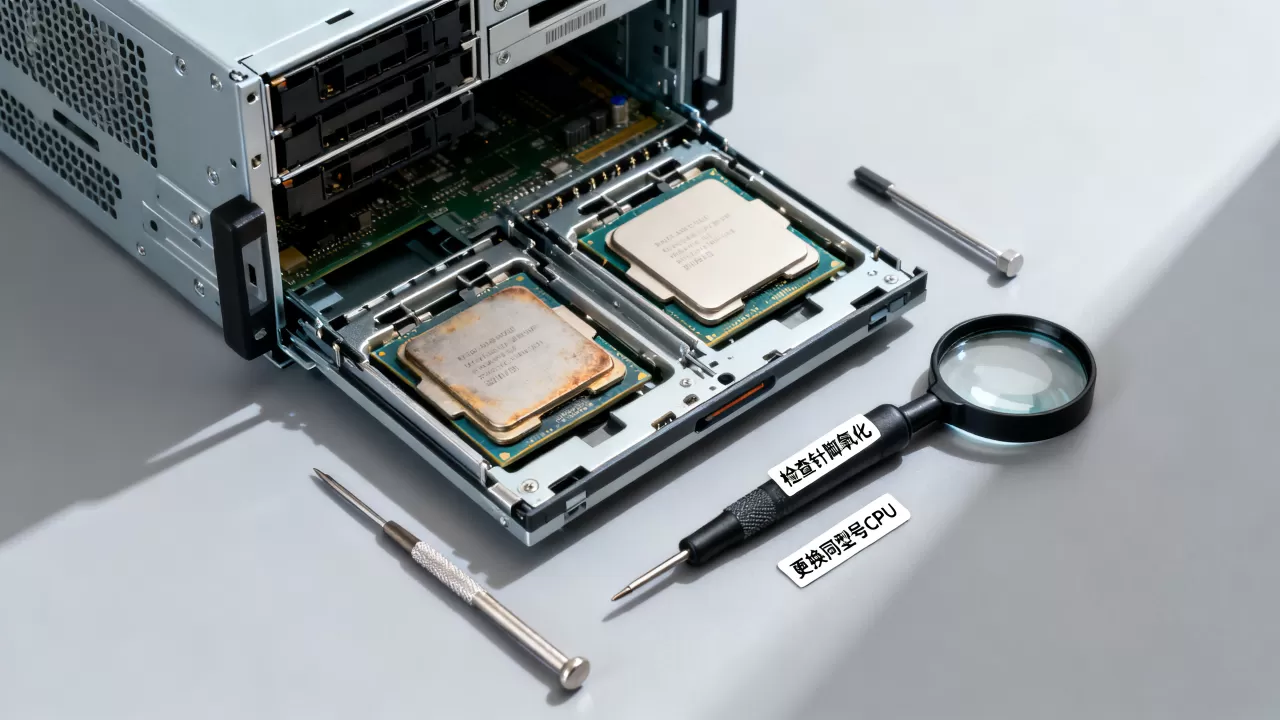
拆机和硬件操作要点
- 拔掉所有电源线,按几次开机键放掉主板余电
- 拆下散热器时,先对角松动螺丝,不要单边用力
- 用无水酒精或无纺布清理CPU表面和散热器底座的旧硅脂
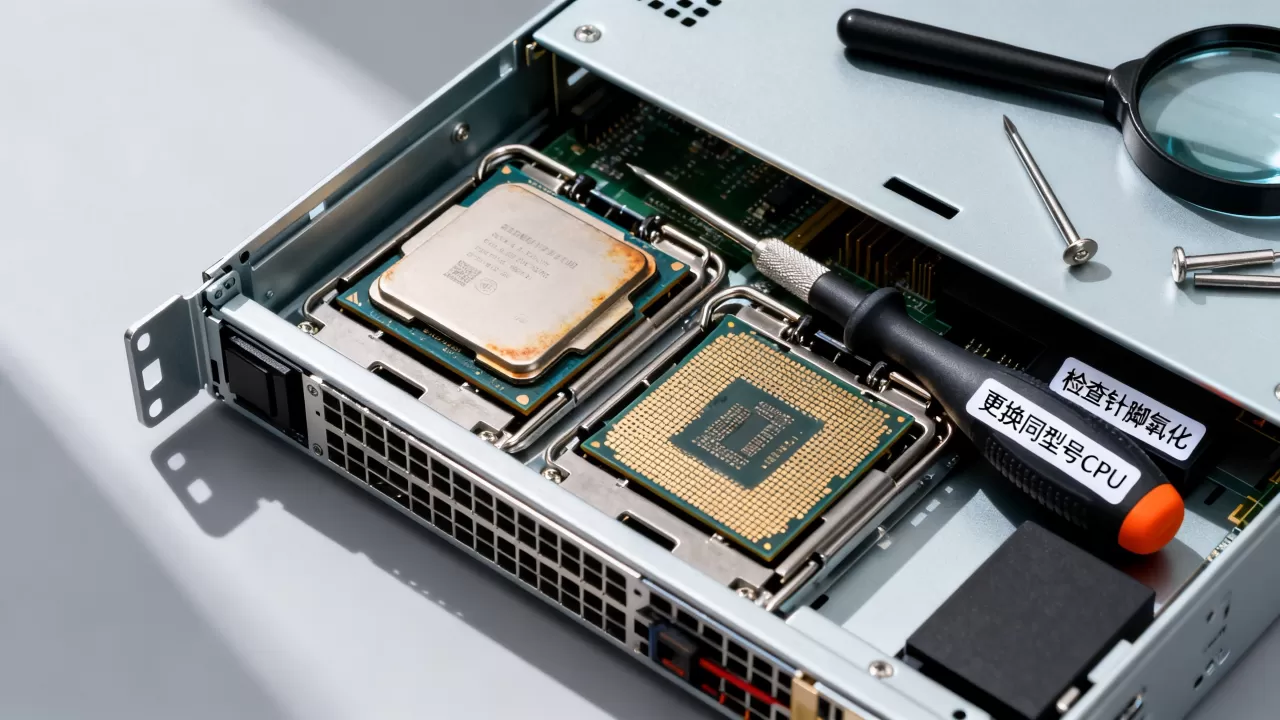
- 打开CPU固定压杆,取出故障CPU
- 检查主板CPU插座针脚是否有弯曲,用放大镜或者手机微距镜头看一遍
- 放入新CPU时,认准两个角位的三角形标识,轻放不要按压
- 扣上压杆,涂抹适量硅脂,薄而均匀,不要涂厚
- 装回散热器,螺丝对角均匀拧紧,不要一次拧死
内存条位置要跟着CPU走
坏了的那颗CPU对应的内存插槽,换好CPU后一定要把原来插在那里的内存条插回去,很多人换完CPU开机报内存错误,就是因为内存还留在另一颗CPU的通道上,导致内存通道配置不对称。
开机验证步骤
- 进入BIOS或UEFI,查看处理器信息,确认两颗CPU都被识别
- 查看内存总量,确认恢复满配
- 进入系统,用
lscpu确认CPU数量和核数 - 运行压力测试,比如
stress-ng --cpu 0 --timeout 60或者Windows下的AIDA64稳定性测试,持续15-30分钟 - 观察BMC/IPMI日志,确认没有新的CPU报错
服务器CPU坏了一个还能用吗”的最终回答
物理上能开机,应急撑一两个工作日常没问题;逻辑上不该这么用,因为数据安全性和业务稳定性都存在隐患。一台双路服务器最大的价值是冗余和算力叠加,跑在单CPU状态下,等于主动放弃了这些优势,如果你手头刚好有备用CPU,那就别拖,直接换;如果暂时没有,可以先降载运行,同时尽快采购备件,有一点要说明,很多服务器保修条款里,自行拆卸CPU会导致整机保修失效,尤其是品牌机在保期间,优先联系官方售后处理,而不是自己动手。
相关问题解答
双CPU服务器突然关机开不了机,是CPU坏了吗?
不一定,双路服务器点不亮,优先级排查顺序是:电源模块、主板供电、内存条、CPU,CPU是故障率最低的组件之一,先看BMC日志有没有AC断电事件,再最小化启动(只保留一颗CPU+一条内存)测试,很多人最终发现是电源老化输出电压不稳,跟CPU没有关系。
换下来的坏CPU还能修吗?
CPU封装内部电路损坏或物理击穿后,普通维修手段无法修复,因为这属于半导体级别的失效,只有极少数情况是PCB板上的电容或电阻焊接问题,可以用热风枪尝试维修,但成功率不高,原因是CPU基板走线密集且焊点极其微小,维修成本远超过直接买一颗二手CPU。
新旧CPU混用需要注意什么?
必须保证两颗CPU的步进版本一致或向后兼容,同样型号但不同步进的CPU(比如早期步进和后期步进),微码版本存在差异,轻则性能异常,重则系统无法识别第二颗CPU,建议在购买时直接询问卖家步进版本,到手后对比一下CPU表面的编号批次,如果混插后系统报“CPUID mismatch”之类的错误,大概率就是步进不一致的问题,需要更换匹配的CPU。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/684009.html