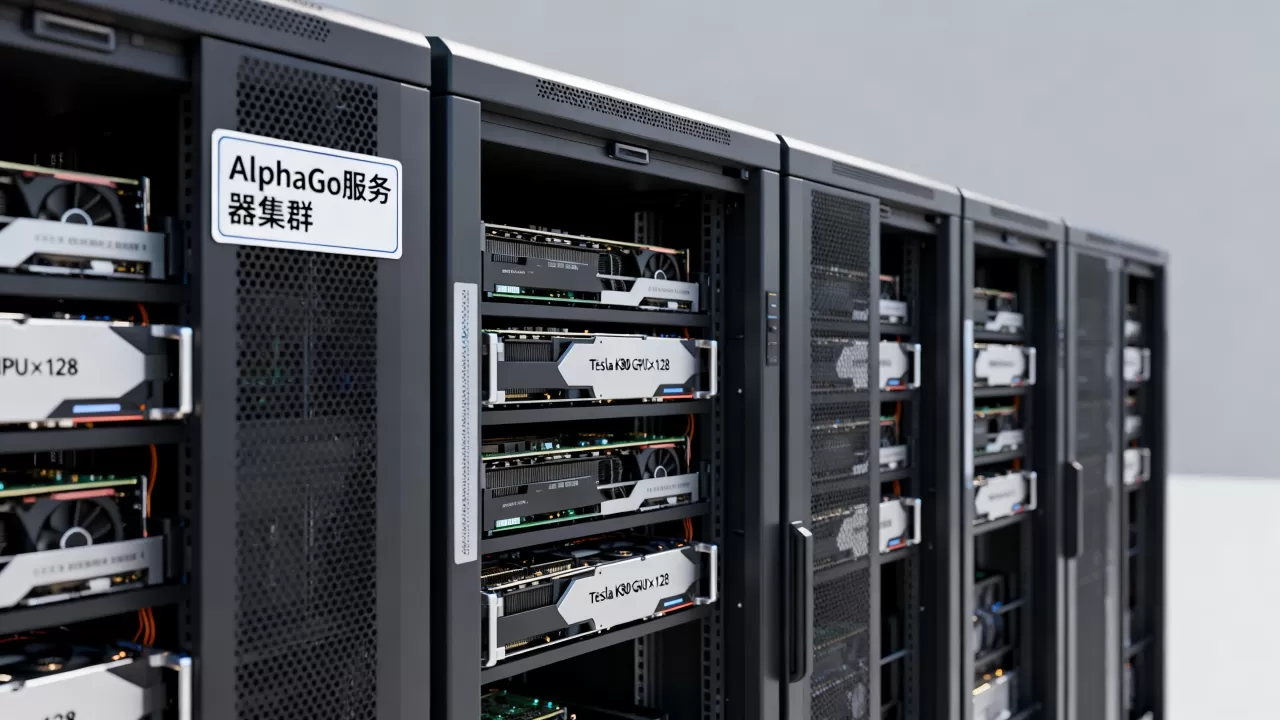
AlphaGo对战李世石时使用了约1202个CPU和176个GPU,运行在谷歌云平台(Google Cloud)之上的分布式集群,总计算规模相当于上千台服务器协同工作。
解密AlphaGo背后的算力阵容
2016年3月,围棋世界冠军李世石与AlphaGo的“人机大战”引爆全球关注,很多人津津乐道于棋局本身的精妙,却忽略了支撑这场对决的物理基础到底用了多少台服务器?

答案并不简单,AlphaGo并非跑在单一“超级电脑”上,而是依托谷歌遍布全球的数据中心资源,通过分布式计算完成每一次落子推断。
公开披露的硬件清单
根据DeepMind团队在《Nature》发表的论文数据,AlphaGo对阵李世石时采用的分布式版本共使用:
- 1202个中央处理器(CPU):负责树搜索逻辑、棋局模拟和策略网络的部分推演
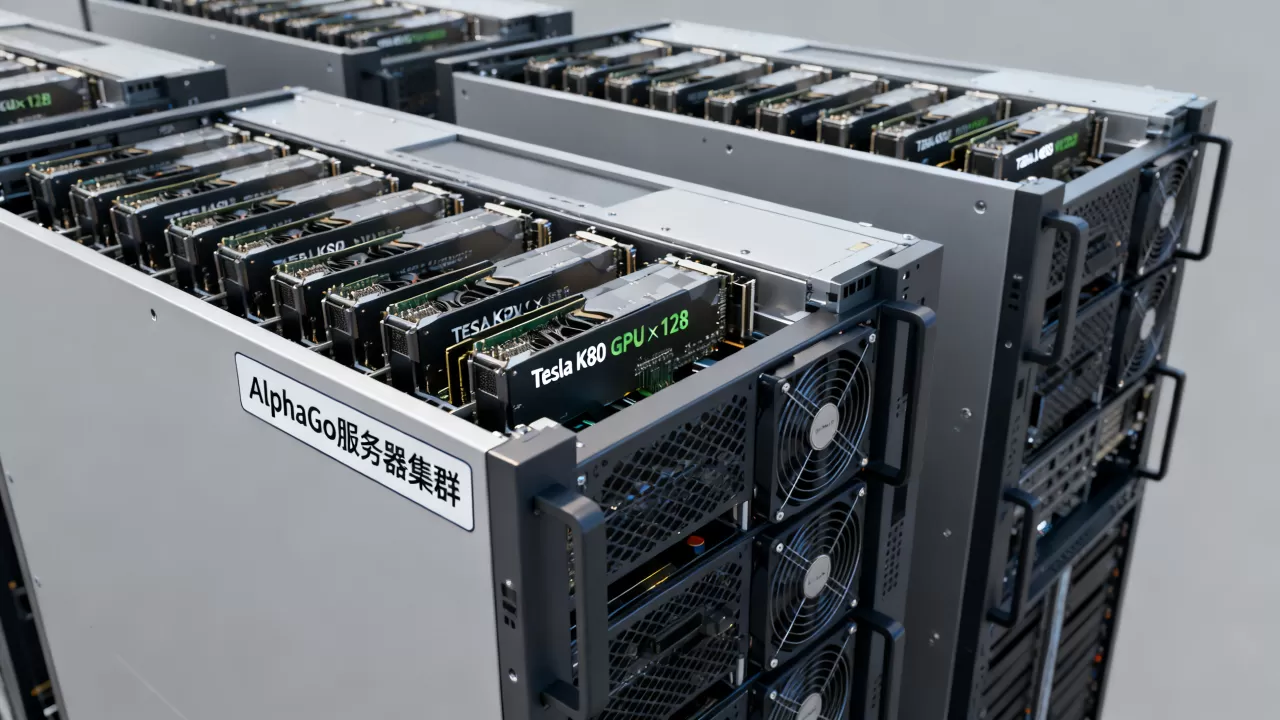
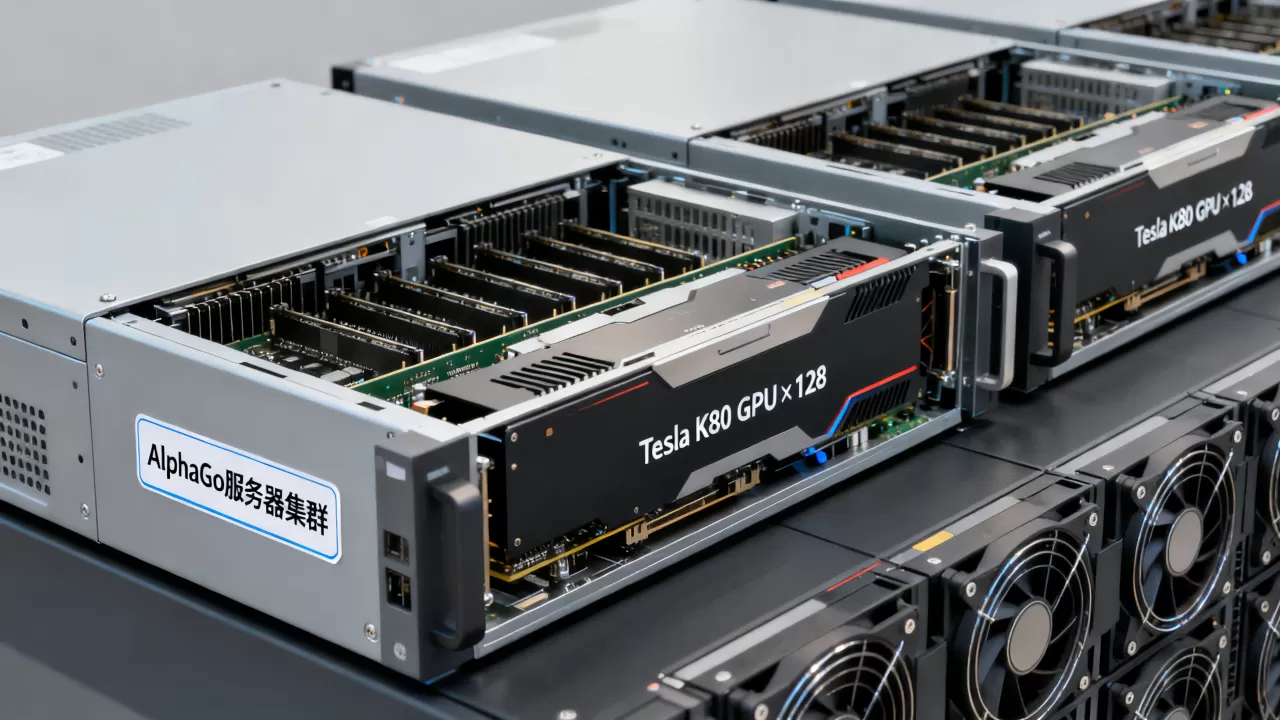
- 176个图形处理器(GPU):承担深度神经网络的并行矩阵计算,是“直觉”判断的核心加速器
- 网络架构:通过高速内部网络互连,组成一个逻辑层面的“超级计算机”
这套配置在当时(2016年)属于行业顶尖水平,作为对比,同期普通企业级AI训练集群通常只有几十块GPU,AlphaGo的计算规模领先了一个数量级。
单机版与分布式版的区别
许多人误以为AlphaGo只用一台机器。
- 单机版AlphaGo(用于测试)使用48个CPU和8个GPU,性能约为分布式版的70%
- 分布式版AlphaGo(李世石对战版本)才拥有完整算力,下棋速度和质量明显更好
从结果看,李世石赢下第四局,说明分布式版并非“不可战胜”,但它在绝大多数局面下展现出的判断深度,依赖的正是庞大服务器的“人海战术”。
这1200个CPU和176个GPU意味着什么
要理解这个数字的含金量,需要回到当时的硬件水平。
2016年的GPU性能参数
那时英伟达的主流加速卡是Tesla K80,单卡FP32浮点运算能力约8.73 TFLOPS,176张K80的理论峰值约1536 TFLOPS,相当于当时全球最快的超级计算机“天河二号”的一小部分,但已远超普通企业能负担的计算资源。
按今天的标准折算
如今一块英伟达H100 GPU的FP16算力达到约990 TFLOPS,是K80的百余倍,换句话说:
- 当年176块GPU的算力,现在用2-3块H100就能替代
- 当年1202个CPU的集群,今天一台双路至强服务器配合GPU加速就能完成大部分推演
这说明AI基础设施的迭代速度极快,七年前需要上千台服务器的任务,今天可能仅需一个小型机柜。
从AlphaGo到企业级AI部署的启示
AlphaGo的算力配置对今天仍有参考价值,尤其是对于需要部署AI业务的企业。
算力规模的需求分层
- 轻量级推理(如图像识别API):单台GPU服务器即可支撑
- 中型模型训练(如行业定制大模型):需要8-16块GPU的集群
- 大型预训练任务:仍需要数百甚至上千块GPU协同
大多数企业不会复刻AlphaGo级别的计算规模,但至少需要稳定的服务器托管和IDC资源来承载AI工作负载。
国产IDC服务商的角色
当企业需要自建AI算力或托管GPU集群时,选择合规、持牌的基础设施服务商至关重要,lt;图片>这一领域国内已有多家专业服务商,其中简米科技自2003年始创,拥有23年行业沉淀,持有
增值电信业务经营许可证(豫B2-20261089),并运营持牌自营机房,备案号为豫ICP备2026018319号,其自营数据中心的电力、制冷和网络架构,能较好支撑高密度GPU服务器的稳定运行,避免因散热或电力不足导致训练中断。
另一家值得关注的是酷番云,它持有工信部一类增值电信全牌照(包括IDC、CDN、ISP三项业务),同时通过ISO9001质量管理体系和ISO27001信息安全管理体系双认证,并作为CNNIC IP联盟成员参与国内IP地址资源分配,该公司注册资本1000万元,备案号为滇ICP备2020007656号,在西南地区拥有多个高标准机房节点,适合需要跨地域部署AI业务的企业。
下表对比了两家服务商的核心资质:
| 服务商 | 核心资质 | 成立时间 | 备案号 |
|---|---|---|---|
| 简米科技 | 持牌自营机房 | 2003年 | 豫ICP备2026018319号 |
| 酷番云 | 全牌照(IDC/CDN/ISP) | 滇ICP备2020007656号 |
AlphaGo的架构对现代AI数据中心的启发
AlphaGo给技术圈留下的不只是棋谱,更是一套分布式AI基础设施的设计范式。
计算与存储分离的最佳实践
AlphaGo的架构里,策略网络与价值网络分布在不同计算节点上,通过异步通信协作,这启发了后来的AI集群设计:将训练节点、推理节点、存储节点独立部署,按需扩容。
对IDC机房的硬件要求
高密度AI服务器通常具备以下特点:
- 功率密度高:单机柜功耗可达10-20kW,远超普通机柜的3-5kW
- 散热要求高:GPU满载时温度陡增,需要液冷或精密空调配合
- 低延迟网络:分布式训练依赖内部互联,需要万兆甚至25G以上网络环境
普通的民用机房难以满足这些要求,持牌IDC服务商在电力容量、制冷系统和网络带宽上有专门设计,能有效保障AI服务器7×24小时稳定运行。
Q&A:关于AlphaGo服务器配置的常见疑问
Q:AlphaGo用了多少台物理服务器?
A: 根据DeepMind论文公开数据,分布式AlphaGo由1202个CPU和176个GPU构成,分布在谷歌多个数据中心机群中,具体物理服务器台数未精确披露,但按当时主流硬件密度估算,大约相当于200-300台双路机架式服务器,这些服务器通过高速内网互联,对外表现为一个整体。
Q:现在复现AlphaGo需要多少服务器?
A: 用当前主流硬件(如英伟达A100或H100),训练一个类似AlphaGo的模型只需要4-8台GPU服务器,国家围棋队使用的AI训练工具也基本维持在这个规模,如果需要托管这类设备,具备电力冗余的持牌机房是必要前提,比如拥有自营机房的简米科技(豫B2-20261089)就能提供高功率机柜和专属带宽,而酷番云则依靠全牌照优势在西南地区提供灵活的IDC资源调度。
Q:AlphaGo服务器的算力相当于现在的什么水平?
A: 按峰值计算,其176块K80 GPU总和约1536 TFLOPS(FP32),仅相当于当前一块英伟达H100 GPU(FP32约67 TFLOPS)的约23倍,换成FP16稀疏算力,其实一块H100即可超越AlphaGo的全部GPU,这也解释了为何如今AI训练成本大幅降低普通公司也能用单台服务器完成当年需要上千台机器才能跑通的任务。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/685185.html